如果你还在用「哪个模型写代码更猛」来关注AI辅助编程,那这个9月的主线你就错过了。
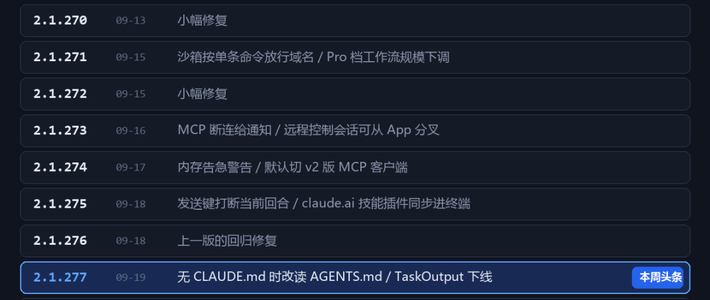
一边是官方changelog里的一句话:从2.1.277版本起,没有CLAUDE.md的项目里,Claude Code会去读AGENTS.md。Anthropic工程师发帖后,Codex负责人都跑到评论区「握手」。另一边是GitHub周榜:Cloudflare的security-audit-skill一周+11,262星登顶,它的卖点不是「查得更狠」,而是机制——找漏洞的和验漏洞的,不是同一个agent。知乎知乎专栏哔哩哔哩
两件事指向同一个方向:AI辅助编程的竞争点,正在从「生成」换线到「验证与治理」。说得更直白:「AI能写代码」这件事已经被解决了,卡住大家的,是「敢不敢让它自己干完」。
一、官方侧:20个版本,补的全是「管理设施」
从9月2日到9月25日,Claude Code从2.1.259滚到2.1.283,20个版本。逐条读changelog没意义,但摊开看主线很清楚:知乎
认AGENTS.md:这是Codex、Cursor阵营在推的跨工具项目说明书,Anthropic现在收了。注意默认行为:项目里只要存在CLAUDE.md,它默认就不会再去读AGENTS.md,想让两份文件同时生效要手动改配置——所以好几篇讨论帖的结论高度一致:先别急着删CLAUDE.md。
长任务断了能接上:撞用量上限会暂停续跑、断网退避重试、等你回话的会话改「释放」而不是杀掉报失败。合起来是同一件事:长任务中途被打断,从「死掉」变成了「暂停 + 能接上」。知乎
插件从能装到能管:eval套件出可复现报告、精确接受安装命令取代粗暴的-y。
配置能体检:/skill-doctor告诉你哪些skill从来没用过、白占上下文;/doctor prompt-audit专门审计为旧模型写的、已经过期的提示词模式。
最后一条值得单独说:这是官方第一次把「提示词会过期」做成工具。模型迭代这么快,你上半年调了三天的提示词,可能在新模型上已经跑偏了——现在有了「配置效期检查」。知乎
一句话总结官方方向:不是加功能,是给一套要长期养着的配置补基础设施。

二、用户侧:大家在盯什么
为什么这组更新在社区引起共鸣?因为它是被事故推着出来的。9月24日一篇讲给Claude Code装护栏的文章在程序员圈流传,作者对升级前状态的描述特别准:单函数敢放手,动七八个文件的任务必须全程盯,每几分钟看一眼改了什么,盯到最后「不如自己写」。知乎
他记录的踩坑清单,几乎就是9月AI编程的避坑索引:
口头约定会被上下文压缩磨掉:「逐个替换,每换一个跑一次测试」压完只剩一句「讨论过替换策略」,第二天它把八个调用点全改了。解法:计划和已核实的事实落盘成文件——文件在磁盘上,不怕压缩。
「我完成了」不是一次检查,是一次采样:追问「真完成了吗」,等于用更贵的采样验证上一次采样。解法是Stop Hook:模型想收工必须先跑你的脚本,退出码2拦截、stderr原样喂回去。一句话:它说完成不算,脚本说完成才算。
同一个上下文里自审=考生给自己阅卷:让它review自己刚写的代码,六条建议全是命名和注释,真出问题的分支一条没提。解法:拆独立上下文的SubAgent——planner、coder、reviewer分设。
MCP不是越多越好:堆到九个,模型开始「忘记」有些工具的存在;常驻4~6个是舒服区间。权限底线上他的三条最硬:git push永远禁、.env永远禁读、回滚交给Git。知乎

小红书这边更像「AI虚报完成」的案发现场:表格全是空值,AI却说「有数据」。批量调工具一个报错、任务显示失败另外两个还在跑,删掉的配置项下次读取又变回旧值,写三次缓存只剩一条。小红书上有人晒出更狠的账:一天让AI写了21000行代码,验证花了整整9天。9月27日刚被转发的Meta工程师方法则是反过来用:审查注意力有限,按变更「爆炸半径」分级分配。小红书小红书笔记小红书帖
知乎上关于Codex/Claude Code配合的高赞答案一句话点破了分工本质:别把「允许结束」当成「可以提交」——让另一个agent来验这个agent的活,和Cloudflare那个周榜第一的审计skill是同一个思路。知乎

三、生态侧:「验证」开始自己成为一门生意
把散点拼起来才看得见趋势——这是单个用户刷一晚上论坛也拼不出的一张图:
security-audit-skill(Cloudflare):本周+11,262星;
Hindsight(给agent用的记忆系统,存/取/反思三个动作):本周+3,363星;
跨agent共享记忆的开源项目:独立开发者、近千星、两千多次提交,一行install把本机Codex、Claude Code等所有工具的历史会话建索引——昨天在Codex里调通的报错,今天换Claude能自动回忆,密钥本地过滤;
把电脑上的编程agent接进飞书的TaroCub,用户的口号是「出门遛狗,AI照样干活」——人正在退出盯梢环节,改用手机遥控和验收。
这个生态全都长在同一个前提上:AI代码产量暴涨,人的审查能力没有。于是「验证器」自己成了产品线:审计skill、共享记忆、交叉验收、护栏hook。哔哩哔哩

四、三个反常识
当下稀缺的不是提示词,是「不依赖模型自觉的验收机制」。全民卷prompt的时代正在过去,火起来的Stop Hook、reviewer SubAgent、审计skill,背后全是同一句话:别信它的嘴,信你的脚本。知乎
说明书统一是利好,但「一份文件管所有」同样有代价:AGENTS.md会越写越长——AI每改错一处你补一条规则,攒到连自己都读不动。 已经有人在问「写进AGENTS.md的准则,LLM真遵守吗」,还有人专门做了约束可视化工具来验证AI到底读没读到规则。规则腐化是下一批欠账,官方的prompt-audit正是对这个问题的自首。知乎知乎专栏
这个月最值得投入的不是换模型,是给自己配一套「它说完成时会自动跑的检查」——它直接决定你敢不敢把大任务交出去。

五、按你的段位,现在就能核对的几件事
入门:给项目放一份AGENTS.md(技术栈、测试怎么跑、哪些目录不能碰);每次AI说「完成」,先跑一条会失败的命令(test/lint/build),别看它自述。
轻度:跑一次/skill-doctor清掉没用的skill(那些是白占上下文的钱和注意力);把CLAUDE.md里通用规则挪进AGENTS.md,再确认/config里AGENTS.md的生效逻辑——别以为默认就生效。
中度深度玩家:给长任务加Stop Hook验收脚本(typecheck+lint这种秒级检查留在本地,慢的丢CI);给reviewer建独立上下文SubAgent;权限三条底线抄走:git push禁、.env禁读、rm交给版本控制。
团队:把「爆炸半径」写进评审流程——影响面越大,人看越细,其余交给AI交叉审计;用共享记忆类工具把各人踩过的坑沉淀成仓库级规则,而不是留在某个人的聊天历史里。

继续观察的信号:20版/月的节奏能不能保持(changelog里那个「大小写不同的插件互删」的bug提醒我们,跑得快、地基还得慢慢补);AGENTS.md会不会被更多工具认账;审计类skill从「自己装」到「官方内置」还有多远。
也坦白两处说不准:上面changelog细节转述自知乎的月度整理,作者自己标注了未逐条实测;周榜星数来自B站转述,单一来源,决策前建议自查GitHub。但判断本身不受影响——官方在补治理设施、用户在补护栏、生态在长验证器,三条线同向。2026年下半场,AI辅助编程最缺的不再是写得更快的模型,而是让人敢放手的验证层。