这一年,本地AI党都在卷同一件事:往电脑里塞"脑子"。125B塞进台式机、集群搬进客厅,等热度过去才发现——脑子够用了,嘴还没有:一边是本地27B聊得飞快,一边是回话还得等云端TTS慢悠悠打欠条。于是语音模型在10月悄悄开了个小会。
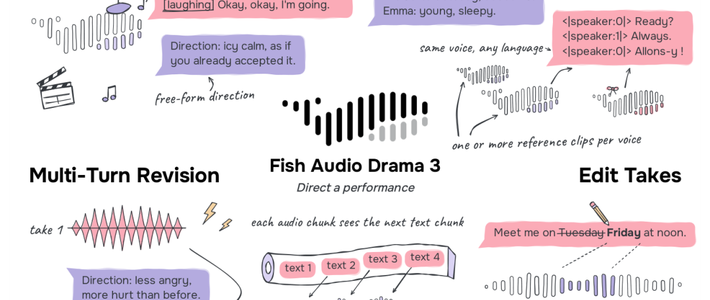
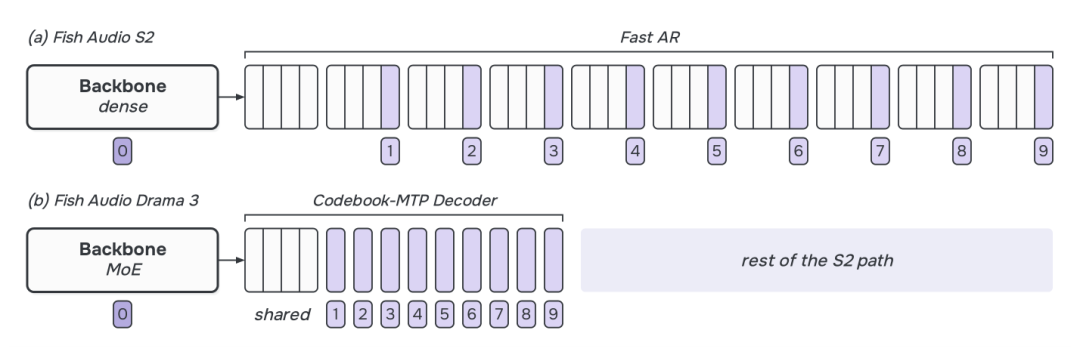
先看硬件这边的上新有多密:10-13 Fish Audio发布 Drama3,35B MoE架构直接"导演"整集多角色配音。好消息是8G显存就能跑,坏消息是内存至少48G。10-24,新ASR模型 Bakr3.0 也已经被up主搬上本地实测。知乎哔哩哔哩哔哩哔哩
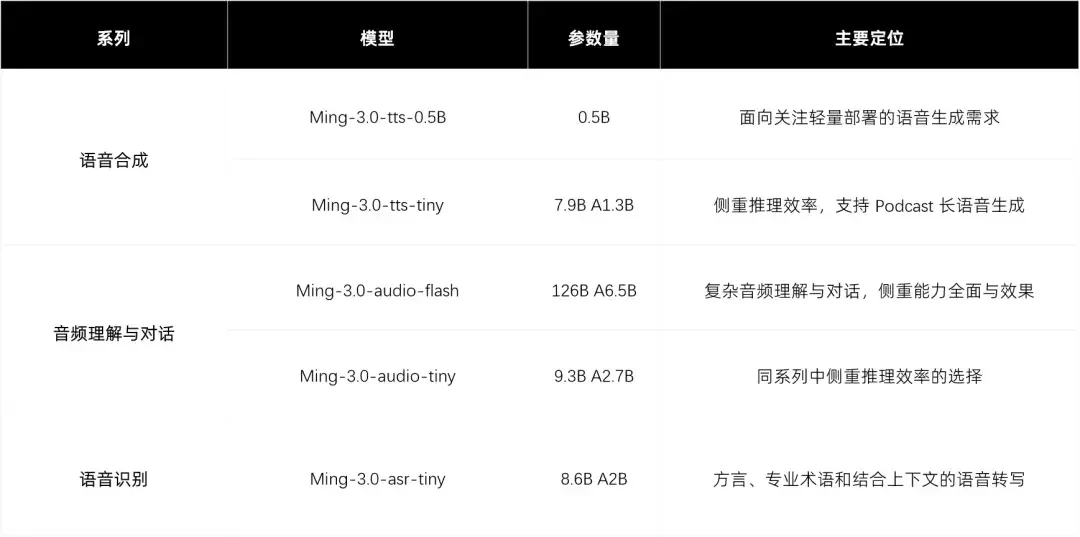
开源阵营和产品阵营同样热闹:10-21 Mistral开源 Voxtral 3 并带上实时智能体SDK。蚂蚁把 Ming-3.0 的5款语音模型全部开源,合成、理解、识别三个系列能在本地组合着搭语音Agent。10-23 xAI也发了 Grok Voice 3.0 来凑热闹。连桌宠都下场了:PalAILab开源桌宠 Coopanion 把零延迟本地语音做了进去,评论区说得直白——“说一句等半天那种憋屈总算治好了”。哔哩哔哩知乎知乎知乎哔哩哔哩
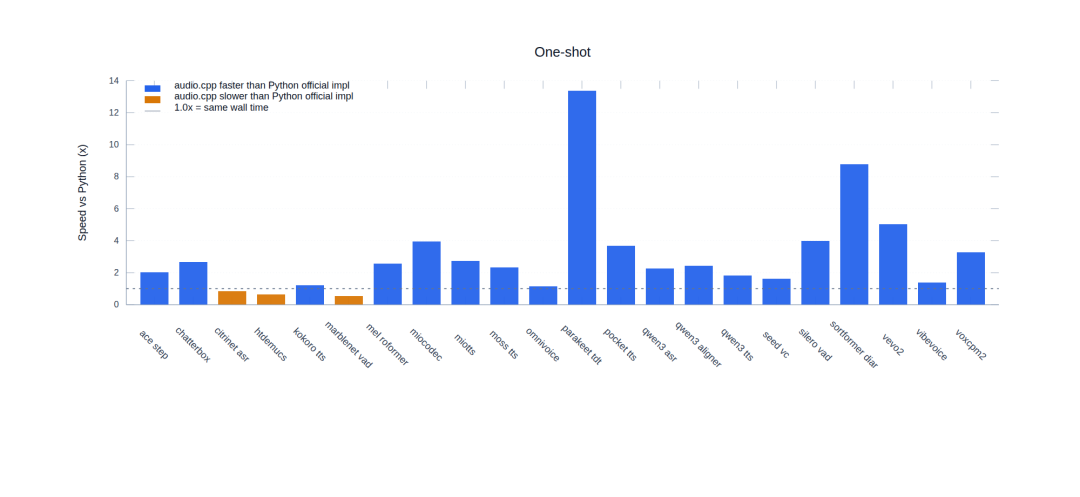
门槛这边,直接从"125B俱乐部"跌进"你家旧卡"区间:统一底座 audio.cpp 把TTS、ASR、音乐生成和声音转换接进同一个C++后台,8G显存跑通大部分功能、没独显还能切CPU慢慢跑,社区干脆叫它"音频版llama.cpp"。Qwen3-TTS.CPP 只要3G显存,还不用装Python。VoiceStudio 一周从1.5万星冲到5.2万星。8秒录音就能免费克隆自己的声音,纯离线、音频不出家门。那边你还在给文本模型算显存配比,这边3G旧卡已经能唱歌了。哔哩哔哩小红书哔哩哔哩小红书小红书
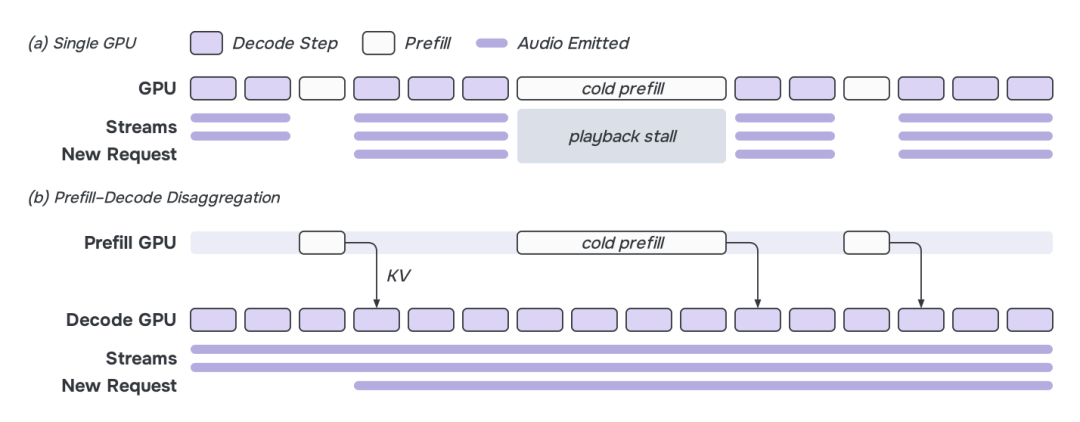
但先别急着掏钱,有两笔账得算清。延迟账:LiveKit公开的实时语音延迟预算是1.5秒可用、600毫秒才有"人味"。误打断率从9.9%压到4.5%、工具调用自然"买时间",靠的是整套工程——云端磨平的东西,本地不一定免费送。桌宠评论区的另一面,是8赞的直球提醒:“宁可它少换两套衣服,把本地TTS做扎实”,入门硬件的体验落差真实存在。架构账:做任务型对话的实践者给的意见是,端到端听着先进,但落地主流仍是级联(ASR→LLM→TTS),中间留文本层兜底校验。哔哩哔哩哔哩哔哩知乎
评论区还剧透了大家真正要什么:一位UP的本地语音工作台覆盖音色克隆、多人对话、语音设计、语音识别4大功能。这个工作台21条评论里,17条在求整合包;IndexTTS2.5的一键整合包评论1335、收藏2818。看出来了吧,大家要的不是原理,是开箱能跑的成品。玩法也卷出了新高度:开源项目 ohwhale-d 把语音智能体接进了QQ,能给自己家AI打语音视频电话。哔哩哔哩哔哩哔哩哔哩哔哩
双11前的提醒就两条:已经在跑本地文本模型的,你的卡大概率够把语音层玩起来,3-8G显存是当下主流入门位,"内存48G"这种暗坑记得单独留预算;以及所有工具都划的同一条线——克隆声音要本人授权的参考音频,克隆自己的是功能,克隆别人家的是官司。家里AI的脑子长了一年,这次长嘴,真不用加价上顶配。