去年做企业 Agent 的人见面都问"你拆了几个子智能体",十月风向变了——Anthropic 应用 AI 团队发布工程实践文章《Building agents: When to fold subagents into your main agent loop》,主题就一句话:把你的子智能体折回主循环。10 月 26 日的知乎几乎被这事刷屏:官方指南中译、Codex 多智能体源码拆解、“Agent 时代 AI Infra 怎么做”、"企业级 Agent 用什么框架"在同一天集中出现。这篇值得开发者认真读完,因为它给"要不要上多智能体"这个问题画出了可操作的判断线。
指南的核心主张:单循环常赢,还便宜
中译版把 Anthropic 的结论压缩得很直接:“具备多技能的单智能体方案,在输出质量上往往优于『万能单提示词』方案与多子智能体方案,多数场景下还能够降低单任务成本、减少响应延迟”。知乎
更反直觉的是工具规模。很多人下意识觉得 Agent 能力=工具数量,指南给的经验值是:“一套清晰的系统提示词配上 4-5 个轻量化数据工具,再加上严格的输出防护规则,就能够覆盖绝大多数业务场景”。知乎
而"系统提示词内的工具定义超过 30-50 个之后,模型选择工具的准确率就会下降"。工具堆到几十上百个不是能力扩展,是精度稀释。
实测案例的代价更具体:某企业面向用户的智能体内部部署了十多个专业子智能体,结果品牌交互体验难以维持、还多出额外延迟;“改造后的单智能体循环运行速度甚至可以达到原有多智能体方案的 2 倍”。知乎
什么时候折叠、什么时候保留
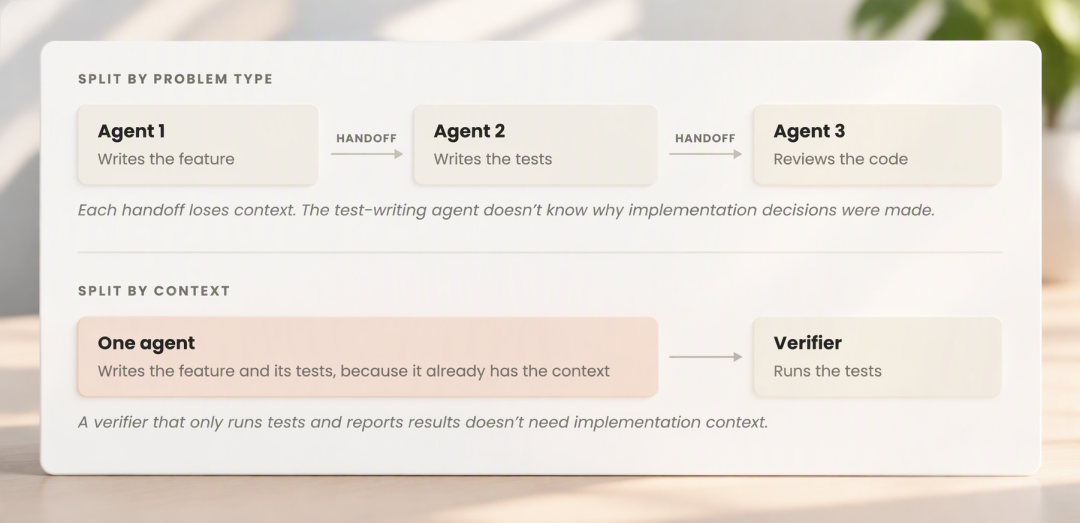
指南给的合并判据很朴素:多个子智能体"存在调用依赖、读写同一批数据、经常被串联调用,就适合合并",优先合并调用频次最高、上下文高度重合的那几个,因为"架构里大部分工作大模型本身就有能力执行"。知乎
反过来,子智能体真正站得住的理由是"独立":拥有独立的上下文窗口、工具集与指令集,典型如独立调研分支、接口清晰的独立组件、黑盒校验复核——并行任务处理、校验复核、模块化权限管控这三类场景适合保留。
两个坑被点名得很狠。一是"康威定律"陷阱:把组织架构复刻成智能体架构,按业务问题类型切割子智能体,就会陷入"传话游戏",“每一次子智能体之间传递数据都会损耗信息保真度”。知乎
二是治理:要警惕的不是技术,是没人统一管控——小型中心团队统一管系统提示词与输出质量,新增工具、评估用例都要过审;“做可量化评估,一次只改动一处,只保留经过验证有效的方案”。知乎
Codex 源码给出的另一半答案:编排交给模型,治理写成代码
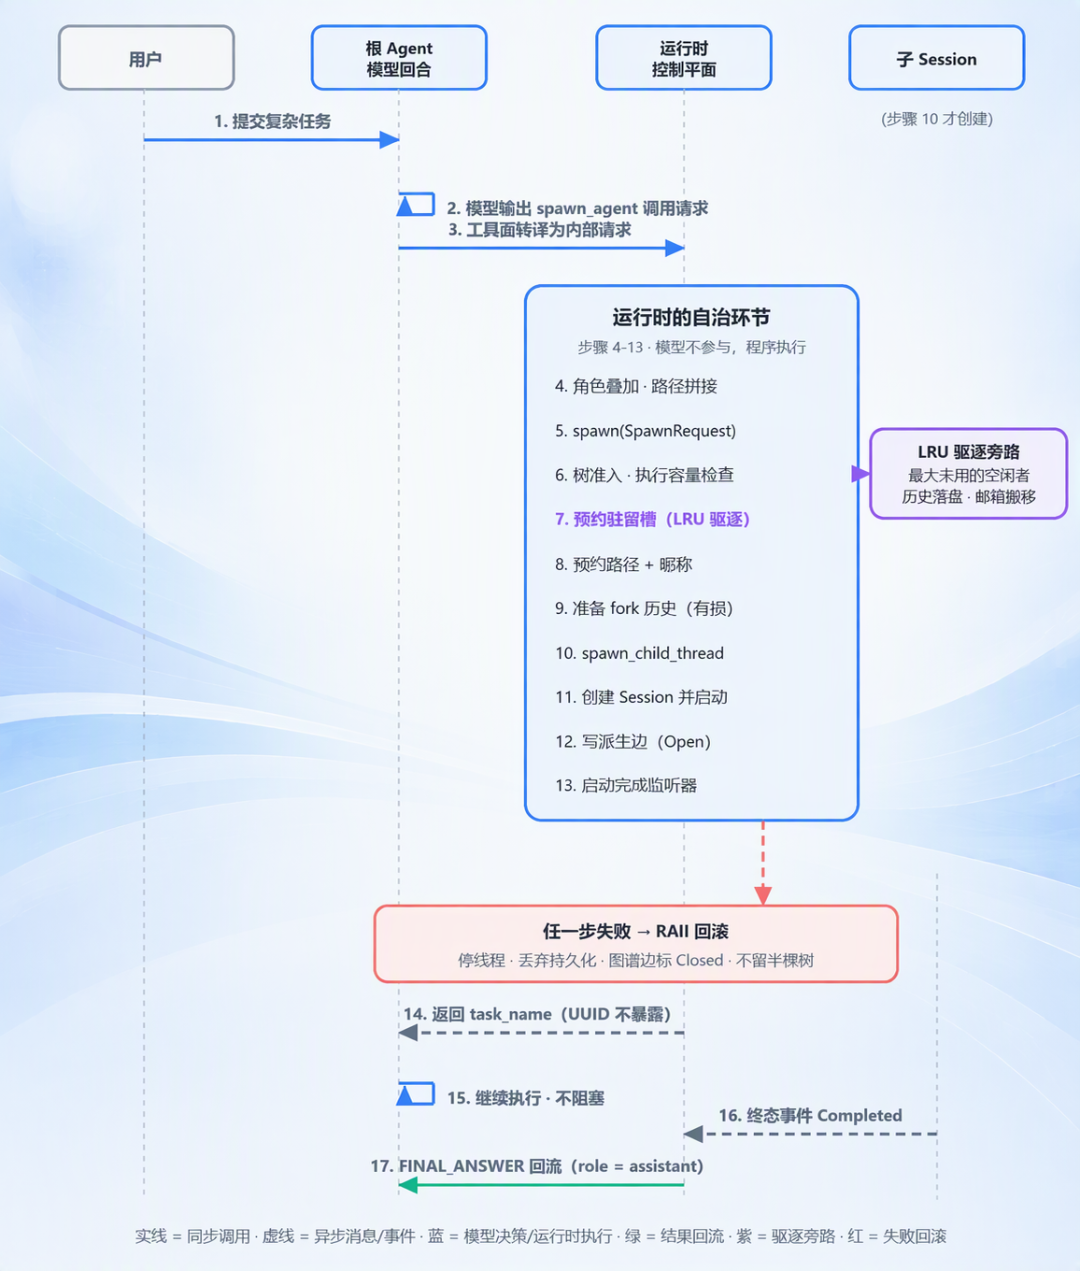
同日发布、基于 codex-rs 真实源码(commit 8c07694)的多智能体机制拆解,恰好是这份指南的工程镜像。作者 Morning 的结论句值得抄进设计文档:“Codex 把多智能体的复杂度从『编排逻辑』转移到了『运行时治理』——编排交给模型,治理写成代码。”
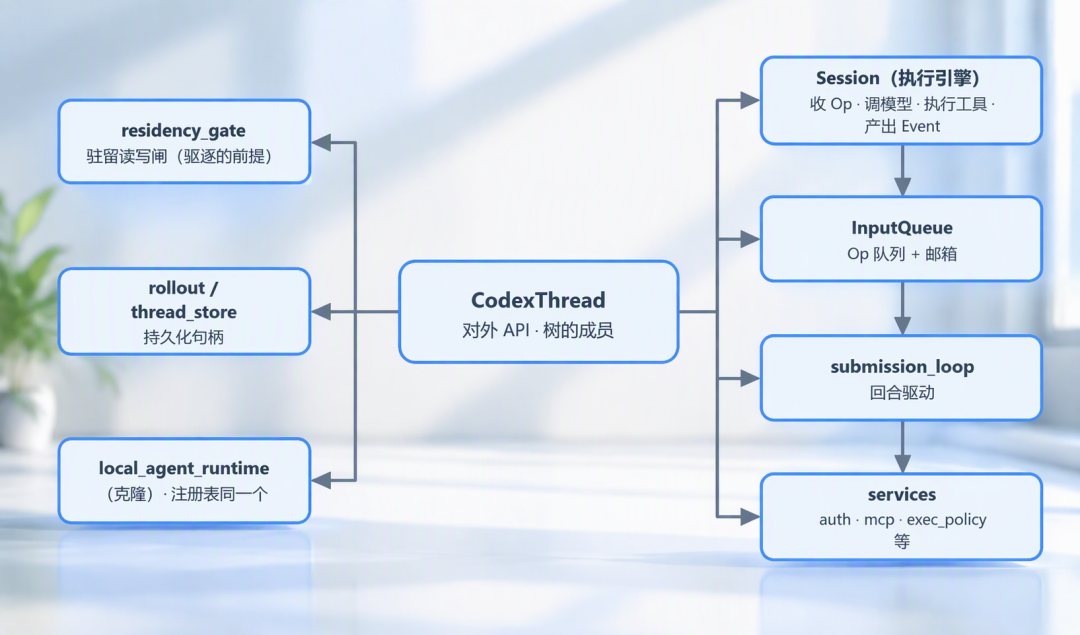
三个设计选择特别有信息量:
准入门槛用模型档位卡:推理强度开到 Ultra 才进入 Proactive(可主动拆分),否则只在用户明确要求时派发任务。 理由很硬:“弱模型拆分出的子任务往往是错的,错误还会沿树形结构放大。”知乎
权限单调收窄:角色 overlay 只能关权限不能开,整棵树的最大权限恒等于根会话——防的就是 prompt injection 提权。
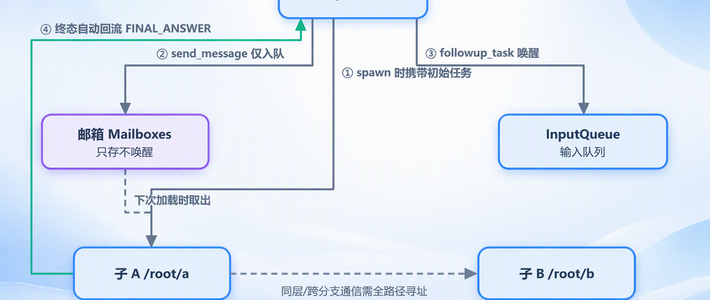
寻址用树形路径不用 UUID:“模型是语言模型,不擅长记 UUID,但非常擅长处理『路径』这种结构化字符串。”
这套机制说明:多智能体不是不能用,而是必须先为"治理"付费。没有容量约束、权限收窄、上下文筛选这三层护栏,拆分就是裸奔。
Infra 侧和安全侧,各泼了一盆冷水
BBuf 当天在"面向 Agent 时代的 AI Infra 到底该怎么做"下写道:coding 类 Agent 请求经常几十上百轮,每一轮都是在前面一大段上下文后面追加一点工具输出,前缀几乎全是重复的。知乎
他引用的 DeepInfer 技术报告数字很扎眼——线上 prefill 的 KV cache 命中率 96%,也就是说只有 4% 的 token 是真的需要算的。 也就是说,Agent 的上下文成本大头在重复前缀,多智能体各自维护上下文的开销会被推理层进一步放大;KV cache 下沉、前缀路由、PD 分离才是 Agent 流量的真实战场。知乎
安全侧的信号更直接:多家华尔街大行紧急封杀第三方 AI 智能体用用户账号"模拟人登录"银行系统。高赞解读把问题讲透了——银行无法确认 Agent 读了什么页面、有没有保存登录态、有没有外发数据,网页内容、客服话术都可能变成提示注入入口;查询可以自动化、交易必须可控,金融系统最怕的就是权限很高、判断又不稳定的数字员工。 这跟 Codex 的"权限单调收窄"是同一个原则的两个方向:会自己行动的中间人,权限必须显式、可审计、可停止。知乎
落地选型上,当天"企业级 Agent 开发用什么框架"话题(两万多次浏览)给出的务实分工是:LangGraph 负责流程管理,LlamaIndex 负责知识检索,Qwen-Agent 负责简单的模型协作,权限、任务队列和日志审计等功能则根据实际需求自己搭建。 该回答并且提醒:"开发工具、Agent 框架、企业运行平台,本来就是三层不同的东西。"企业 Agent 翻车的根因往往不是模型:“很多时候不是模型能力不够,而是各个模块混在一起,分工不清楚。”知乎
你现在该做什么:四步迁移 + 三个自检问题
指南给的迁移路径,门槛低到可以直接开工:哪怕只有 10 条高质量基准样例,也够搭起端到端评估集。 四步走:知乎
先建小规模端到端评估集,必要时叠加各团队专项小评估集;
过渡期把遗留子智能体封装成工具调用——三种处理方式里风险最低的一种;
合并一个跑一次开/关对比,“关注哪些任务的结果发生了变化”,而不是综合分;“如果评估效果变差就继续保留它,循环往复”;
一次只改动一处,只保留经过验证有效的方案。
一个真实教训:一次合并后客服智能体跳过物流确认步骤,故障只在 2 次运行中的 1 次复现,测试必须留够运行次数。知乎
对着今天的架构自检三问:两个子智能体是否在串联调用、读写同一批数据?系统提示词里的工具定义是否超过 30 个?你能否明确说出并行处理、校验复核、权限隔离这三个保留理由至少各有一条?三问全中"是/否"的组合,基本就决定了你是折叠方还是保留方。
值得继续盯的信号:Anthropic 指南配套的引导式迁移工具包已经在社区流转;Codex 文档下一版是否把"折叠"写进默认建议;以及 OpenRouter 上 Agent 类调用的前缀复用率会不会成为推理厂商新的军备指标。
这轮退烧不是否定多智能体,而是把问题从"单还是多"换成"你算清编排成本和治理成本了吗"。拆,要有独立上下文、独立权限、真并行收益三条腿;合,要有评估集、逐步对比、一处一改三条规矩。10 月这波刷屏的真正价值在这:Agent 开发的竞争维度,正在从"会拆"转向"会算"。