最近知乎上有个问题揭了个尴尬的共识:提问的人实测后发现,DeepSeek此前的视觉能力居然不是原生的,还是一个独立的外挂VisionEncoder。他在问题描述里补了一句大实话:"我原本以为所有主流大厂都早就是原生多模态了呢。"这正是当下多模态大模型行业的现状:人人都说"原生",但外挂和原生的差距,比跑分大得多。知乎
"原生"到底指什么?
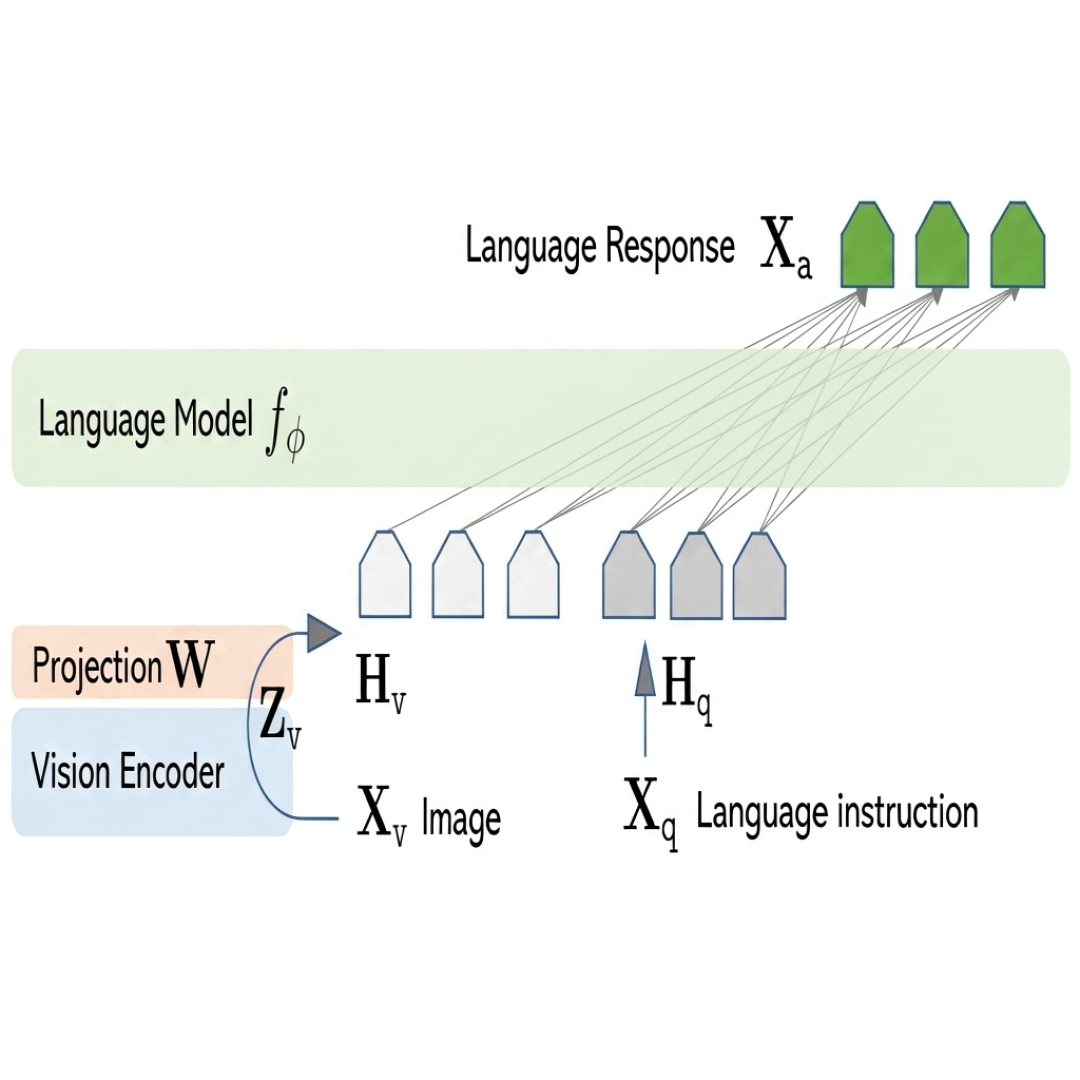
第一代多模态模型的标准做法是"拼接":一个预训练好的ViT,经过投影层,再接入语言模型。这个ViT本质上是翻译官:模型自己不能直接看图,由翻译官先看,再转述给模型。而翻译官只会转述文字能描述的内容,那些说不清道不明的细节,在进入模型之前就已经丢了。这就是为什么很多AI读截图里的字没问题,一到空间关系(杯子在桌子的哪一边)、复杂图表、"画面角落那个小东西"这类模糊指令就开始瞎猜。知乎专栏
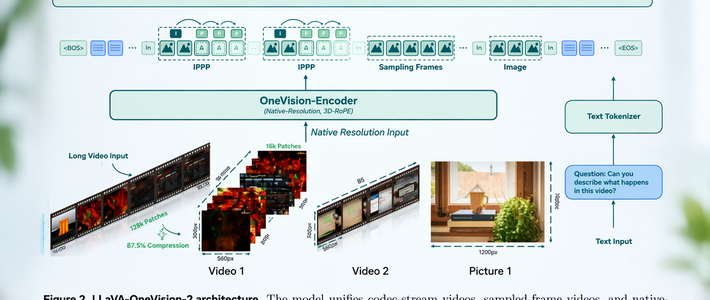
原生的做法正相反:去掉翻译官,原始图像patch直接投影到LLM的嵌入空间,从第一层起就与文本token一起计算。知乎专栏
还有个冷知识:"原生"这俩字其实有两种含义。Qwen3.5的原生指预训练阶段就图文联合训练,但仍保留ViT前端;更激进的原生是把视觉编码器整个去掉——Gemma 4 12B就把550M的ViT换成了35M参数的一次矩阵乘法。标签同一个,含金量可以完全不同。知乎专栏
大厂确实在集体补课
DeepSeek V4.1 Flash是DeepSeek首个原生支持多模态视觉理解的正式版模型,此前单独提供的实验版V4 Flash Vision Exp已经下线。量子位微信公众号
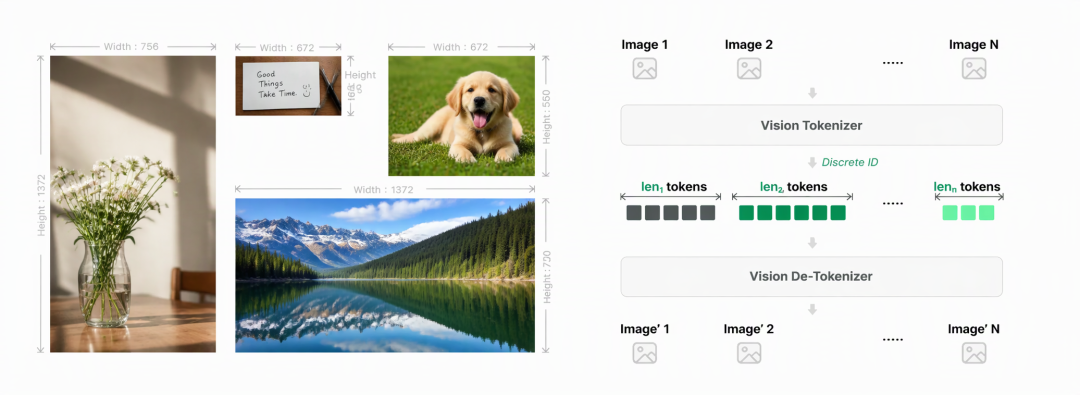
这回放进了什么"实在"的东西?它成为DeepSeek主线模型中第一个在预训练阶段就加入多模态数据的:主干前接一个自研32层ViT、支持任意分辨率,图像特征做3×3合并、token数减到1/9。架构换成全新的非对称Causal-Encoder-Decoder,输入激活只有8B参数、输出激活16B,API价格也同步下调了。微信公众号DeepSeek官方微博
另一边,美团11月初发布了1.6万亿参数的原生多模态模型LongCat-2.5。"原生"标签突然泛滥,反而更要留心。知乎
花钱之前,先问三件事
下次挑"能看图"的AI,别看宣传页,就问三件事:一,图文是不是从预训练阶段就一起练的,还是训好语言模型再补挂一个编码器;二,支持不支持任意分辨率——好的做法是不强行把图片缩放成固定尺寸,而是按原图长宽比切分成多个图像块,细节才保得住。三,多图长上下文有多长,这决定它能不能陪你干完整个项目的图。知乎
至于体验,也别迷信架构:认真读完V4.1论文和实现的开发者坦白,实际用起来"并没有榜单那么好",幻觉偏多。所以最稳的做法:拿你自己最痛的那类图去测一次,这比任何榜单都便宜。微信公众号