本地大模型这笔账:电费8美元、等12天,大部分人漏算3处
前几天B站一条实测视频,成了本地AI圈子的谈资:有人拿一张3090跑Qwen3.8 Flash Next,24小时连轴转,293.5小时烧出2690万token,电费8.07美元。摊下来每百万token约3美分,比多数云端报价还便宜。哔哩哔哩
但评论区有人当场泼冷水:他按云端API价算了个跑两天的项目,账单大几百块,"这省哪了?"问到点子上了。本地的账,吓人的不是电费,是你没算的那些全都没算。
第一漏:时间。 2690万token听着多,摊到全程,平均每秒才生成约26个token。视频作者自己的总结很直白:“钱便宜到不真实,时间贵到不真实”——一件基础的光影增强活,机器连轴跑了12天。他还补了一句扎心的:卡住本地AI的不是成本,是速度。哔哩哔哩
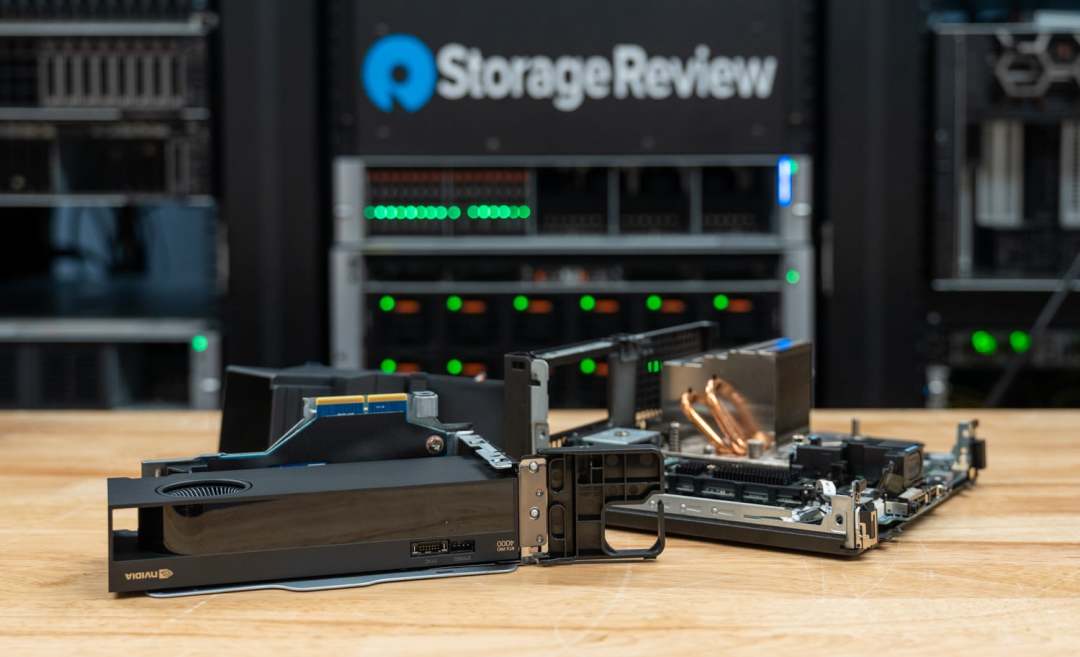
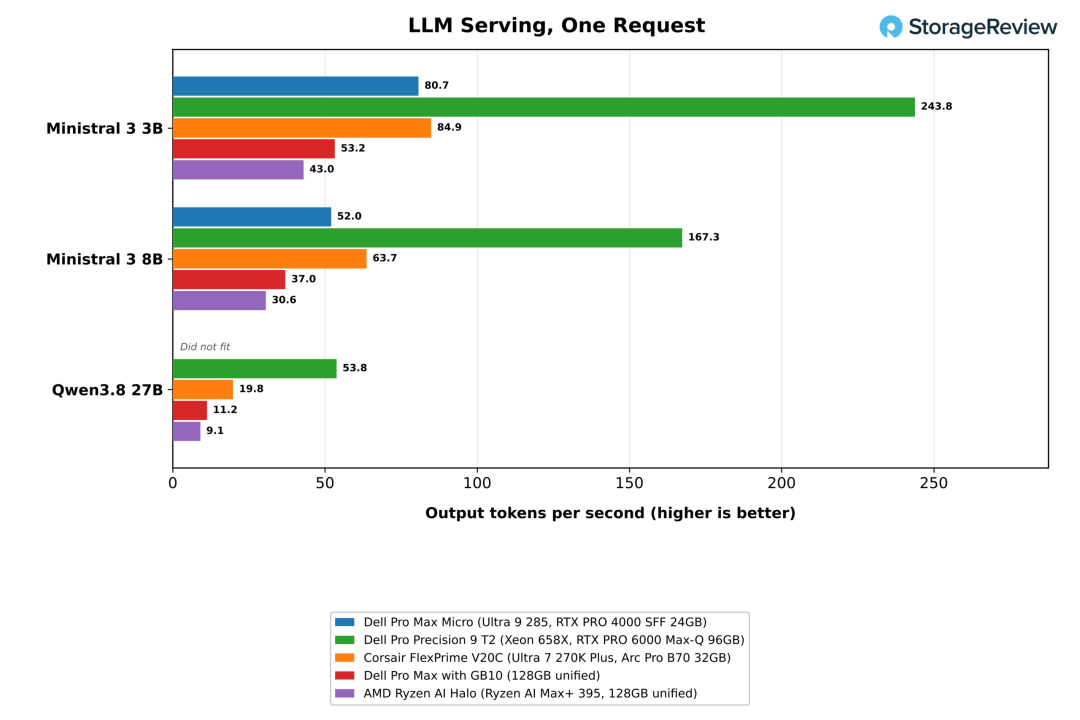
第二漏:显存。 模型装不装得进你的机器,圈内共识的粗略经验:7B模型INT4量化权重约4G,加上缓存和框架开销,8GB显存只算起步;13B要16GB左右;30B级别得24GB起步才谈得上顺畅。StorageReview刚发布的实测里,24GB专业卡跑Ministral 3 8B,单请求52 token/s很流畅;但Qwen3.8 27B的Q4量化权重加单请求缓存要30GB,根本装不下。Mac用户还得再打折:24GB统一内存,系统只分给GPU 17.76GB,llama.cpp加载还要再预留约3GB——所以社区普遍按"统一内存×3/4"来筛模型。知乎知乎StorageReview
第三漏:吃闲。 对个人和小团队来说,显卡大部分时间是闲置的,而硬件迭代快、二手残值狠,把显卡的钱摊到真实用掉的token上,单位成本可能反而比云端高。API只为你用掉的那几秒计费,本地不管用不用,那台机器的钱一直在摊着。
llama.cpp这个月刚发布1.0,新增MoE专家显存缓存。贡献者自测,93.7GiB的Qwen3.8-Flash-Next模型文件在24GB卡上原本放不下;新方案只把常用的10.7GB专家放进显存,命中率77%,速度反而快了六成。FP8 KV缓存再把缓存显存砍一半。(注:以上为贡献者机器上的自测数,换CPU、PCIe或模型都会变。)知乎
什么时候本地才真划算?数据敏感必须留在内网、7×24稳定跑批、手上现成有卡——三条全占就是真划算。一条都不占,用API加各家免费额度更香。纯粹玩机党的,也不用纠结账本:本地生成的本质从来不是省钱,是"不用排队、不限量、不把数据交给别人"。知乎