

花小三万买台巴掌大的电脑,就为了在家跑个"自己的ChatGPT"?先泼盆冷水:你买到的很大一部分是内存条本身,而不是速度。
零刻近期把 GTR9 Pro 495 推到台前:锐龙 AI Max+ PRO 495、128GB 统一内存,定价 29998 元。有意思的是,这颗芯片最高能配到 192GB 统一内存,友商同代产品敢标到 51999 元,零刻却没给。什么值得买什么值得买知乎
不是不想,是内存行情不答应:在"1条内存涨到1500元"的行情里,64GB 内存约等于 2 万元。这价差的本质是存储期货。什么值得买知乎
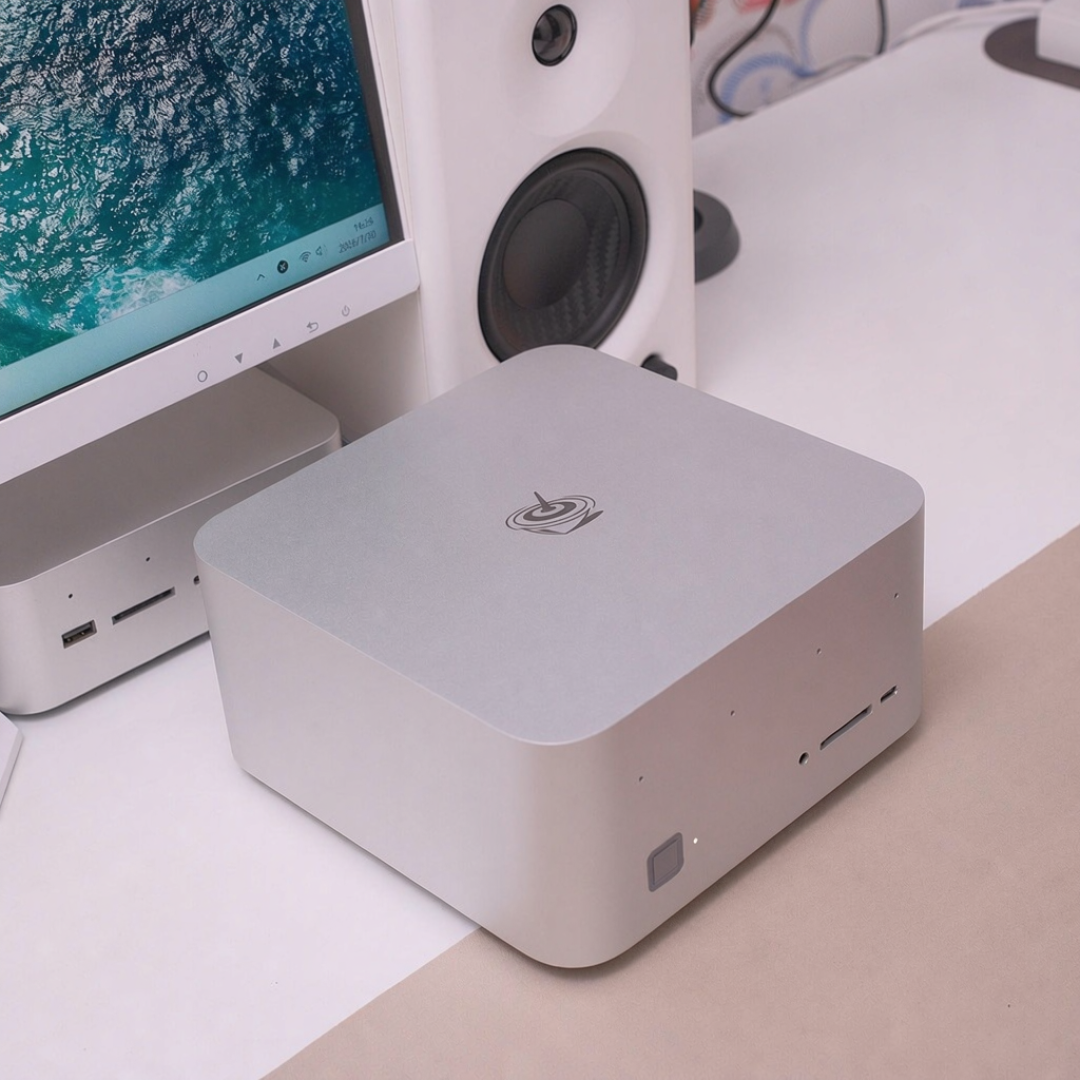
那么 128GB 到底能干啥、干得多快?三本账算清楚。
第一本账:容量,决定"装不装得下"。 128GB 统一内存,跑 70B(Q4 量化)稳稳有余,122B 的 MoE 模型压一压也能进;300B 级别就别想了,那是 192GB 顶配的门票。"装得下"是统一内存最大的卖点,也是最大的错觉。什么值得买
第二本账:速度,决定"等不等得住"。 看实测就懂:同样是 128GB 的零刻 GTR9 Pro,7B 小模型约 47 tok/s,接近即问即答;32B 稠密模型约 11 tok/s,一秒出六七个汉字。而有用户在同一档 128GB 硬件上实测更大的 122B MoE 模型(Q6 量化、短上下文),反而能跑到 25 tok/s。别被总参数量骗了——真正决定速度的是每次推理"激活"多少参数:MoE 激活少所以快,稠密模型全量激活所以慢,卡脖子的是内存带宽,不是机箱大小。知乎知乎
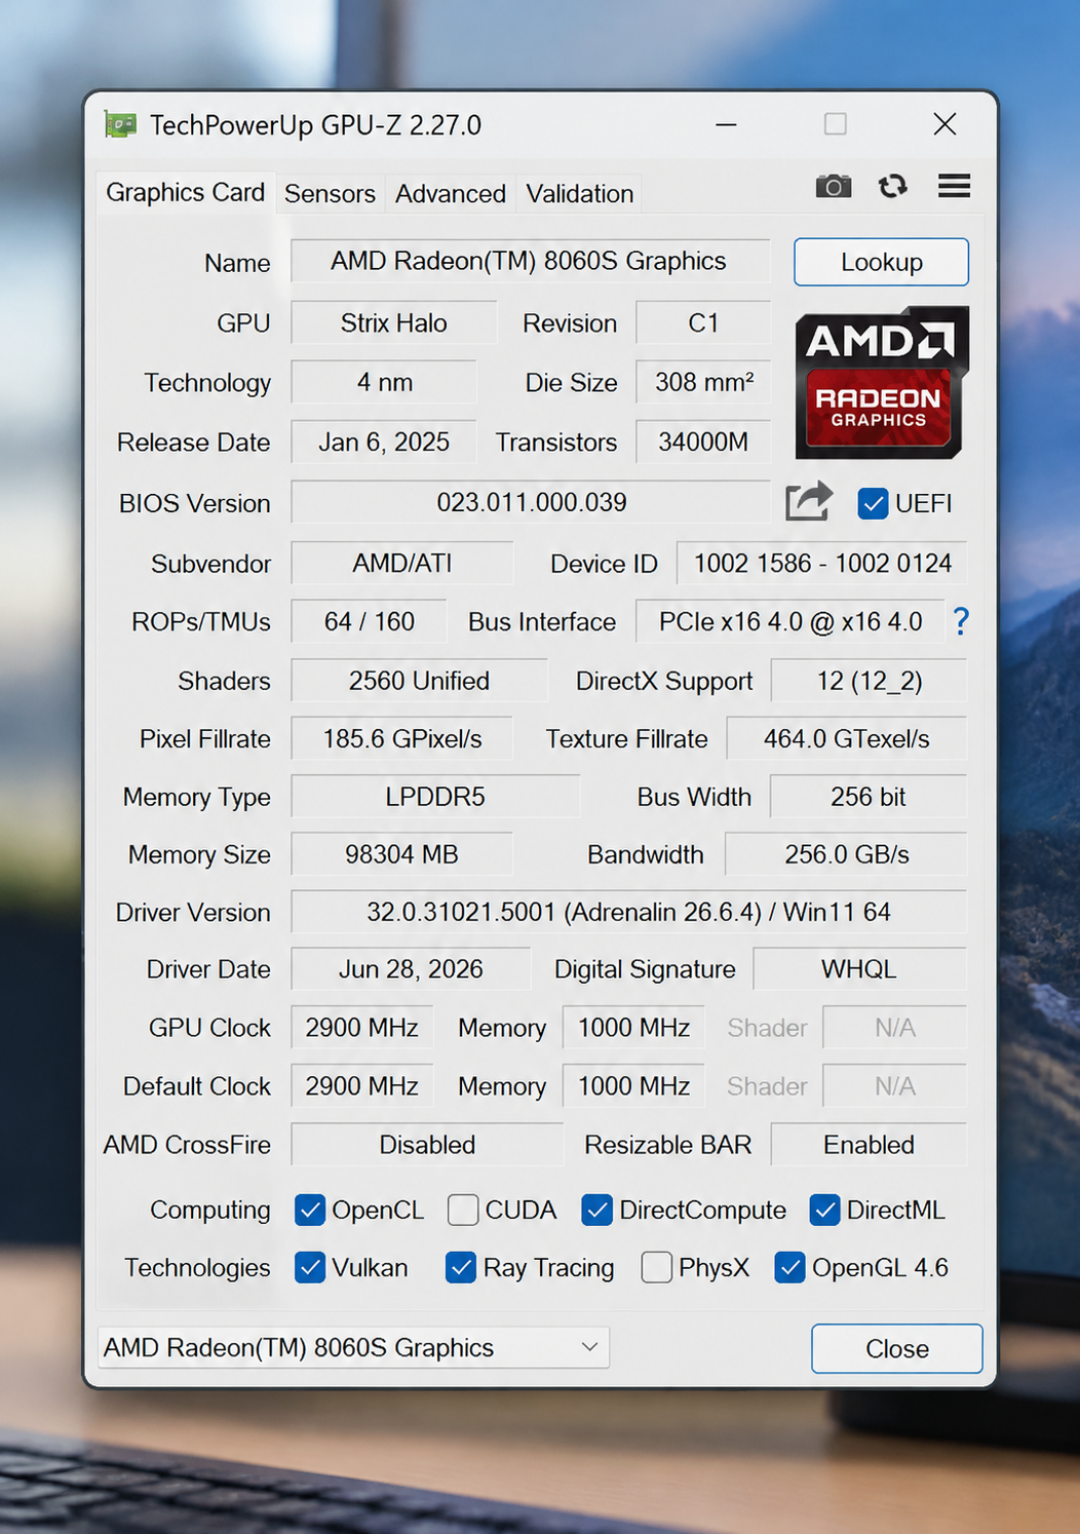
第三本账:算力宣传,看看就好。 厂商爱讲 NPU 50 TOPS、整机 126 TOPS,但实际跑 llama.cpp 时,干重活的基本是 Radeon 8060S 核显,NPU 存在感很低。4199 元到 29998 元,价差买的是容量档位,不是 TOPS。知乎什么值得买
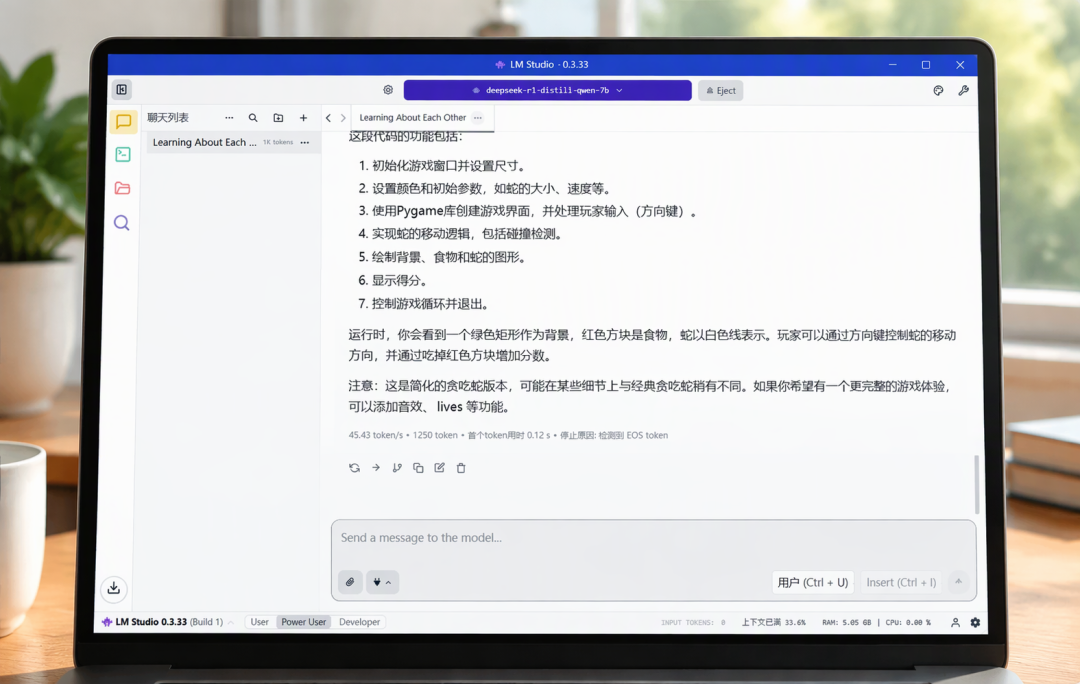
再送一个避坑经验:有玩家实测,LM Studio 的显存调度过于激进,任务场景下显卡利用率能飙到 99% 拖慢全系统。它只适合下载和试模型,真要 24 小时挂机跑服务,请用 llama.cpp + Open WebUI 这类常驻方案,甜点位是一个 35B 级别的模型:够聪明,也够快。知乎
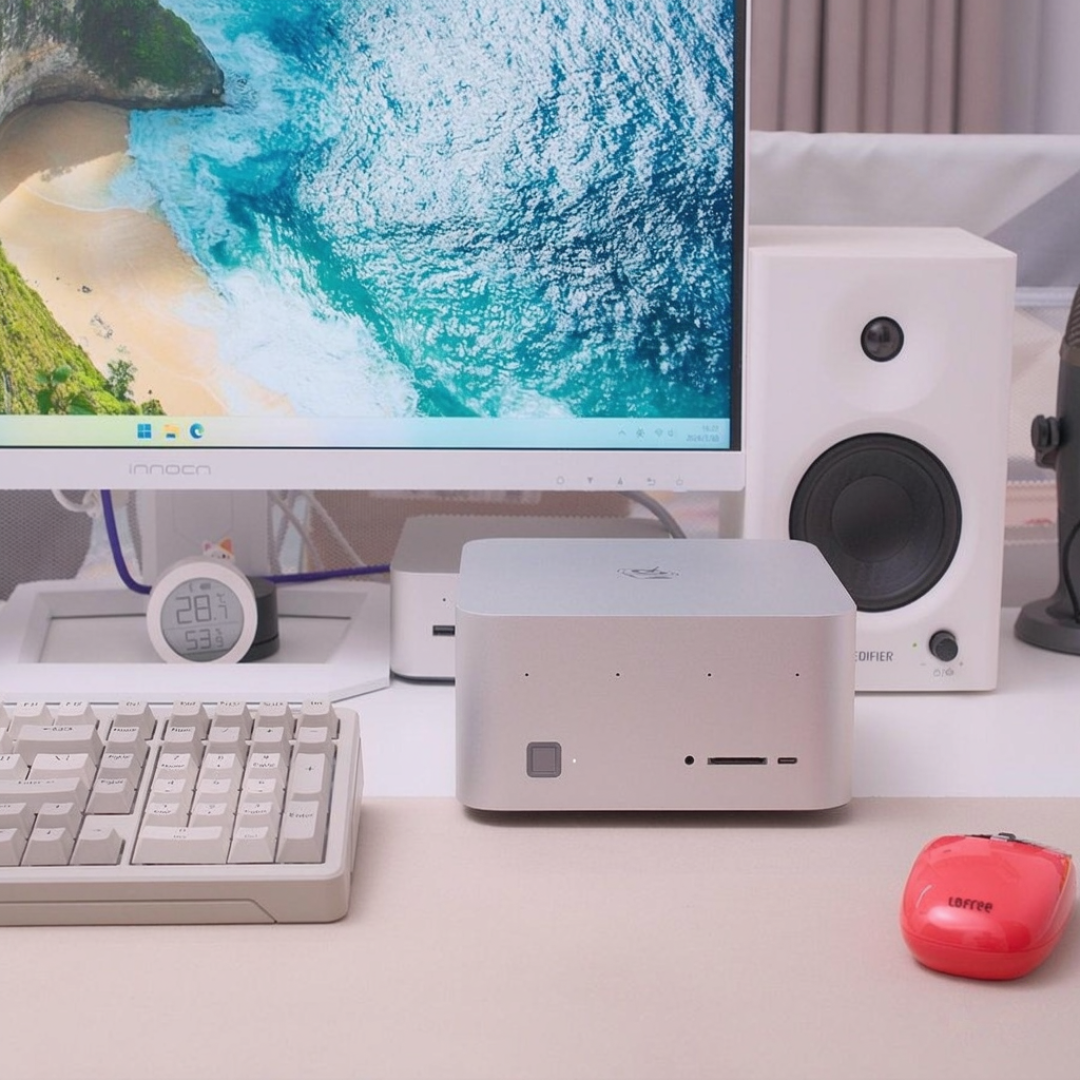
最后说人话:数据不能出本地、天天要用的法务财务程序员,128GB 档值得认真考虑;预算有限又只是偶尔玩玩的,3569 元的 SER8 加云端 API,可能比三万的"装得下"更跑得起日子。

当前文章无评论,是时候发表评论了