

把 19.53GB 的模型仓库从本机盘挪到 NAS,本来只是想腾点地方。挪完顺手加载一次,然后去泡了杯茶——回来它还在读。
同一台主机、同一份权重:本机 NVMe 6.5 秒读完,NAS 上 4 分 47 秒,差 44 倍。更扎心的是,把文件搬上 NAS 这一步自己就花了 4 分 26 秒。搬一次,够本机加载 41 次。知乎
存储第一次成了 AI 的天花板
这事以前不算大事:加载慢就慢点,跑起来就得了。今年下半年玩法变了。
colibri 这类推理引擎把显存、内存、硬盘当成同一层存储:稠密部分常驻内存,上万个 MoE 专家权重躺在盘上,用到哪个读哪个。744B 的 GLM-5.2 每步只激活约 40B,常驻内存 9.9GB 就能跑,代价是每个词都得去盘上捞专家,项目自己的说法很直白——速度取决于你的硬盘,而不是显卡。它的 Star 数 9 月中旬还是 3.4 万,11 月初已经 4.6 万+。哔哩哔哩知乎哔哩哔哩哔哩哔哩
于是“装得下就行”的存储变成了性能上限本身。NAS 厂商也开始把“能跑本地 AI”写进卖点,但千兆网口这一关,一直没人说清。微博小红书
块越小,NAS 越吃亏
同一份数据、同一台主机、全部绕过页缓存,三种读法放一张表上:
读法 | 本机 NVMe | NAS(SMB) | 差距 |
|---|---|---|---|
顺序大块 | 2855.6 MB/s | 68.0 MB/s | 42 倍 |
8MB 随机 | 2656.1 MB/s | 80.5 MB/s | 33 倍 |
4K 随机 | 34.8 MB/s(8898 IOPS) | 0.7 MB/s(183 IOPS) | 50 倍 |
盯住最后一行:183 IOPS,单次请求平均延迟 0.78 毫秒,p95 到 12.572 毫秒。知乎
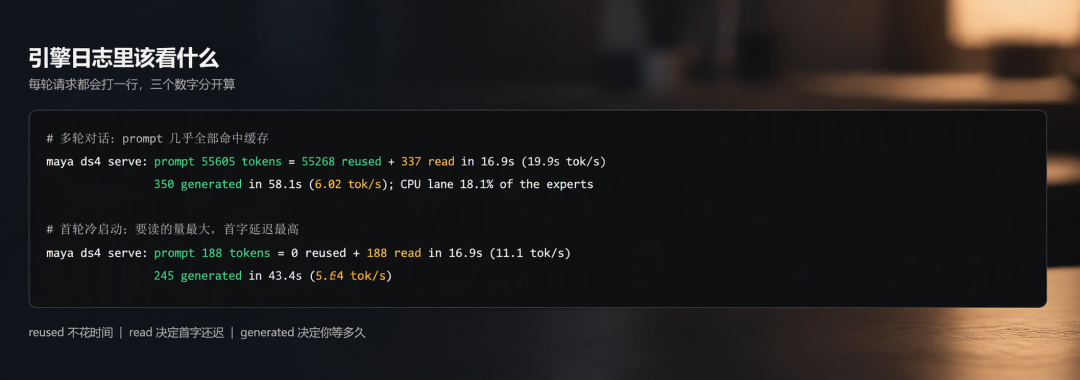
因为加载一个大模型从来不是“读一个大文件”。权重目录里是几十个 safetensors 分片,加 config、tokenizer、索引。加载器先读索引,再去分片里定位张量头,再按张量名跳着读。这个“跳着读”在本地盘上是一次寻址,在 SMB 上是一次网络往返。上千次小读取,每次排队 0.8 毫秒起,偶尔撞上 12.5 毫秒的尾巴。
一句话:NAS 的瓶颈不是带宽,是往返次数。知乎
这也是“把水管加粗”会失灵的原因。链路聚合、SMB 多通道提升的是并发吞吐,模型加载卡的是单条请求的往返延迟——管子粗了,路还是一趟一趟跑。
推理时按需取专家,账更难看
冷启动慢还能忍,跑起来慢就没法用。
Kolibri-1 是 781 亿参数的 MoE,50 层、每层 384 个专家,每个 token 每层挑 6 个,单专家 3.932MB。所以每生成一个 token 要从盘上读 1179.6MB——不是加载一次完事,是每个 token 都读这么多。知乎
同一份 7.39GB 分片按 3.932MB 块随机读 100 次:本地 NVMe 6106.60 MB/s,千兆 NAS 走 SMB 98.82 MB/s,61.8 倍。折算成出字速度,本地约 193 毫秒一个 token,NAS 约 11.9 秒。知乎
指望缓存救回来?命中率门槛是 1 tok/s 要 91.62%、10 tok/s 要 99.16%、20 tok/s 要 99.58%,而 colibri 官方实测的预取命中率是 71.6%。所以按需从 NAS 调专家不是省钱方案,它是“装不下”之后的下限兜底。当成省钱方案用,得到的是一台一个 token 等十秒的机器。知乎哔哩哔哩
不是远端不行,是链路不行
反证来自同一套测试:200G 直连的两台机器之间是 2194.51 MB/s,本机第二块盘是 2181.90 MB/s,差 0.58%。在这个粒度上,把专家库放隔壁机器和放自己盘上,成本一样。知乎
另一个独立测试更直白:同一块固态盘,在 WSL 自己的文件系统里读 4.4–4.9 GB/s,隔着跨系统挂载路径读只有 0.16–0.25 GB/s,慢约 23 倍,读一个词从 2.5 秒变成 45–71 秒。盘一个字没变,变的是中间那层协议。哔哩哔哩
那换万兆行不行?没有同口径实测。只有一个提醒:200G 直连单流也才 2194.51 MB/s,远没吃满线速,单流吞吐不由网卡标称决定,别按线速等比例外推。
四件能直接抄的事
NAS 回到归档位。 放上去就不动的冷备模型,NAS 完全胜任,大容量该买还是买,但别指望从上面直接跑推理。
运行盘必须本地 NVMe。 频繁换模型的算笔时间账:搬一次 19.53GB 要 4 分 26 秒,一天换 5 次就是 24 分钟,一个月 8.8 小时。知乎
分工照这套走。 NAS 当 7×24 的调度节点和仓库,跑 agent、定时任务、文件服务;GPU 机当算力节点,模型放它自己的本地盘。小红书
别信体感,量墙钟时间。 异步加载会把 4 分 47 秒摊成“模型起来了但前几十个 token 特别慢”。该量的是从启动到吐出第一个 token 的耗时:本机盘秒级,NAS 分钟级,一眼分得出。
最后留个对照:你付给云端 API 的那点钱,买的就是别人把权重放在离显卡最近的地方。自己攒一套 NAS 想省掉这笔,省下的是存储费,赔进去的是每次加载的四分钟。这笔交易,只在你根本不频繁加载的时候才成立。
当前文章无评论,是时候发表评论了