11月14日,微软终于说出两个词:对不起,修好了。
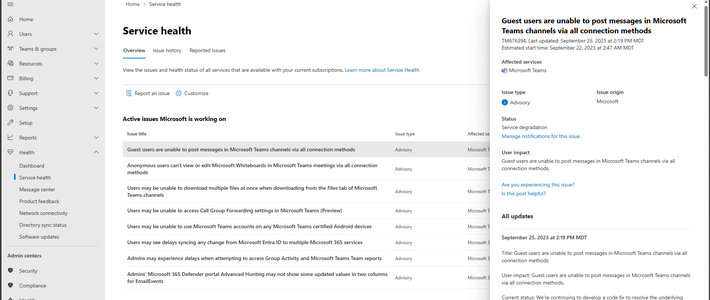
这轮事故从美东时间12日开崩,Outlook、Teams、OneDrive、Copilot一起趴窝,持续超过24小时,波及70多个国家和地区,全球累计故障反馈超740万条。Outlook报障峰值一度超过13万起。微软前一天正式道歉,说故障“与网络攻击或人工智能/智能体无关”,而是由早先一次“网络容量升级”引发。到了14日,官方口径变成:服务已全面恢复。微博知乎知乎微博知乎
是,服务回来了。但先别急着扑回工位——对宕机两天里靠微软吃饭的人,恢复只意味着通道通了,通到一半的东西,得自己挨个捡。这5件事,花5分钟就能干完:
1. 发出去的邮件,别想当然。
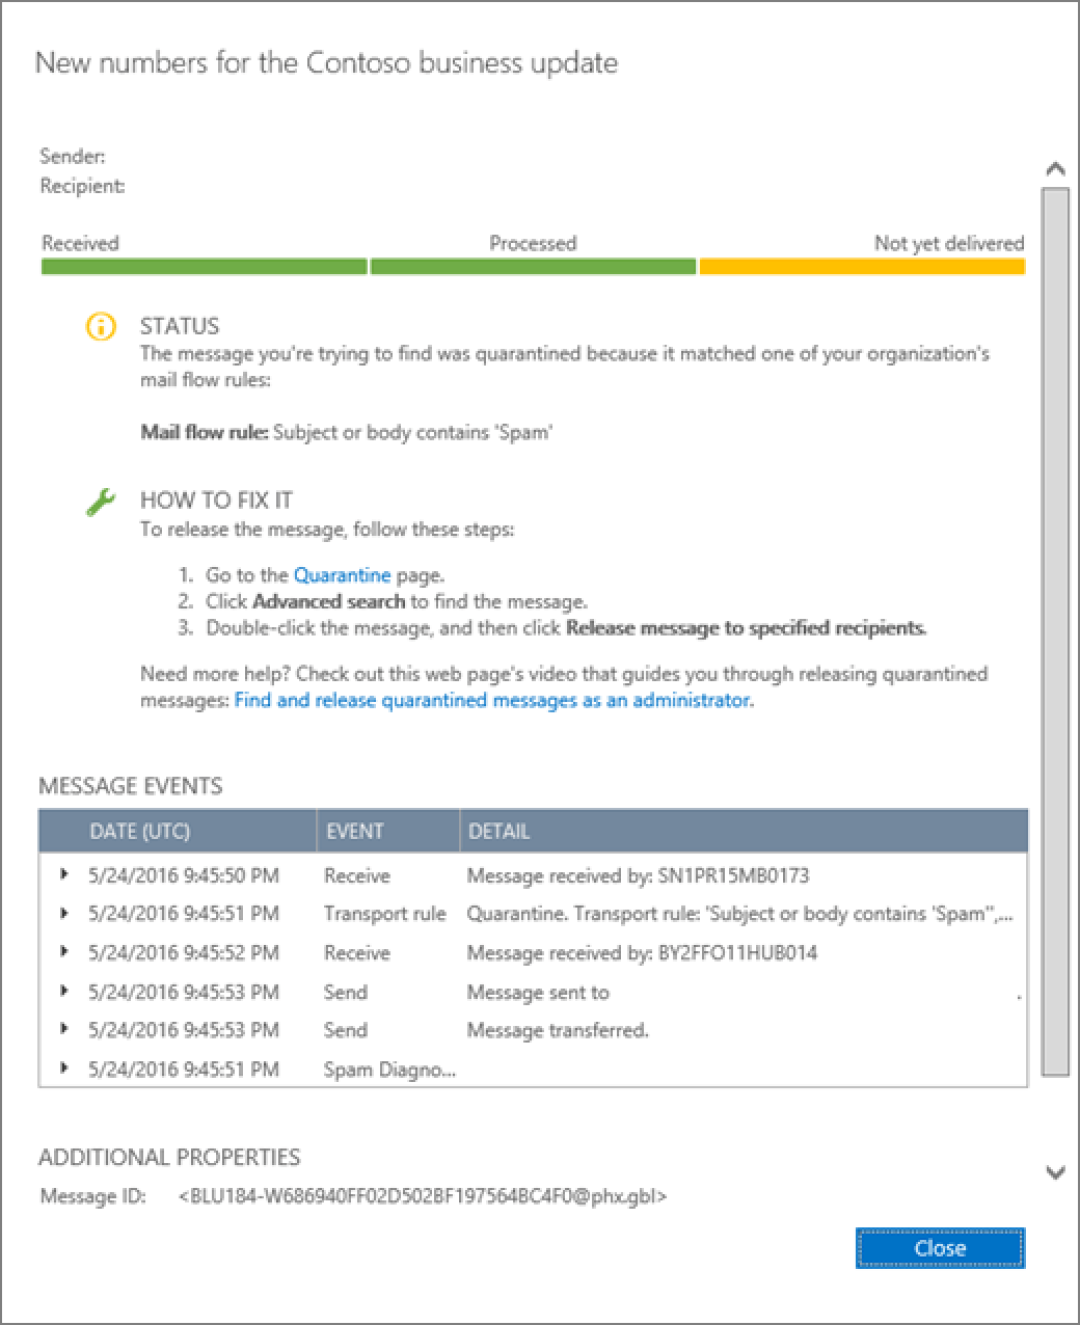
宕机那两天里"显示已发送"的邮件,不一定真送进了对方服务器。客户要是回你一句"你没发邮件吧",先回头查11/12—11/14的已发送记录,重要的重新补发一遍。企业用户还能让IT在管理后台开邮件跟踪(Message Trace),每封信的投递、延迟、被隔离状态都查得到。
2. 收件箱还没追平的,让电脑开着。
宕机期间卡在同步队列里的邮件,恢复初期往往集中涌入。Outlook开着让它自己消化,别急着强退、清缓存——一动手,积压的件反而可能掉链子。拿不准的,先查微软官方状态页,确认服务是不是真的全好了再说。
3. 草稿和改稿,先核对再"用这个版本"。
断联时存在本地的改稿和云端版本很可能已经分叉:两份都打开,确认哪份新,再定稿。多人协作的文档,核对结果同步到群里,免得同事的稿子被无声覆盖。
4. OneDrive里警惕"冲突副本"。
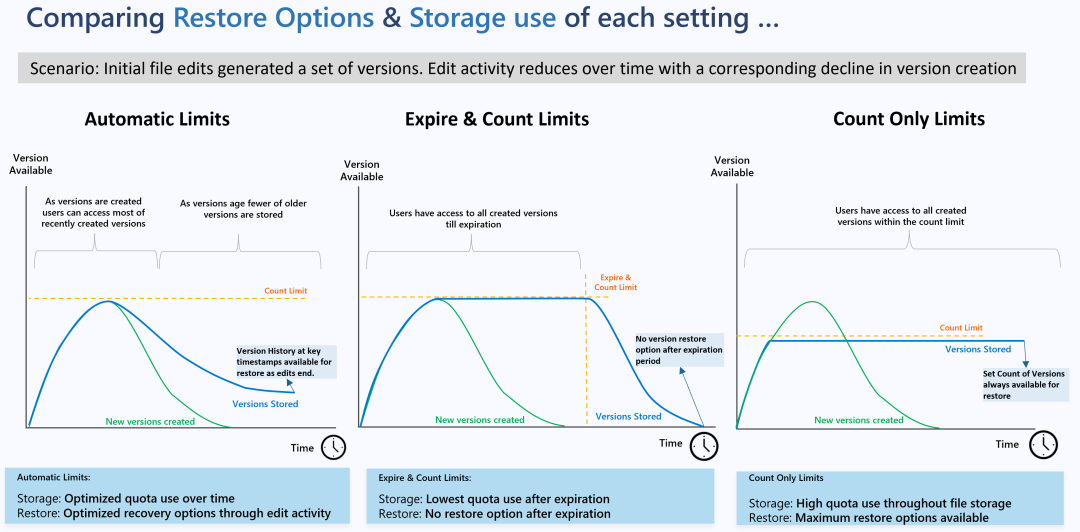
宕机时图标顶着蓝色云朵的文件,是没真正下载过的。恢复后两端各改各的,OneDrive会自动生成带电脑名的副本。趁现在理掉重复件,拿不准就翻"版本历史记录",它是后悔药,但保留有上限。知乎
5. 交给AI的活儿,人工复核一遍。
这次最阴的坑:OpenAI和Anthropic的连接器都被微软断了。Anthropic通报得很直白——故障期间Claude访问不了邮件、日历和搜索。所以让Copilot或Claude"整理客户邮件、约下周会议"的朋友,宕机那两天AI依然能跟你正常聊天,但会议邀请可能压根没发出去。去任务清单里挨个确认,别信AI一句"已完成"。微博知乎
企业用户多一嘴:别扔工单记录。微软SLA写得明明白白:Exchange类服务月度可用率低于99.9%,可申请抵扣该项服务费用的25%,低于99%抵50%、低于95%抵100%。把管理后台"服务运行状况"里的故障编号(比如EX1550543)和工单号存档。钱不多,但那是合同里写着的。知乎小红书
当然,这轮最扎心的教训不在赔偿。故障期间,很多团队连第二套联系方式都没有:会议通知发不出、改期消息传不到人,整个团队原地停摆。云厂商谁都宕过机,可怕的是把全部身家押在一家云上、还毫无预案。备用联络渠道、离线缓存、关键文件本地留底——平时看着是多余开支,出事那天才知道值多少钱。知乎
现在,Outlook转起来了,服务"恢复"了——先别急着扑回工作,上面那5件事花5分钟过一遍。别把"恢复了",过成"恢复了个寂寞"。
你司这两天断过什么工作流?评论区聊聊。