2026 年 9 月 8 日,英伟达官方技术博客挂出一篇《Introducing CUDA Rust: Two Tracks for Writing GPU Kernels》,同一周在蒙特利尔的 RustConf 2026 上讲了配套论文《Fearless Concurrency on the GPU》。这条新闻在中文圈晚热了两周:9 月 12 日 B 站已有中配视频讨论"Rust 正成为 GPU 编程新核心?“,9 月 17-18 日 Tony Bai 的译文刷屏知乎,爱可可在微博把它定性为"GPU 编程范式转移”,连带一个 150 万播放的老问题"CUDA 真是 NVIDIA 绝对牢不可破的生态吗"被重新顶回前排。英伟达技术博客知乎微博
这篇先说清是给谁看的。正在写或正在学写 kernel 的人:B 站上一条 CUDA 执行模型拆解视频,收藏是点赞过百,2027 届秋招话术都开始挂 AI Infra。 还有想用 Rust 碰 GPU、但一直卡在"kernel 本体只能写 C/C++"的人。看完你要能回答三个问题:官方到底给了什么、两条路的门槛差在哪、哪些坑它们压根没解。哔哩哔哩
第一本账:官方给的是什么,别误读成"CUDA 用 Rust 重写了"
先把最容易被标题党带偏的一点钉死:这次发布没有重写 CUDA,也不是说 CUDA C++ 不行了。英伟达在博客里自己的定位很克制——CUDA C++ 和 CUDA Python 是"成熟的、企业级的工具链",CUDA Rust 会"在 2027 年及以后继续成长"。它是 CUDA 的第三个前端,和 C++、Python 并列。英伟达技术博客
真正变的东西只有一件事:kernel 本体可以用 Rust 直接编译到 PTX 了。以前 Rust 也能"用 CUDA"——host 端调 launch、通过 cudarc、rust-cuda 这些绑定发指令,但 kernel 本身还是 C/C++ 编译出来的产物。这次是那个"例外"被补上了。英伟达自己的逻辑线也在这:Nova Linux 驱动是 Rust 写的,Dynamo 的 core 是 Rust 的,NVTX 有 Rust 绑定——唯独 GPU kernel 一直是例外。知乎英伟达技术博客
也别觉得这是从零开始。博客明确点名 rust-gpu、rust-cuda、CubeCL、cudarc 这些前驱项目"早就趟过这条路",官方还在和 rust-cuda 的维护者保持协作。英伟达技术博客
这次"新"的是:英伟达把工程资源正式投了进来,并给了路线图——未来 CUDA Rust、CUDA C++、CUDA Python 三个前端要能互操作,选 Rust 不会被锁死在 Rust 生态里。英伟达技术博客
第二本账:两条路门槛差一大截,逐条摆开
官方给了两条轨道,对应 CUDA 自己的两种编程模型,建议原话是"优先伸手拿 Tile,只有要精细控制线程和共享内存时才下沉到 SIMT"。英伟达技术博客
cuda-oxide(SIMT 路线) | cutile-rs(Tile 路线) | |
|---|---|---|
心智模型 | 像 CUDA C++:指定一个线程干什么,launch 几千个 | 你只操作一整块 tile,背后用多少真实线程编译器说了算 |
编译路径 | 自定义 rustc 后端:#[kernel] 函数走 Rust MIR → Pliron IR → LLVM IR → PTX,host/device 同文件一条命令编译 | #[cutile::module] 宏把 kernel 的 AST 嵌进宿主二进制,首次调用经 CUDA Tile IR JIT |
环境要求 | Linux + 算力 8.0+ + CUDA 12.x + clang/libclang + 锁定版 nightly(2026-04-03) | 算力 8.0+ + CUDA 13.3 + stable Rust 1.89+,不用 nightly、不用自带 LLVM |
现状 | 早期 alpha | 已发布到 crates.io(截至 9 月 18 日为 0.3.1) |
生态使用 | —— | HuggingFace 的 Grout 推理引擎、mistral.rs(官方口径:英伟达之外已有项目在用) |
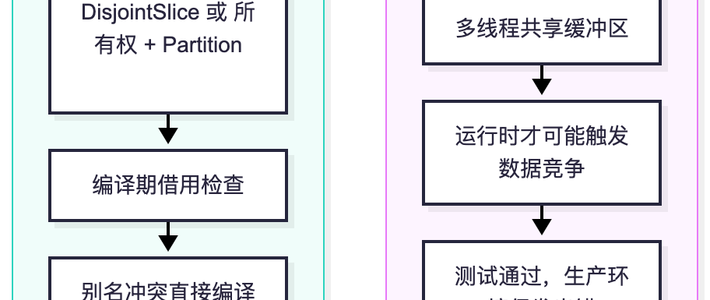
内存安全设计 | DisjointSlice 把一个可变借用拆成每线程独占一块;#[launch_contract] 声明索引维度和 block 大小,launch 前校验 | .partition([128]) 一步完成独占所有权、grid 规模和 tile 宽度推导;所有权跟着张量穿过 launch 边界 |
两个项目 4 月/3 月就开源在 NVlabs 名下,到官宣两周后的 9 月 18 日,cuda-oxide 拿到 3500 星、62 个 open issue,当天傍晚还有新提交;cutile-rs 977 星、44 个 open issue。alpha 是真 alpha,但活着,而且动得很快。GitHub

硬件门槛反而不高:两条路都只要求算力 8.0 以上,30/40/50 系消费卡全部在圈里。真正决定你上手成本的是工具链——cutile-rs 要 CUDA 13.3,cuda-oxide 要伺候一套锁死日期的 nightly 加 libclang,官方自己都承认"cargo 和 crates.io 让用户习惯开箱即用,GPU 编程历史上恰恰相反",而 cuda-oxide 锁 nightly 这件事"正是我们想尽快不再要求你的"。英伟达技术博客
第三本账:解了什么、绕了什么——r/rust 那三层冷水
解掉的:经典内存别名 bug。 几千个线程乱序访问同一块内存、一个在写、结果取决于谁先谁后——这类 bug 出了名难复现,测试全绿、生产环境炸。现在把 SIMT kernel 的输出缓冲区当输入传进去,编译直接报 E0502;Tile 那边同一个张量既想 partition 又想原样传入,报 E0382。别名 bug 从"跑起来才知道"变成"写的时候就知道"。这才是这次发布在 Rust 社区炸锅的根本原因:内存安全叙事第一次真正下沉到 kernel 这一层。英伟达技术博客

绕开的:地址空间。 根据流传的 r/rust 讨论翻译,信息量最大的一条评论指出:CUDA 的内存不是连续的,常量内存、workgroup 内存、全局内存是互不重叠的地址空间——两个指针数值相同都不代表指向同一块内存。Rust 类型系统目前没有这个概念,cuda-oxide 和 cutile-rs 都是紧贴英伟达硬件把这个题绕过去的,不是解开的。知乎

还没安全的:SIMT 的 shared memory。 官方写明目前需要 unsafe,而共享内存恰恰是快 kernel 的地基,"把它做安全"是正在进行的活。也就是说,最考验 CUDA 功底的场景,恰恰是这条 SIMT 路线现在最虚的地方。英伟达技术博客
"纯 Rust AI 技术栈"离得还远。 r/rust 帖子的标题就是那句灵魂拷问,但评论区三层递进的泼冷水更值得抄下来:一,Burn/CubeCL 早就在做厂商中立的 Rust GPU 栈,但有人现身说法推理性能明显落后 Torch 和 ONNX Runtime,算子覆盖有限;二,"CUDA 是终极供应商锁定"的喊话马上被反问——除了 CUDA 还有什么真正能打的?Vulkan 计算着色器理论自由,但在吃 FLOPs 的训练/推理场景拿不出接近 cuBLAS/CUTLASS 的性能;三,一位做过可移植深度学习编译的前英伟达员工搬出 OpenCL 的没落做前车之鉴:客户要的是硬件极致性能,不是抽象层的整洁,架构多样性越高,语义鸿沟只会越大。务实派的结论反而是:llama.cpp、mistral.rs 已经证明了核心留 C++、外围用 Rust 完全不冲突,“别死等一个纯 Rust 版本才肯用”。倒是真有人用 Rust 版 CUDA 把自己无人机机器人系统里的 C++ 砍掉了大半——但那是系统层,不是训练框架。知乎
为什么偏偏是现在:护城河换打法,语言层补人
把这一周的同框信息摆在一起看,这件事就不只是"多了个前端"。SemiAnalysis 九月那篇《CUDA moat hold up 吗?》(9 月 18 日中文译文在知乎热转)的核心论点是:agent 时代推理的竞争已经从单个 kernel 快不快,变成 KV cache、路由、调度这一整套系统工程能力,英伟达的优势没消失、只是换了形态。另一条常被放在一起讨论的,是摩根大通关于 2027 年定制芯片出货占比将超过 GPU 的报告。知乎知乎
系统层人才往哪流,做驱动和推理框架的人心里都有数——Nova 驱动、Dynamo 已经是答案的一半。英伟达此刻把 kernel 这块最后的例外交给 Rust,更像是主动去接这波人才,而不是护城河失守。证据到这,结论就只能到这:这是护城河的一次换防,不是城墙的塌方。
谁该动手,谁只看不动
Rust 系统层开发者:今天就可以动 cutile-rs——stable Rust + cargo add 就能跑通官方那个 1024 元素 vecadd,再试试 tile 化的矩阵加;想玩 cuda-oxide 的先给 nightly 和 libclang 留一天,把它当玩具级评估,别碰生产。
CUDA C++ 老兵:技能树没有作废,PTX 和 Tile IR 还是共同底座,你脑子里那套 warp/block/共享内存的心智模型恰恰是 Rust 这边新补的课。可以直接搬回家的是一条纪律:把"编译期防别名"当参照,回头审视自己 kernel 里靠人肉保证的输出缓冲不重叠假设。
秋招/转 AI Infra 的学习者:先学模型再学语言——warp、SIMT、tile、KV cache 这些概念不值钱在"哪个语言"上;但简历上能聊清楚 cuda-oxide 和 cutile-rs 的区别,就是比同龄人多一截的谈资。
团队/管理者:现在投资重写任何 kernel 都是浪费。放进技术雷达,等下面四个信号再上会。
继续盯这四个信号:cuda-oxide 哪天去掉 nightly 锁定;SIMT shared memory 何时做进 safe 层;Rust/C++/Python 三前端互操作何时落地;地址空间问题进不进语言层面的议程——或者干脆,看 CubeCL 这类厂商中立路线什么时候交出一份能打的生产级推理。
下一代刚学写 kernel 的人,第一个学的语言可能既不是 C++ 也不是 Python。你觉得这次是真的换挡,还是又一次雷声大雨点小?评论区聊聊你卡在哪一步。















