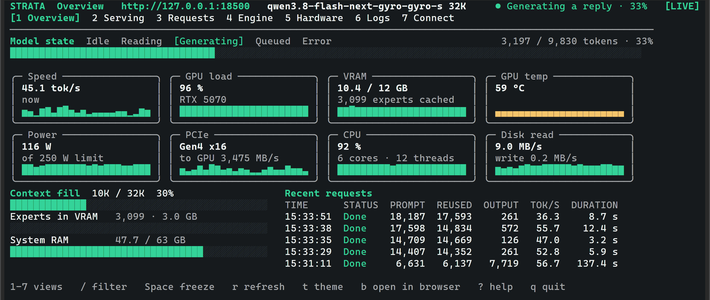
这两天B站和知乎的DIY圈有点反常:平时聊装机、聊涨价的帖子底下,突然全在刷同一个词——Strata。一个GitHub star数刚冲到3.4万的开源项目,让一堆人翻出了抽屉里的老显卡:GTX 1060、RX 580、3060,这些在AI叙事里早该退役的卡,现在被拿来跑1250亿参数的大模型,而且是能日常用的速度。
这事放在平时,最多算个极客玩具的新闻。但放在当下这个时间点,味道完全不一样:新卡这边,RTX 5060已经涨到4099元,RTX 5070涨到8399元,全部刷新历史最高价;二手那边,复产的3060卖3300,比五年前首发价还贵。“想玩本地AI,先花大几千换大显存卡”——这几乎是所有人的默认路径。而Strata捅破的正是这层窗户纸:你手里那张8G、12G的"游戏卡",可能根本不用换。知乎
8G显存怎么塞下125B?不是压缩魔术,是换了个算法
先说清楚原理,不然听着像标题党。
传统认知里,跑多大的模型就要多大的显存,经验法则是"1B参数约等于1G显存",125B的稠密模型光权重就要100GB以上,那是A100/H100或者多张3090并联的领域,整机成本数万元起步。这套法则对稠密模型没毛病,但Qwen3.8-Flash-Next这类MoE(混合专家)模型把前提改了:它有24000多个"专家"子网络(48层×512个路由专家),每生成一个token,路由门控只挑每层最匹配的约10个专家参与计算。也就是说,任何一个瞬间,真正需要待在GPU算力单元旁边的权重只有几个GB——剩下的99%,躺在别处等着被翻牌子就行。知乎知乎
Strata干的事,就是把"别处"安排明白:显存负责快(注意力计算、热点专家),内存负责容量(专家缓存),SSD负责兜底(冷数据)。哪个专家被路由选中又不在显存里,就从内存调进来,调度得当的话,比传统llama.cpp那种整块卸载方案快得多——有实测对比,同样任务传统CPU卸载要104秒,Strata的动态分片预取只用28.8秒,接近4倍差距。知乎
一句话总结:不是模型变小了,是"模型必须整个住在显存里"这条规矩被推翻了。装机猿在视频里的感慨挺有代表性:早年1B参数要1G显存,现在12G显存敢聊300B。哔哩哔哩
社区实测数据汇总:你的卡在哪一档
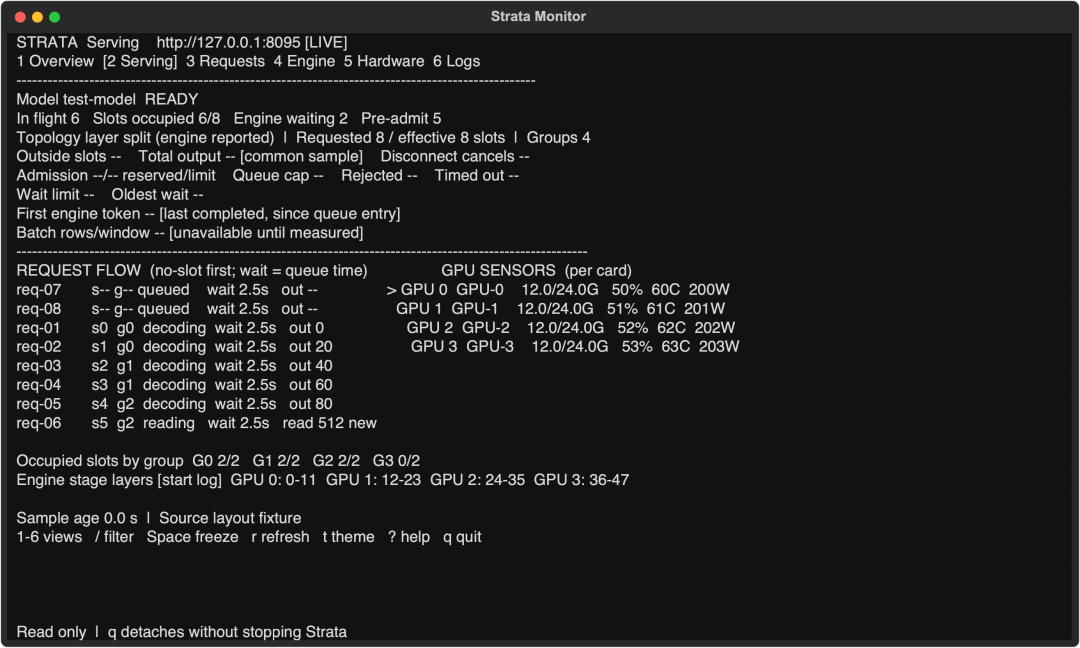
这两周知乎和B站的实测帖很多,配置五花八门,我把有具体数字的整理成了对照表,都是跑Qwen3.8-Flash-Next系列(GGUF量化格式,不同档位):
显存 | 显卡 | 内存 | 量化档 | 生成速度 |
|---|---|---|---|---|
6GB | GTX 1060 | 16GB | Coder IQ1_M | 15~18 tok/s |
8GB | RX 580 | 32GB | Swift IQ2_XS | 18~23 tok/s |
12GB | RTX 3060 | 64GB | IQ3_XXS | 约30 tok/s |
16GB | RX 7800 XT | 约121GB | Coder IQ1_M | 38~44 tok/s |
24GB | RTX 3090 | 双路Xeon v4平台 | 高量化档 | 调优后100+ tok/s |
参考线:20 tok/s以下属于"能跑但煎熬",40 tok/s算日常可用,60 tok/s以上就很流畅了。知乎
最狠的是那位E5-2666 v3平台的作者:50块的洋垃圾CPU、80块的16G ECC内存、两三百块的GTX 1060,整机成本500元出头,跑出19~21 tok/s。这个成绩当然有运气和折腾成分,但它说明的事很硬——本地大模型的入场券,已经从"买什么卡"变成了"会不会搭"。知乎
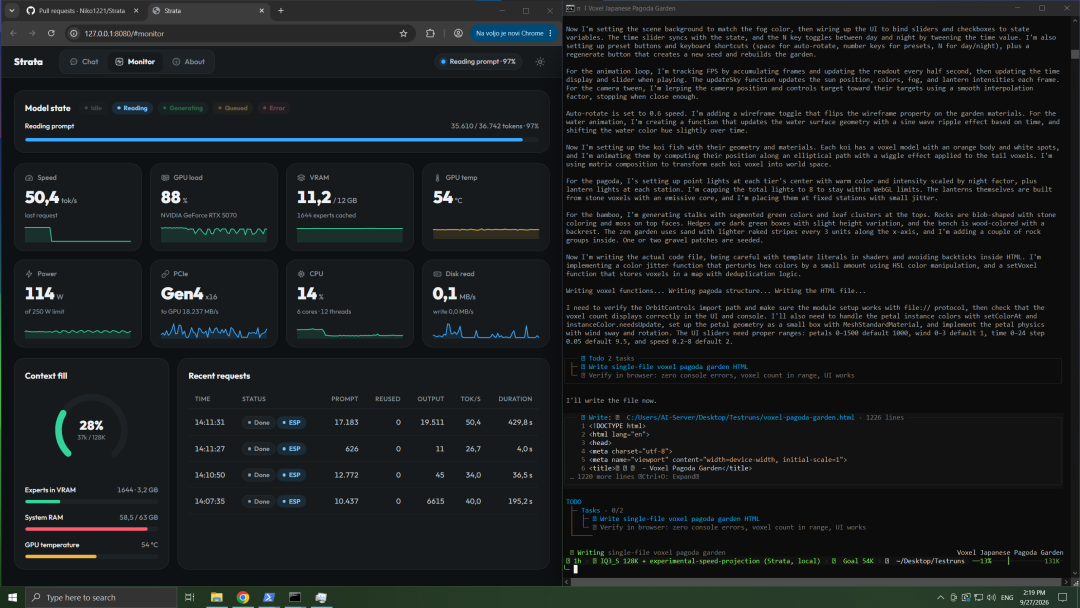
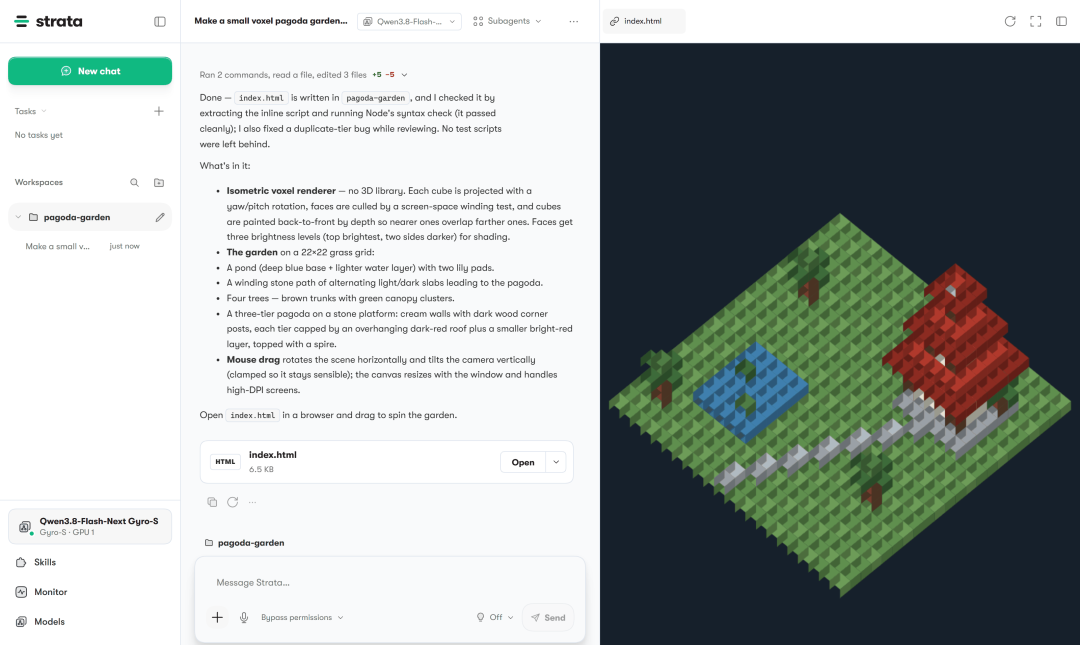
顺带一提,Strata跑起来之后本机直接提供OpenAI/Anthropic兼容接口,可以接Claude Code、Codex这类编程智能体。也有人接进Blender MCP做动画、接截图识别(Patch Reader)。它不是一个聊天玩具,是给整套本地AI工作流当发动机的。AMD用户也有对应项目gufo在跟进。知乎知乎
泼三盆冷水:瓶颈没消失,只是搬家了
看到这里先别急着下单内存条,反面的账也得算。
第一,显存的门槛降了,内存和硬盘的门槛升了。玩Strata的圈子里有句话很传神:"显存降级了,但内存和硬盘升级了。"125B模型的低比特量化文件也有几十GB,想跑得顺,内存32GB是底线、64GB起步舒服,还必须是SSD——机械硬盘直接判死刑。上面表格里7800 XT那套配了121GB内存,就是这个原因。知乎
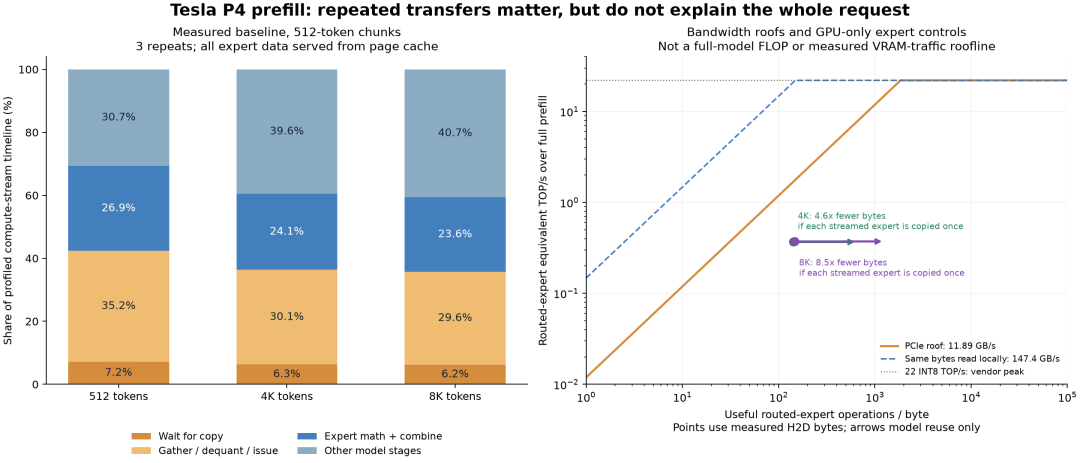
第二,低比特量化是有代价的。IQ1_M、IQ2_XS这种极限压缩档,中文表达和常规问答还行,但复杂逻辑推理会出错,代码能力打折扣。想接近在线大模型的智商,量化档要往上走,内存占用也跟着涨。另外有5060 Ti 16G+256G内存的用户反馈prefill(读取长提示词)很慢。喂长文档、大代码库的场景,体验还得打个折。知乎
第三,这套玩法目前吃MoE架构的红利。跑的是Qwen3.8-Flash-Next、DeepSeek这类稀疏激活模型才能这么玩——Strata对DeepSeek的支持最近才刚开始。你要跑的是稠密模型,或者要跑训练、微调,显存该多大还多大,Strata救不了。知乎
社区实测数据也普遍偏乐观、方差大,多数是"跑通了、晒个速度",缺少长时间高负载的稳定性反馈。这个项目9月底到现在版本迭代飞快:v0.1.42推理提速15%-30%,v0.1.43.1双卡批量服务又提速约35%。说明它还在快速进化期,坑会越填越少,但现在跳进去,动手能力的要求不低。知乎知乎
所以,到底换不换卡?
把决策拆开看就清楚了。
如果你手里是6~8G显存的老卡(1060、RX580、2060这个级别):别卖,也别为了AI换卡。花三五百把内存加到32~64G,先把Strata装起来跑通,15~23 tok/s的速度足够体验本地大模型和轻量AI编程。这条路的试错成本,还不到现在一张RTX 5060的十分之一。
如果你是12G卡(3060 12G、4070这一档):恭喜你,按社区实测这是目前的甜点显存——IQ3_XXS档30 tok/s,质量和速度平衡得最好。3060 12G二手被炒到3300这件事,现在看多了一层含义:它不只是"便宜游戏卡",还是最便宜的本地AI入场卡。已经有卡的人,加内存比任何人都有理由先动手。
如果你是16G~24G卡:直接上高量化档,体验接近"本地AI自由",优先把钱花在内存容量上(64~128G),而不是换24G以上的N卡——那部分溢价现在是AI需求在买单,游戏和本地推理都用不上。
真正该换卡的只有一种人:需求是稠密大模型、训练微调、或者纯游戏4K高刷,那Strata帮不了你,回到传统显存逻辑里算账。
最后给个观察清单,这条赛道接下来一两个月值得盯:Strata对DeepSeek系列的支持成熟度、AMD侧gufo项目的进度、以及内存价格。DDR5大容量条最近开始回落,双32GB套装单日降了两百多元。如果内存持续降价而显卡持续涨价,"小显存卡+大内存"这套配置的性价比还会继续走高。知乎哔哩哔哩
你手里现在是什么卡、多大内存?评论区报个配置,看看谁的"垃圾佬组合"跑分最离谱。