前阵子本地推理圈最大的动静是显卡解锁:开源项目把出厂锁住的算力峰值解到接近翻倍,可实测党发现——预填充确实快了,逐字出字没怎么动。结果10月底,"出字速度"这块反倒是软件侧补上的,一张卡都不用换。先说结论:这波提速是真的,也免费,但每份成绩单后面都塞着一张账单。机器之心知乎
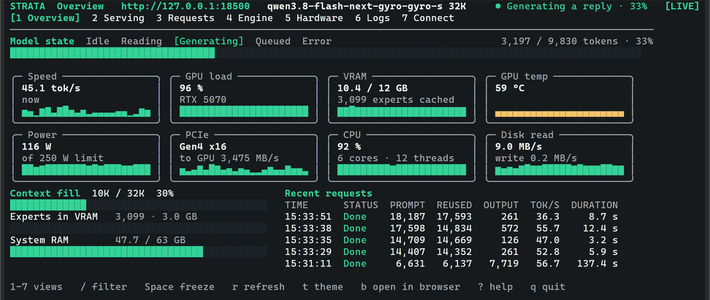
① Strata 0.2.7:改默认值,代码回答快37%,官方还留了回滚开关
开源项目Strata(github.com/Niko1221/Strata)这次更新没加新功能,改的是十几处默认调度。官方数字标注了实测机型:12GB NVIDIA老卡,代码任务提速37%,一项任务从141.8秒干到27.7秒。原理一句话:MoE的专家路由改成优先用常驻显存的专家,少换一次页,多出一截速度。DeepSeek还搬上了AMD AI MAX,上下文扩到1M。哔哩哔哩
代价也写了小字:评论区高赞直接点破——“变快的两个参数,其实是用变蠢换来的”。官方没装死,留了一键退回0.2.6的开关。哔哩哔哩
② HyperQwen:3090跑到131 tokens/s,中文实测可能只有30
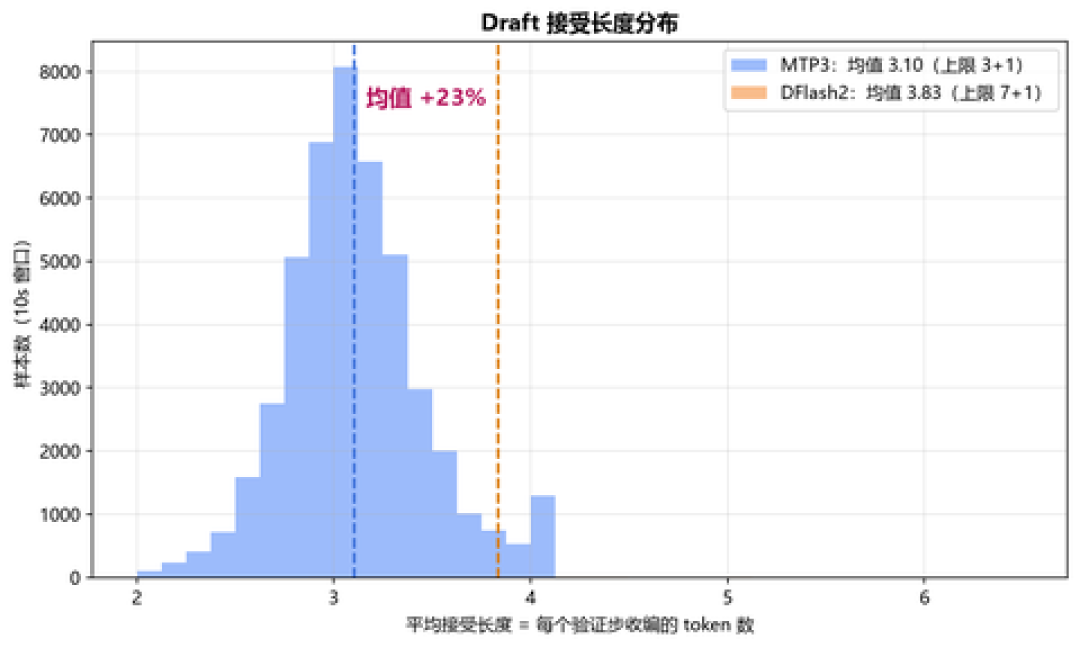
针对Qwen3.8-27B的专用引擎,官方战报单路131 tokens/s、32K上下文还有81。知乎答主刘聪NLP的复现泼了盆冷水:跑官方脚本的英文/代码测试,约100 tokens/s,基本达标;换中文题,一开始直接掉到30上下。原因很黑色幽默:MTP草稿头默认带4万词元的小词表,显存是真省,中文草稿接受率却只有7%。叠双Triton+CUDA图可再推到122,但25K和50K+上下文的更优后端还不一样。老卡的第二春是真的,只是官方速度按场景发货。哔哩哔哩知乎
③ 换一个MTP文件:整段快27%,长文开头多等6秒
一位迷你主机玩家同机对照:同一个模型,带不带MTP各跑一遍——短问答整段85.9秒→62.3秒,出字58→66字/秒;但长文首段等待42秒→48秒,反而多等6秒。投机解码类加速就这个画风:出字越多越占便宜,等得越久越吃亏。日常问答白捡,重度读长文档的,这顿免费午餐未必合胃口。哔哩哔哩知乎
④ 社区的真实标尺:763B跑到25 tokens/s,瓶颈换成了内存和硬盘
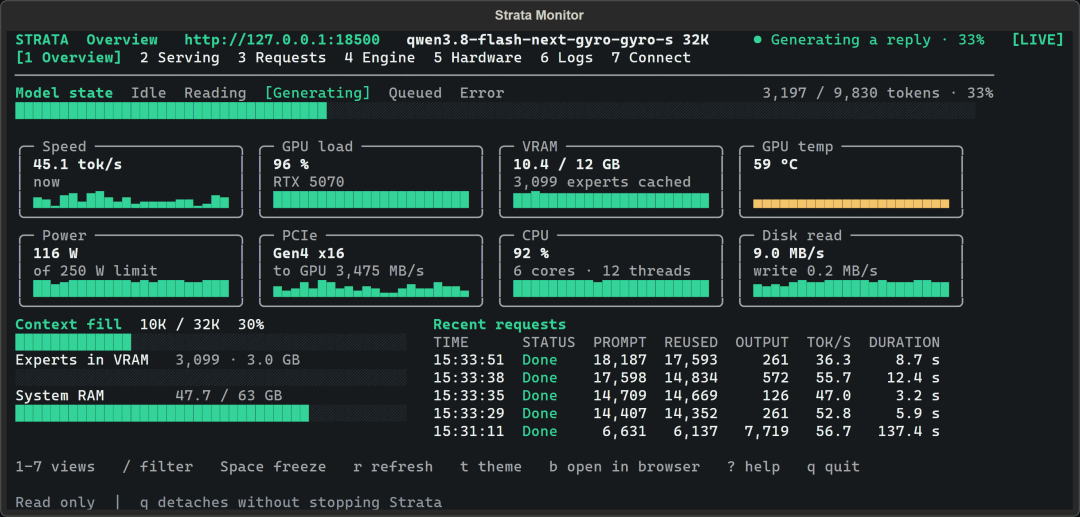
评论区比跑分诚实:有人5090D跑DeepSeek V4.1-Flash(XQ量化约Q2,152G模型+203G nGram),实测约25 tokens/s,高赞总结是"就是太废硬盘"。有人48G内存只喂得出8K上下文、7 tokens/s——出字卡壳,元凶往往是内存不是显存;圈里公认的体感线:decode上30才算快,接Agent还得prefill扛住1000+。连算力舱玩家说的也是同一句:硬件没变,引擎优化把输出从50拉到90-100。提速的主战场,已经离开显卡了。哔哩哔哩哔哩哔哩
怎么上车:先看清三张账单
先别急着升级,动手前核对三件事:更新说明里有没有回滚开关(Strata 0.2.7就是范本);官方测试脚本跑的是不是你的语言和任务(英文103≠你的中文30);加速把成本挪去了哪——降智、首等待,还是你那块被nGram啃的SSD。各家数字都标了具体机型和场景,本文证据止于"官方+复现",跨出范围别硬套。跑一遍你自己的任务,那才算唯一的成绩单。