本地部署圈子里,过去两年有条公认的共识:端侧没有大模型。8G、12G显存塞进量化过的7B、14B就到底了,想干正事,拔网线、怼云端。
但这个10月,巨头们正把这张桌子一块一块掀掉:
10月8日,微软旧金山发布会,首批搭载RTX Spark的笔记本开卖,Surface Laptop Ultra起售价2599美元,黄仁勋的说法是"当年开启AI革命的DGX-1,算力也是1petaflop——现在它进了笔记本"。智东西
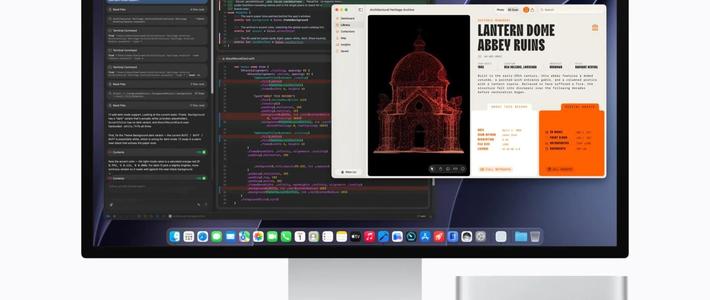
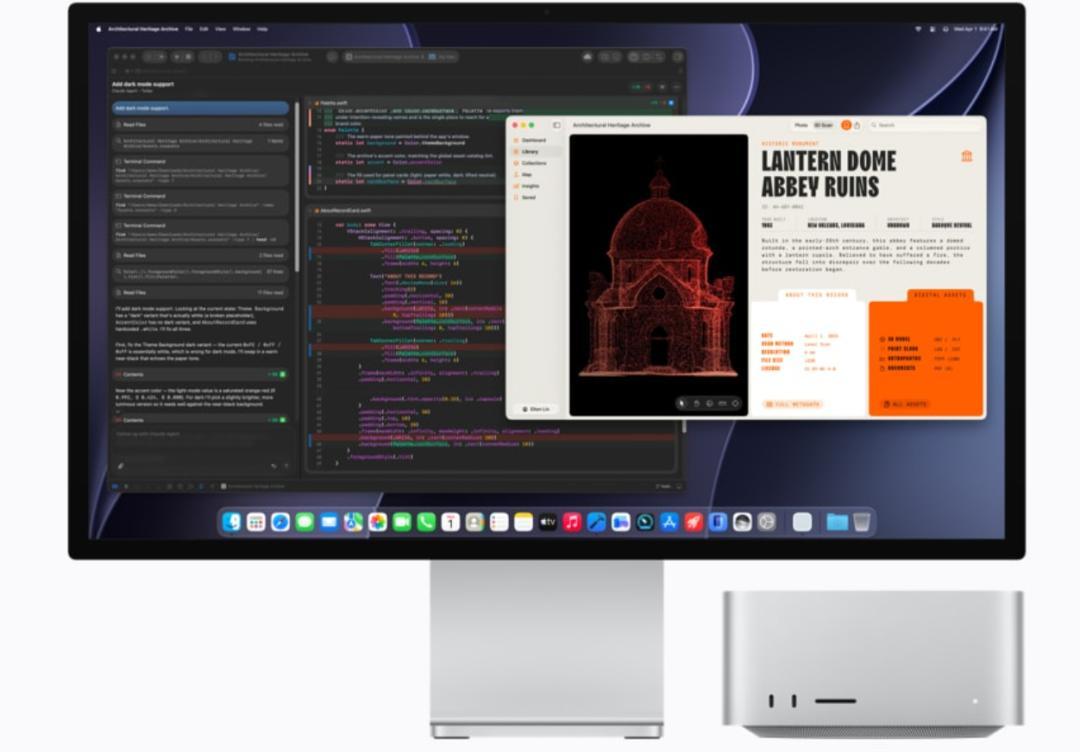
10月16日,Meta开源8160亿参数的Muse Spark Open,苹果用MLX框架,在两台512GB的M5 Ultra版Mac Studio组成的集群上跑通了完整推理。知乎
10月17日,联想YOGA Pro 15 RTX Spark版发售,官方口径是"端侧跑通超千亿大模型的超级AIPC"。36氪
10月26日,知乎有个很现实的新问题:“本地跑700GB大模型,Mac Studio和DGX Spark怎么选”?
说白了,2026年版的"AI PC"不再是给旧电脑加个Copilot,而是直接把128GB、512GB统一内存端上桌。对一直蹲这个方向的重度用户来说,真正的看点不是"参数好厉害",而是三本账:内存账、速度账、账单。账算清了,才知道自己是该现在上车、该再等等、还是根本不用折腾。
第一本·内存账:算力省得掉、内存省不掉,这就是桌面票的全部逻辑
很多人看到"816B跑在桌面上"的第一反应:这数字以前不是机房H100集群的活吗?
窍门在MoE。Muse Spark Open有256个专家网络,但每生成一个Token只激活约420亿参数——像一家拥有256名专科医生的超级医院,每次会诊只叫8名对口的。单Token计算量接近42B级,用的却是816B的经验库。知乎
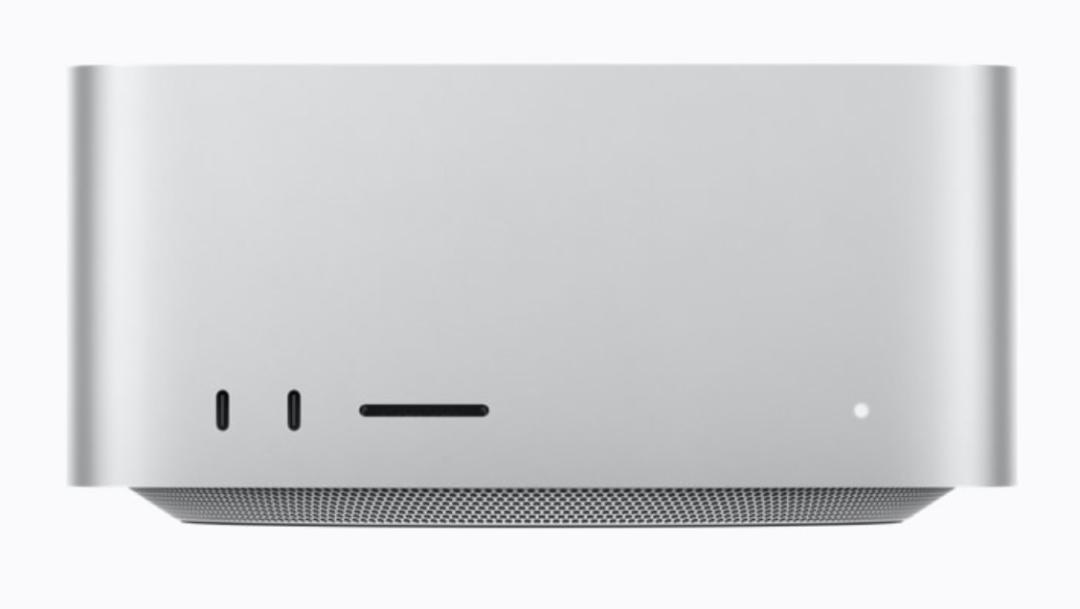
但MoE有个致命门槛:激活省得掉,权重还得全量躺在内存里。所以苹果的路子是"硬吃":两台512GB统一内存的M5 Ultra Mac Studio,用雷电5连成分布式推理集群,合计1TB内存装下全部权重。知乎
英伟达走同一条路的缩小版:RTX Spark单芯片整合最高20核Grace CPU加6144核Blackwell GPU,最高128GB LPDDR5x统一内存,1 petaflop FP4算力,本地跑1200亿参数以上的模型的门票,就是"权重+KV缓存"。 知乎那位真机答主用NVIDIA开源的Flare框架在DGX Spark上跑Qwen3.8-Flash-Next,整个推理包106.9GB,其中26.8GB的n-gram表被强制挪到磁盘上、每步按需读几行进内存——内存在这里是一滴一滴挤出来的。智东西知乎
这本账的另一面也得画出来:Kimi K3公开参数2.8万亿,就算4-bit量化,光权重就要约1.4TB,再算运行开销,1TB的集群到顶了。而微软发布会秀的另一端是:284B的DeepSeek-V4Flash用1.6-bit量化只要60GB内存,70B级Nemotron用2-bit量化只要略高于20GB——这两个是厂商自报数字,但指向同一个趋势:量化的刀越挥越快,内存门票线每年都在往下掉一档。36氪智东西
小结:这一轮"桌面大模型"不是算力突然变强,而是MoE架构、超大统一内存和极限量化刚好凑齐了时间点。你买的不是算力,是内存。
第二本·速度账:273GB/s是没人提的天花板,本地速度不是用来"赢云端"的
内存账回答"能不能跑",速度账回答"好不好用"。
DGX Spark官方标称统一内存带宽273GB/s。解码阶段,每生成一个Token都要把激活的权重重新读一遍,单流速度基本被带宽锁死。知乎
真机答主的实测数字很直白:Flare默认配置(adaptive MTP)单流只有34—41 tok/s;关掉adaptive、固定3个draft之后,单流48.8 tok/s,两路并发聚合76.8 tok/s。知乎
苹果那边,四台Mac Studio并联推理的官方成绩是"生成速度超过36 Token/秒"——厂商测试口径,第三方复测还没铺开。微软宣称对上一代MacBook Pro做到2.1倍首token时延效率、4.3倍图像生成、6.2倍视频生成,同样是厂商自报,参照物还是笔记本。知乎智东西
把这些数字摆齐就能看清:这轮"桌面大模型"的本地体验是"阅读流畅的40—50 tok/s"和"勉强够用的30+ tok/s",跟云端旗舰模型的吞吐不是一个物种。它服务的场景是另外三种:Agent反复回顾上下文、跑测试的挂机消耗;AI视频创作大量"抽卡"初稿;以及断网、内网、数据不出门。
小结:别抱着"比云端快"的预期买120B端侧设备。本地拼速度拼不过,拼的是Token免费和数据不出门。
第三本·账单:4万的本、10万的迷你机、30万的集群,付的根本不是同一件事
先把目前能核实的价格全部排出来——这是刷屏帖里最少讲的部分:
设备 | 关键规格 | 到手价 |
|---|---|---|
Surface Laptop Ultra(RTX Spark) | 入门18核CPU/5120核GPU/24GB起 | 2599美元起,约合1.74万元 |
同系列顶配 | 20核/6144核/128GB统一内存 | 5899.99美元,约合3.96万元 |
国内渠道128GB"能爽跑120B"机型 | 华硕ProArt、联想YOGA Pro 15等首批 | 普遍4万上下,知乎口径4—5万 |
Surface RTX Spark DevBox(开发机) | 预装全套开发环境 | 5999美元起,约合4.02万元,11月美国发货 |
M5 Ultra版Mac Studio 512GB | 单台预计十万元以上,定价月底才揭晓 | 816B要2台起,"舒服线"4台≈20—30万 |
DGX Station for Windows(GB300级) | 748GB内存、20 petaFLOPS,本地跑万亿级前沿模型 | 戴尔/惠普今年晚些时候上市,价格未公布 |
云端这一侧则是两个相反的信号:微软本地版MAI-Code-1.1-Flash"模型缩小近80%、成本降至1/4",知乎也已经有"大模型API这轮降价,企业采购该怎么应对"的攻略文——云在变便宜;但眼下端侧机4—5万的售价里,有一部分是内存涨价撑起来的,苹果512GB的天价还只是"预计"。36氪
所以回本线没法用一条公式拍死,用三个问题自查更靠谱:
你的月API账单,是不是稳定高于设备折旧?4万级设备按三年折,摊到每月1100元上下。重度Agent用户如果月账单本来就在千元以上,把"琐碎推理分给本地、复杂任务留云端"的混合打法就开始划算了。
你的数据是不是"泄露一次的损失大于设备价"的类别?律师、金融分析师、医疗、涉密代码——这笔记的不是钱,是不许出云,本地是唯一选项。
你是不是靠"抽卡"吃饭?AI视频创作者先本地低边际成本反复生成、挑出可用片段,再丢云端出成品,初稿抽卡是三者里差价最大的一环。
三个问题答"否"的,直接用雷科技原文的让步句收尾就够体面:“日常只是做个翻译、写写文案,云端API确实是最优解”。36氪
对号入座:谁现在买,谁等半个月,谁根本不用折腾
天天烧Agent token的开发者:现在可以买。128GB的RTX Spark本已经现货开售,"本地120B干杂活、云端干大事"的混合模式已经有人跑通了。
高保密/离线刚需的从业者:买,但预期先校准:30—50 tok/s是常态,别按云端速度收货。
想替代GPU服务器的小工作室/企业:20—30万集群对比企业级GPU服务器加运维费,这本账对很多人算得过——但建议等月底苹果512GB官方定价落地再签单。
纯兴趣折腾党:先别动。真机答主自己的结论摆在那里:"通用服务继续用vLLM,Flare只拿来跑固定模型的本地agent。"目前Flare的recipe只覆盖Qwen3.8、DeepSeek V4/V4.1、GLM 5.3、Kimi K3、MiMo、Step-5、Nemotron七个家族、还锁死芯片架构——生态比价格更门槛。知乎
观望党,盯四个信号:①本月底苹果M5 Ultra 512GB官方定价;②戴尔/惠普GB300工作站的上市价;③内存价格走向,它回落,这整类机器跟着降;④1.6-bit/2-bit极限量化什么时候被第三方复测跑通——"284B只要60GB内存"一旦坐实,才是消费级显卡真正退场的时候。36氪
两家巨头掀桌,本质上只证实了一件事:"超大统一内存"正在取代显卡跑分,成为AI PC时代的新马力。而对普通用户来说,2026年要不要上车,看的从来不是发布会上的参数,是你的月账单、你的数据、你的抽卡次数,能不能刚好摊在那4万、10万、30万的价签上。