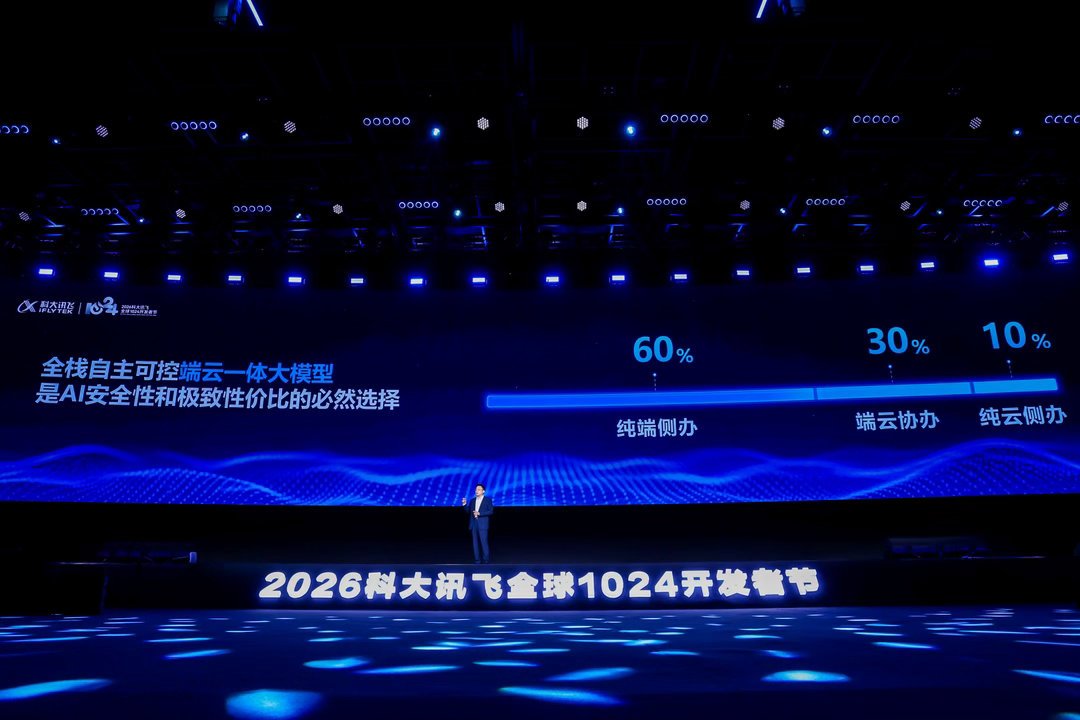
10月22日,2026科大讯飞全球1024开发者节主论坛,国家会议中心二期。刘庆峰开场没先讲跑分,先给出三个数:60%、30%、10%。六成AI任务在本地完成,三成端云协同,一成留给云端。知乎
今天正好是10月24日。讯飞每年在这个日子前后发一年里最重的版本,今年轮到星火X2.6:总参数293B的MoE,激活30B,上下文1M,全程用国产算力训练,讯飞自称"只有星火一家"。
最该对账的是定价。云端输入每百万tokens 0.9元,缓存命中0.08元,输出3.6元;端侧X2.6-4B直接开源,Apache 2.0协议,推理限时免费。知乎
定价冲着老问题来的:过去两年,企业接大模型API学到的教训是token费用跟着业务量线性上涨,量翻一倍账单可能翻1.5倍,年度预算永远画不出准线。
另一半是合规。合同、客户、经营数据再全量往公有云传,像一颗不知道什么时候炸的雷。
把六成负载挪回本地,等于把模型支出拉回企业最熟的账:一次性投入硬件和部署,后续电费、运维算得清。刘庆峰给协同段配了个数——token成本省5倍以上。知乎
"本地能跑"靠的不是架构魔法,是硬啃国产算力的短板。训练侧用长程任务动态并行,超长上下文训练效率提升4倍;推理侧在全国产设备上做四层KVCache,效率拉到4.5倍。
但芯片型号、卡数、训练时长,大会上一项没披露——"全国产算力训练"目前只有讯飞一家的口径。
全场最扎眼的数字是96.1%,端云路由的准确率:判断该本地办还是该上云,能不能判对。发布会语境里它是能力指标,企业机房语境里它是错误预算。
拿它算笔账:日调用100万次,3.9%的分流错误就是每天约3.9万次,而两个方向代价不对称——敏感数据误上云是事故,复杂任务误留本地是体验差。
"数据不出端"因此不是二元开关,是一条持续被判定的概率线。60/30/10眼下也是设计意图,不是实测流量;讯飞称端侧可独立完成任务的占比从12.8%升到40%以上,但没给统计口径。
想抄这本账的企业,第一个问题不该是跑分,而是跑在哪几种卡上、分错了谁负责、多久能发现。知乎
当然,讯飞不只是在算云账单。SparkAudio 1.0把识别、翻译、语义理解、说话人分离、情绪识别装进同一个语音基座;新发布的AI录音环用4+1环形麦阵,2小时录音2分钟转写。知乎
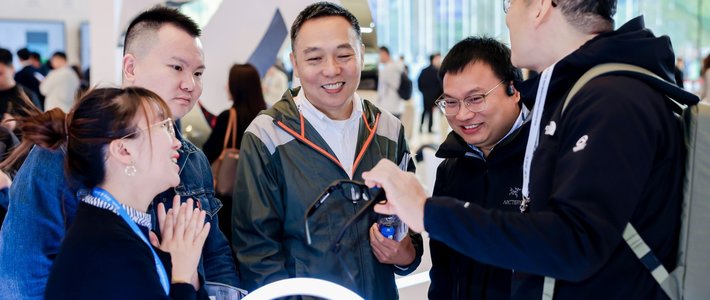
业务载体是星帆WinWork数字员工平台,讯飞称靠端云分流能省44%的token消耗;再配上122种语言互译的AI眼镜、智慧座舱3.0和AIPC,六成本地任务总算有了接住的设备。
端侧算力的底座这次也摊开了:讯飞与华为昇腾打造的"飞星"平台,作为全国首个国产万卡算力底座在合肥科博展核心区展出,标称可支撑万亿参数模型训练。央视网
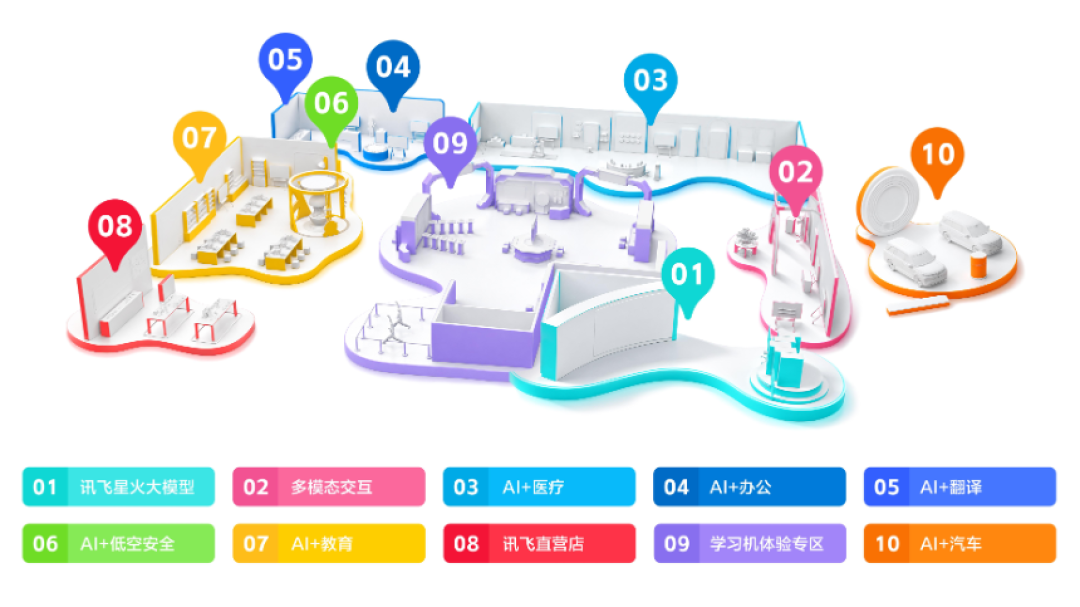
合肥主展馆约2117平方米,切成星火大模型、多模态交互、AI+医疗、AI+教育等十个展区,市民可免费预约参观。央视网
生态那头,本届大赛52120支队伍参赛,覆盖15国351城,43%的参赛者没有技术专业背景——懂业务的老师、医生、法务,也能做出能用的AI应用。知乎
第三方横评给X2.6落了个位:API响应速度与MiniMax M3.1 Flash持平,应付Flash阵营的任务够用;任务一难,推理长度就偏高,是下一版要补的缺口。知乎
这延续了讯飞近一年的节奏:X2.5九月初才把全国产算力首秀做完,隔一个多月,X2.6又刷新。知乎
大模型生意的下半场,比的不是故事谁讲得大,是谁能把客户的账算清。讯飞在1024摆出来的是一本肯算的笨账——对账就要两头都看:对得上的价签和开源,对不上的跑分自述、算力黑箱,还有那3.9%的错误预算。