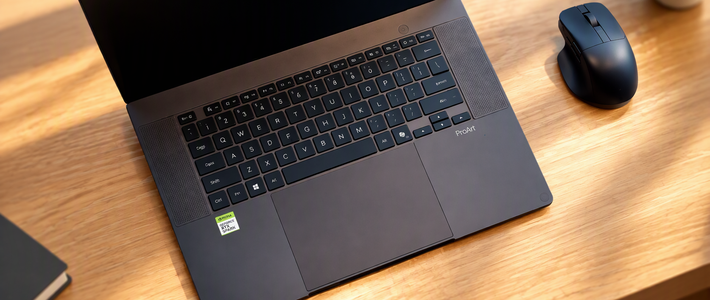
10月16日开售那天,128GB版的华硕ProArt创16标37999元,线上瞬间抢光。同一批货里的32GB版ProArt创14,评论区有人说京东挂着18000元"一直显示有货"。微博
同一颗芯片,两种命运。半个月过去,首批实测评测陆续解禁,账终于能算了——而结论跟"128GB能装下大模型"这句宣传语,方向是反的。
装得下,不等于跑得快
RTX Spark用的是NVIDIA和联发科合研的N1X,说白了就是桌面小超算DGX Spark上那颗GB10。20核ARM CPU配6144个CUDA核心的Blackwell GPU,评测用的华硕ProArt创16满配版是128GB统一内存加1TB固态。华硕、戴尔、惠普、联想、微软、微星首批一起上,全球2599美元起、国内18999元起。但真能跑大模型的128GB满血版最低要35999元,联想YOGA Pro 15配2TB则要42999元。知乎知乎微博微博微博微博
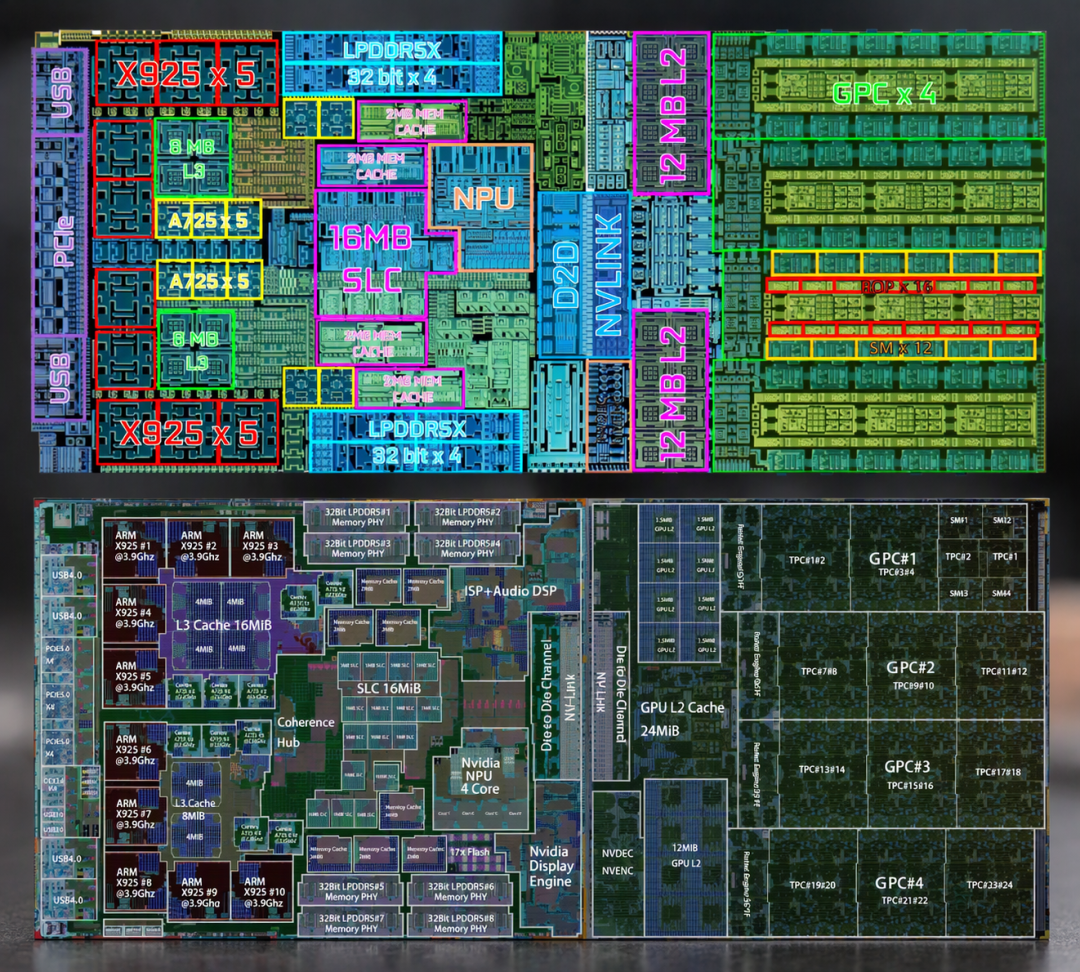
128GB LPDDR5X统一内存听着很唬人,可关键数字是带宽:300 GB/s,还不到桌面RTX 5070那672 GB/s的一半——而5070只有12GB显存。容量赢十倍,带宽输一半。知乎
拧巴的地方就来了。跑Qwen3.8-27B的BF16原版,权重55.6GB,划80GB显存轻松装下——然后实测只有12.5到15.4 token/s。装是装下了,可读不快,每个字都得等内存慢慢搬。本地AI的第一瓶颈从来不是容量,是带宽,这句话在Spark身上被放大到刺眼。知乎
救场的是个额外吃3GB的"小抄"
转机在软件。同一个27B模型、同样256K上下文,打开DFlash2投机解码之后,速度直接冲到63.8–75.1 t/s。原理就是小模型打草稿、大模型集中批改:以前27B每吐一个词都要把全部权重读一遍,全卡在带宽上;现在小模型一口气往后猜7个词,主模型读一次权重就批量核验完。知乎
去掉测试探针里重复句带来的高命中加成,日常真实文本大概稳在36–45 t/s,体感约是原来的三倍。另一位拿到联想YOGA Pro 15的测试者独立跑出60.8 t/s,方向一致。知乎知乎
代价是这个草稿模型额外吃3GB显存,在128GB的Spark上连零头都算不上,可换到消费级顶卡RTX 5090 D v2就完全行不通——24GB扣掉系统开销和模型权重,再塞3GB草稿,KV cache已经没地方放了。不加载草稿硬抗,5090确实能跑50–60 t/s,可上下文只能压到64K Q8;Spark能把256K拉满,还能上F16精度,实测反倒比Q8略快一点,因为省了反量化还原那一步。所以128GB的真正用处,不是装下更大的模型,是给加速腾出余量。只盯着"能装多少参数",这笔账从开头就算错了。知乎
ARM转译不背这个锅
第二个该纠正的担心:Windows on ARM跑AI,掉不掉性能?实测答案是不掉——GPU的RT Core底层性能,ARM64原生和X64模拟只差0.2%。CUDA核心的FP32、FP4算力,两种架构也完全一致。原因很直白:发给GPU的是GPU原生指令,CPU那边是ARM还是转译,跟它没关系。知乎
该担心的是别的:游戏内核级反作弊驱动、没移植的专业软件,骁龙X Elite当年就栽在这两堵墙上。CPU本身也不弱,N1X最高频率只有4GHz,单线程成绩却高过跑到5.5GHz以上的桌面x86旗舰。
生态补得也不算慢:微软在上市首日就给了Windows on Arm原生的PyTorch-CUDA版本,官方称支持97%的热门Python软件包。NVIDIA还备好了迁移页面和"本地AI模型选择器",输入GPU型号直接吐推荐模型、精度、命令行和预期速度。36氪
油管评测的汇总结果也挺反直觉:读长文档、跑智能体、本地生图,RTX Spark更快;生成速度、剪辑、续航,M5 Max领先。分界就在prefill吃算力、decode吃带宽,而Spark的FP4稀疏算力接近1 PFLOPS,正好压在前一环。哔哩哔哩
一个买前必须知道的坑
Spark砍掉了DGX Spark上那颗200Gbps的ConnectX-7网卡,后果是不能多机并联。DGX Spark能八台组网跑753B的GLM5.3,Spark单机封顶。如果你打算"先买一台、以后再添",这条路在硬件层面就堵死了。哔哩哔哩知乎知乎
显存分配也有讲究:NVIDIA App里可调4–96GB,但因为剩下的系统内存里还有16GB能当共享显存,GPU实际摸得到的是112GB。实测建议是显存小一点、内存大一点,比如80+48——显存不够能借内存,几乎零代价;反过来内存不够,借不到显存。知乎知乎
该不该买
值得考虑:需要带着走的开发者;数据不能出门的律师、金融、医疗;要跑长上下文的(256K KV自由,桌面卡给不了);要跑本地生图生视频的——MiniMax H3、Qwen Image 2.1这类瓶颈都在GPU算力上,正对Spark的强项。还有个隐藏玩法:配合NVIDIA PAIR技术,它在家能变成局域网"AI推理服务器",供其他电脑调用,一份钱摊给全家。知乎36氪
建议绕开:想组集群的,加钱上DGX Spark;主要打游戏的,x86游戏本更省心。预算敏感的可以看看华硕ProArt创13(AMD 395加128G),比它便宜一万五,还是完整x86生态。而只是聊天写文案的,云端API仍是最优解。哔哩哔哩
至于32GB版——它存在的意义,大概就是证明128GB为什么贵。