MiniMax H3 权重放出快四十天,我数了下知乎这边 9 月 11 日到 14 日短短四天里冒出来的文章:选型实测、部署教程、架构拆解、价格分析、每日追踪,一天好几篇。B站同四天里也刷出几十条本地部署实测和教程视频,5060Ti、5080、V100 双卡都有人晒跑分。但把这些摆在一起看,第一反应是数字在打架——同样是 H3,有人说 0.1 元一秒,有人说官方 0.8 元一秒;整合包教程说 8GB 显存就能跑,第三方实测又说一张 5090 峰值显存吃到 31GB 以上;5070Ti 的博主 2、3 分钟出一条 15 秒视频,AMD 主机玩家 75W 锁功耗,出一条 5 秒小分辨率视频要 34 分钟。
先把一句话结论放在前面:这些数字没有一个是假的,它们只是四把不同的尺。H3 不是一个产品,是四张账单——官方 API 一张、聚合转售一张、你的显卡一张、白嫖云 GPU 一张。接哪张,取决于你是哪种人。
先拆参数口径,不然后面的账全算错。 很多人说 H3 是"33B 视频生成模型",但知乎上做架构拆解的作者照着 HF 模型卡和 config.json 重新核过:33B 只指核心去噪网络 H3-Omni-Transformer;把 32B 的 Qwen3-VL 编码器和两套 VAE 全算上,完整推理栈在 65B 量级;反过来,33B 里约 13B 属于可预计算缓存的 AdaLN 分支,纯推理根本不加载,去噪循环常驻的只有约 20B。 所以同一个模型,"多大"取决于你问的是哪一层——“8GB 能不能跑"和"30GB 都不够"这两个说法,差的就是你把编码器放哪、量化到什么程度、生成什么分辨率。那位拆解作者还给自己立了个规矩:模型卡没写的都标"推断”,这个自律在社区解读潮里不多见,他的数字也最值得引用。知乎
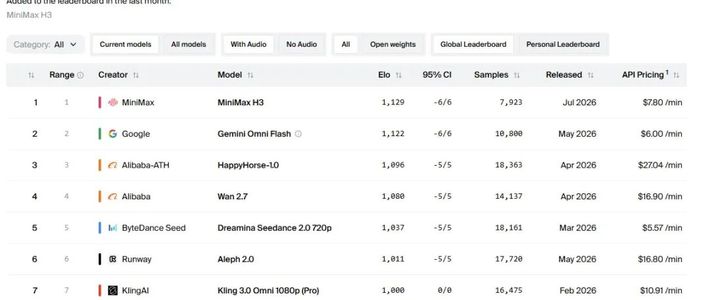
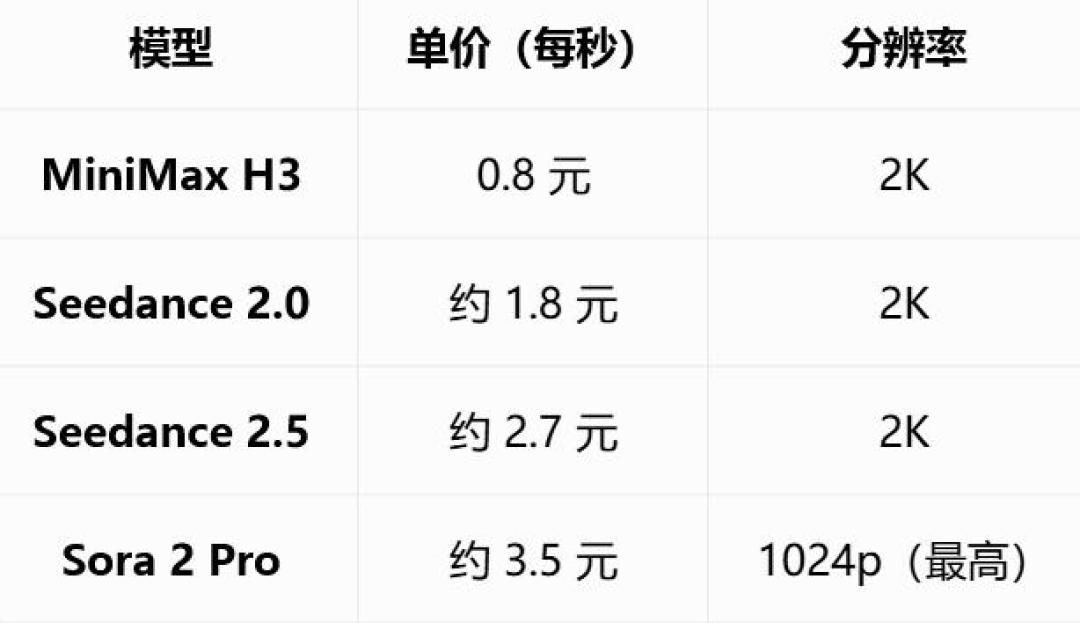
第一张账单:每秒单价,同一个 H3 至少有四个口径。 发布当天(8 月 3 日)官方口径是默认 2K、每秒 0.8 元,支撑低价的底气是 H3-VAE 把序列长度省了 4 倍。 发布当日它在 ArtificialAnalysis 视频榜单的"带音频视频编辑"项就排到了全球第一。而到 9 月 11 日知乎上做价格分析的作者口径,API 约 0.6 元一秒,横着比:即梦会员价约 0.24 元一秒,Seedance 2.0 Mini 限时约 0.2 元,Seedance 2.0 Fast 约 0.56-0.6 元。 两把尺其实对得上:2K 档 0.8、768p 档 0.6,一条 30 秒视频,光生成环节就是 6 到 18 元的跨度。36氪知乎
但市面上还有两个更低的价格:0.1 元一秒来自聚合平台的集成报价,原作者自己都注明这是平台集成后的对外口径、以官方为准。 第三方折算 $0.08/秒(768p)、$0.13/秒(2K)这组数,做每日增量追踪的作者明确提醒不要把第三方价当作官方数据。 这轮最该记住的不是"哪家便宜",而是问价的时候先问三个词:什么分辨率、含不含音频、是官方价还是转售补贴价。知乎知乎
第二张账单:本地部署,三条路线各有各的坑。 白嫖路线,Kaggle 双 T4 共 30GB 显存,教程作者用量化模型把 Qwen3-VL 编码器剥离到第二张卡、主卡专心扩散采样,内置 OOM 自动降分辨率重试,一条简单视频约半小时起、超过 5 秒或高分辨率再慢两倍以上——文章里"九个账号一晚出 54 条"的玩法是拿免费额度当产能,听听就好,别真当方案。 自有显卡路线,5070Ti 16G 的博主用社区加速版本跑 15 秒约 2、3 分钟,1664×928 约 5 分多钟。 注意这个 2、3 分钟来自 SageAttention、LightX2V 四步 Turbo 这类社区加速包口径,同门 5060Ti 的未加速实测是 480P 视频 8 步 11 分钟、20 步 31 分钟。 做预算时千万别把加速包的数字当成默认体验。知乎知乎哔哩哔哩
8GB 显存加 16GB 内存跑通最低流程,是整合包教程给出的最低运行要求,只适用于最低分辨率档;而每日追踪记录到社区仍有 Diffusers 推理失败的 issue #4,"8GB 可玩"不能当成门槛结论。 怪硬件路线,AMD Ryzen AI Max+ 395 锁 75W,864×480 的 5 秒视频耗时 34 分钟——能跑,但没有产能。知乎知乎
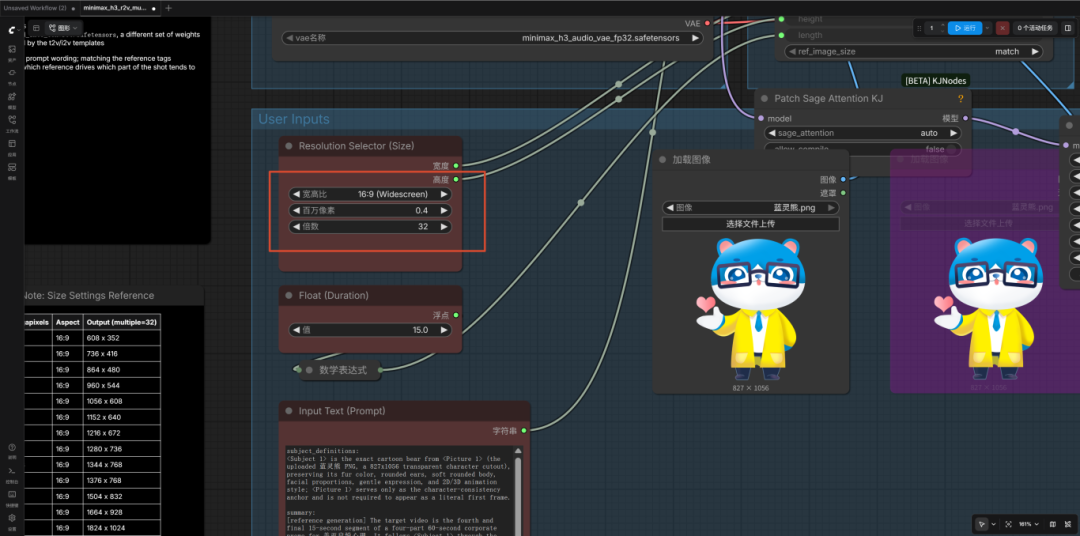
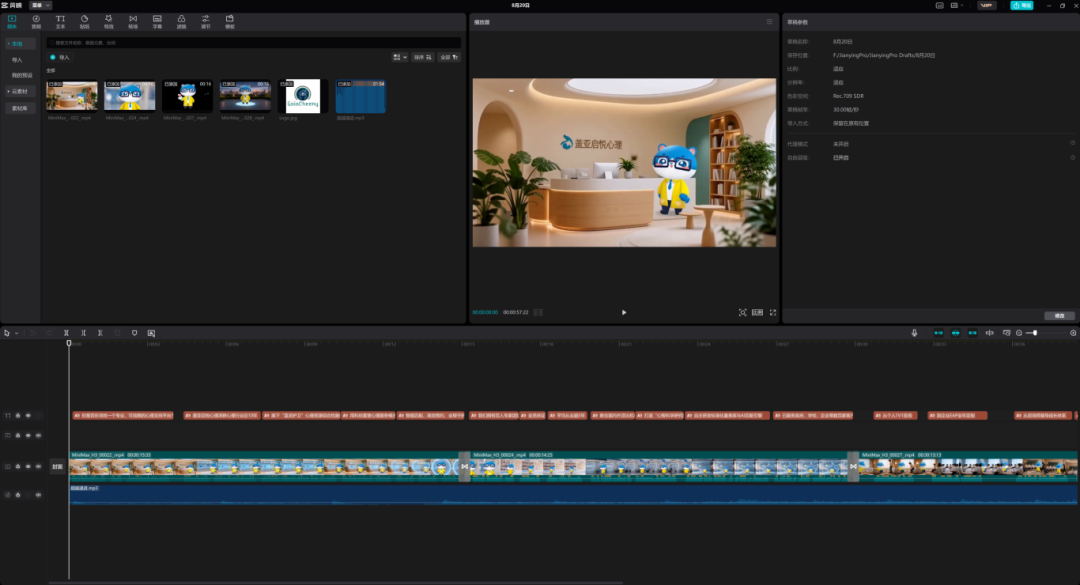
第三件事:本地跑不到的东西,才是这轮真正的分界线。 官方 2K 走的 H3-Regenerate-2K 没开源,本地默认输出短边只有 768;单段最长 15 秒,长视频全靠续写拼接——做一分钟片子的标准动作,就是在 ComfyUI 里跑四段再进剪映对时间轴;权重挂的是 MiniMax H3 Community License,商用的先逐条读授权条款。而官方 API 最值钱的能力——文本、多张图、参考视频、伴奏音频一次喂进去,参考上限是图 ≤9 张、视频 ≤3 段、音频 ≤3 段、总文件数 ≤12——复杂文字贴合物体透视不崩、提示词即台词音画一次出。 这种生成完自带配音的体验在本地量化版上是打折的,别拿"开源=白嫖官方同款"去做预算。知乎知乎
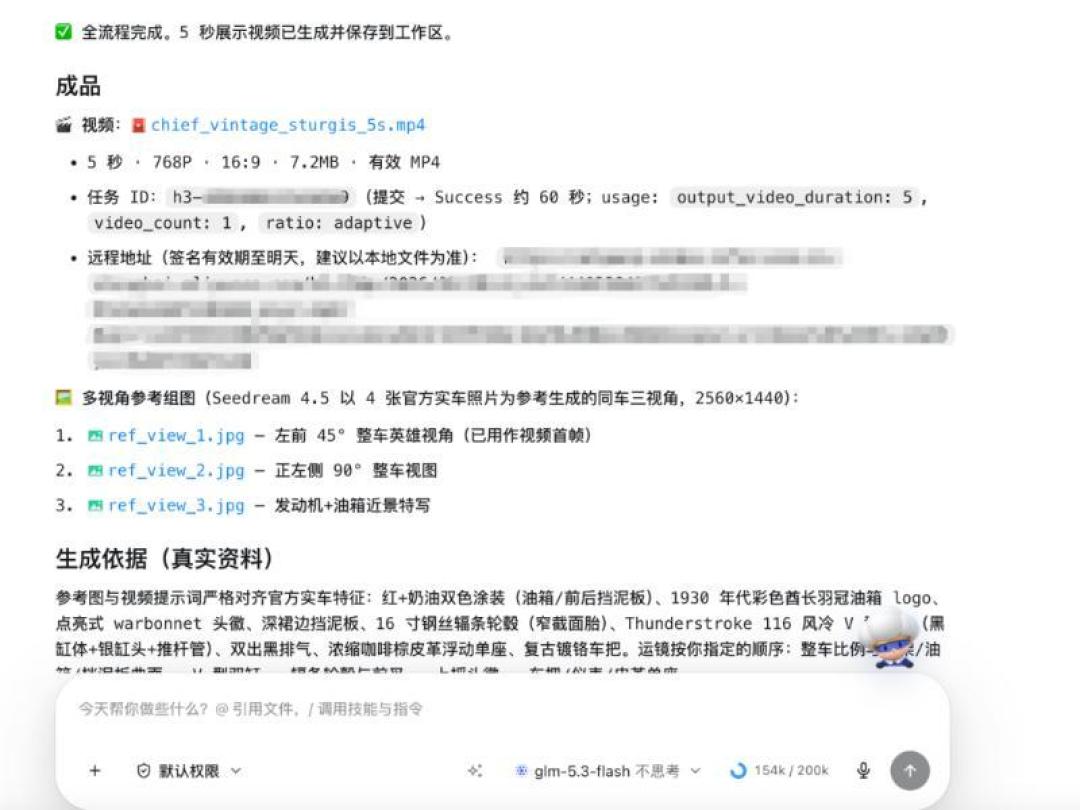
按人群分一下账。 没有显卡、只是想试水内容产出的,先用官方 768p 档跑,一条 5 秒 3 块钱,比任何本地折腾都便宜,别被 0.1 元的转售话术直接吸走,先问口径——账单字段里时长、比例、条数怎么计,决定了你看到的是哪把尺。有 16G 级显卡、要批量出口播类素材的,本地部署确实到甜点位:官方跑一条 15 秒要 9 到 12 元,本地只花电和时间——但前提是你的出片量能摊平废片率,一天三五条的,API 更划算。要 2K 商用的,老老实实走 API 或 H3-Max:聚合平台的实测口径是 H3 出片稳、H3-Max 快但分辨率更低。 其中"5 秒视频 1.653 秒生成"出自平台方文章,听听就好。只有 8G 小卡的,等社区把低显存量化方案磨完再动手,评测报告自己也承认这是待补的短板。知乎
最后留几个继续观察的信号:9 月 14 日官方仓库的 GitHub 搜索快照是 7922 stars、30 个 open issues,做每日追踪的作者给出的判断和我对完全网后一致——工具链采用信号强,真实生产采用还量不出来,HF 下载量、官方调用量都没有稳定可核验的数据。 已经值得注意的趋势是衍生:9 月 14 日有团队基于 H3 架构做了 32B 的统一视频模型 LynnReal-Omni,Flash 版在单张 H100 上 540p 短片生成加解码只要 377 毫秒。 开源这轮先赚到的其实是生态位。你的卡、你的出片量、你的分辨率要求,决定你该拿哪张账单——这轮 H3 本地化,真正不该花的钱,是为"8GB 可玩"这种口径提前格式化的那块硬盘。知乎知乎