跑训练的人都有这个时刻:终端里 `nvidia-smi` 的 GPU-Util 常年顶在 100%,卡看起来"满负荷",可 step time 就是降不下来。你开始怀疑卡不行、租的平台不行、并行策略不行,钱包和时间一起流血。
从 9 月 14 日到今天(9 月 21 日)一周内,知乎上至少 12 篇文章、B 站多个视频不约而同在做同一件事:给"GPU 明明在忙、为什么还是慢"做诊断——《深入理解 MFU》、《GPU 为什么会"饿"》、《Tensor Parallel 深入解析:多加 GPU 为什么可能更慢》、《训练速度慢,先别急着换显卡》、《GPU kernel 调度甘特图》,B 站还有"梯度同步为什么吞掉一半时间"。单条 UGC 只会给你结论,这轮有意思的地方在于:这么多号在同一周算同一笔账,说明踩坑的人真的多,而且答案比"换卡"便宜得多。
利用率那个百分比,量的是"有没有活干",不是"干了多少活"
MFU 那篇文章把 nvidia-smi 的定义钉了出来:GPU-Util 就是采样周期内有一个或多个 kernel 正在执行的时间占比。只要有任何 kernel 在跑——哪怕是一个只点亮几个 SM 的小 kernel,哪怕大部分时间在等显存——这个数照样往 100% 走。它衡量忙不忙,不衡量快不快。知乎
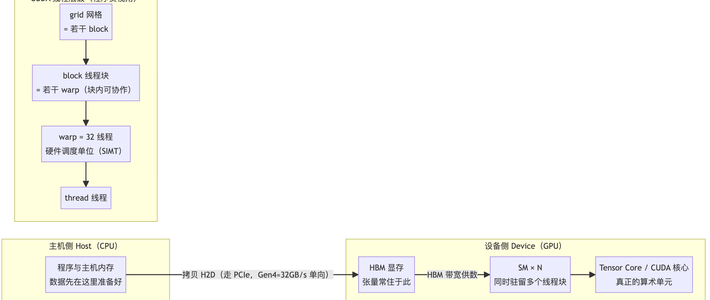
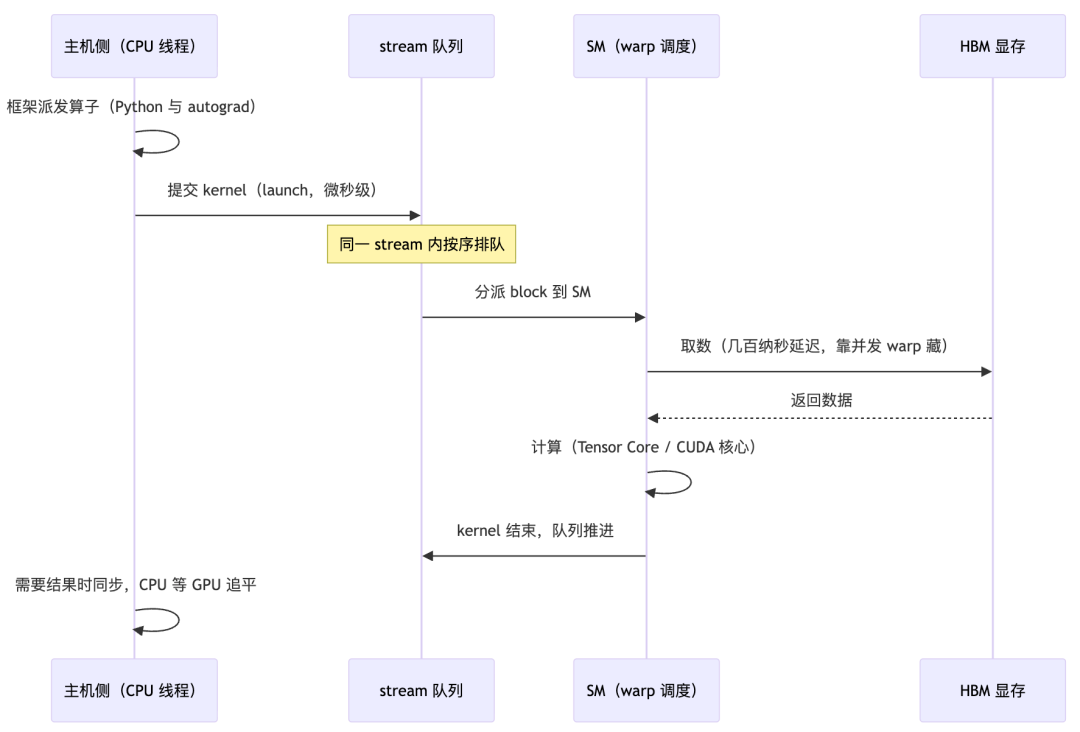
那个拿到 150 收藏的 SIMT 回答补了硬件层的原因:想把显存带宽吃满,同时得有那么多的数据在路上,在飞数据的量级就是带宽乘以访存延迟。访存受限的 kernel,SM 大面积空转,利用率却可以是满的——"忙"和"吞吐"在 GPU 上本来就是两回事。下面这张时序图就是那笔等待账:launch 提交、block 分派、取数、计算、同步,一环扣一环,每一环都有人在等。知乎
真正该算的是三层账:峰值从哪来、MFU 剩多少、时间去哪了
第一层:规格表上的峰值是推算出来的理论值。 以 A800 的 BF16 稠密峰值 312 TFLOPS 为例,来源是 108 个 SM、每 SM 4 个 Tensor Core、每周期 256 次乘加、每次乘加计 2 FLOPs、1.41 GHz,五个数乘出来。也就是说 312 这个数是硬件规模乘出来的,跟你实际训练没有任何直接关系;能兑现几成,才是你的问题。知乎
第二层:兑现率用 MFU 量。 MFU = 实际训练吞吐折算的有效 FLOPs ÷(卡数 × 选定精度的稠密峰值)。有个坑要提前知道:激活重计算消耗硬件时间、但不计入 MFU 分子,GPU 很忙、FLOPs 执行很多,不等于训练更快。判断收益永远看端到端 tokens/s。另外算 MFU 必须先说清口径:峰值必须与计算方式、精度一起说明,同一张 A800 在 FP32、TF32、BF16 下的数字差着好几倍,BF16 稠密训练就统一用 BF16 稠密峰值当分母。知乎
第三层:MFU 低,去 step time 里找"饿"的三个来源。 本周这些文章各管一段,拼起来正好是一张完整的诊断图:
等数据。《GPU 为什么会"饿"》给了供给账:1024 张卡、每卡消费 500 MB/s,存储层就要供到 512 GB/s。供给只有需求的一半时,再强的 GPU 也至少一半时间在等数据;更隐蔽的是元数据墙:大量小文件时,每秒能处理的文件数会先卡死吞吐,这时"提速"的答案是把样本打包成顺序读的 shard、抬高平均文件大小,而不是加卡。知乎
等通信。 Megatron 式 TP 每层前向要做两次 AllReduce。DDP 里真正决定迭代速度的,是梯度何时进 bucket、通信能否和 backward 重叠、finalize_backward 暴露了多少等待。计算、通信、搬运可以重叠,真正拖累你的只有没被掩盖、暴露在关键路径上的那部分。知乎哔哩哔哩
等提交。 CUDA 编程老手这周也在聊另一个高频坑:小 kernel 太多、提交慢、并行率差,物理模拟每步线性求解、LLM prefill 里的碎片化算子都中招。kernel 调度甘特图(9 月 21 日刚发的系列第二篇)就是把这段时间线画出来看谁在等谁,分析任何算子之前,先把功能单元吞吐表钉在墙上。知乎知乎
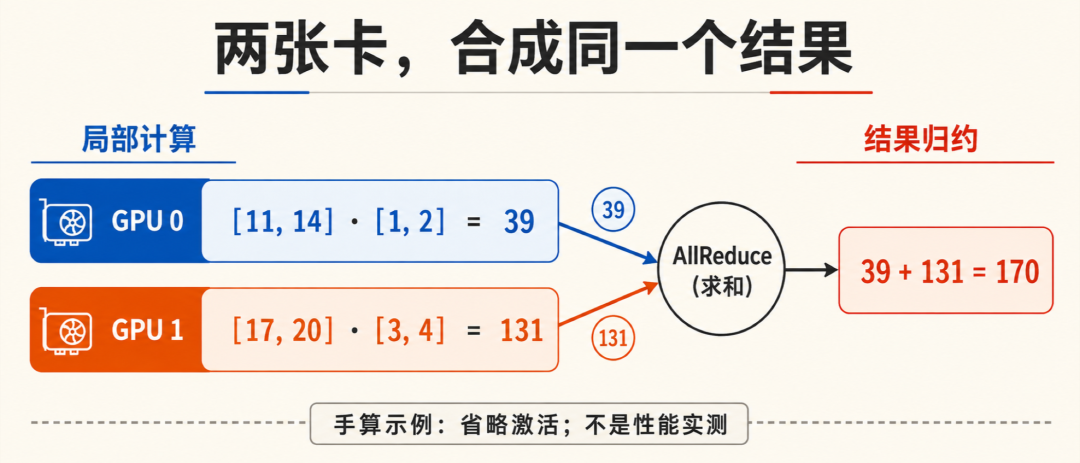
加卡不必然加速:TP 的账不能拿显存除以卡数
同周刷屏的 TP 解析文章给了个反直觉细节:GQA 模型 32 个查询头共享 8 个 KV 头,按 KV 头分片时,TP 从 8 加到 16,查询头继续摊薄,每卡的 KV 头数却不再减半——vLLM 的 QKVParallelLinear 文档明确写了 KV 头可能被复制。如果 OOM 的大头是 KV Cache,降上下文、控并发可能比继续加卡直接得多。知乎
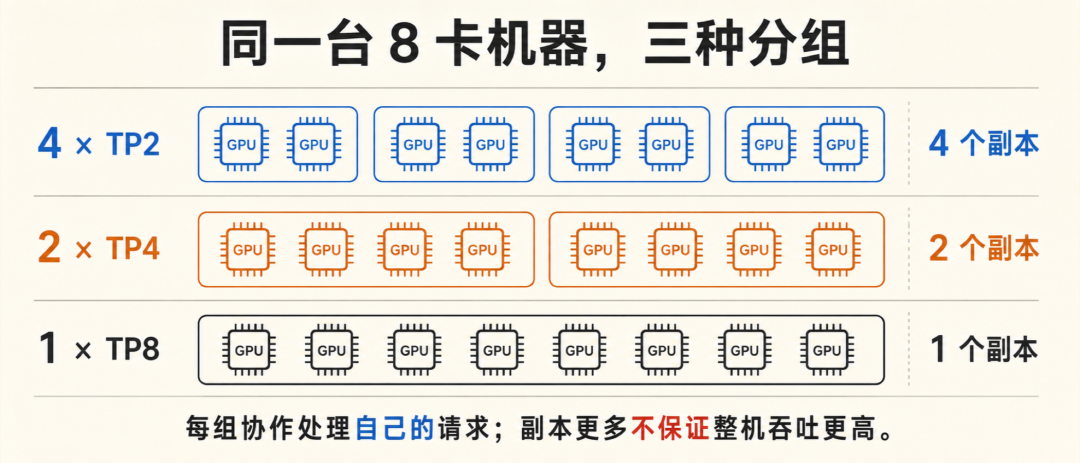
同一台 8 卡机还有第二种账:一个 TP=8 的大副本,对四个 TP=2 的副本,比的是用户等待目标内完成了多少请求,而不是某一个实例的峰值 Token/s。副本数多了,路由不均、批量变小、前缀缓存分散,未必四倍收益。知乎
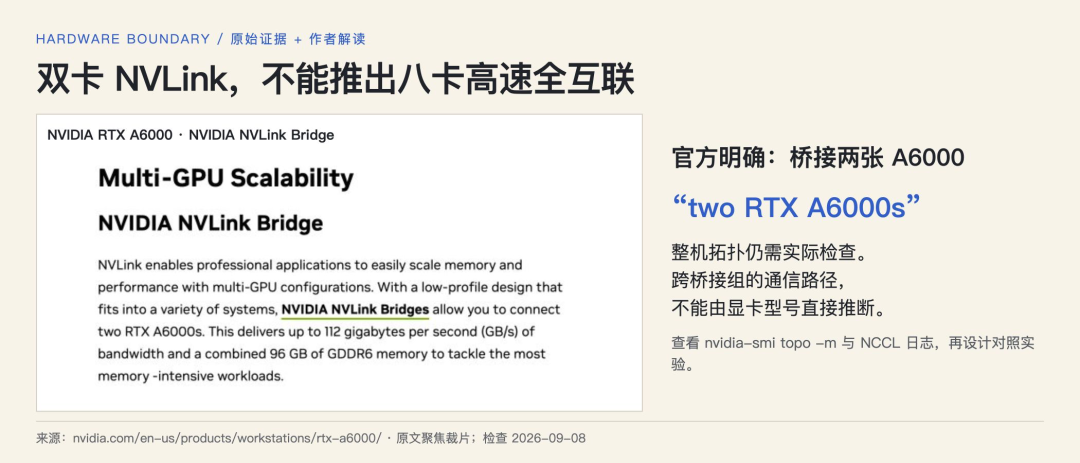
再加卡之前先跑 `nvidia-smi topo -m`:哪些卡之间是真 NVLink,哪些要跨 PCIe Switch 甚至跨 NUMA,通信组跨过快速互联的边界,每张卡算得更少、层间等得更多。结论和原文一致:先找装得下模型的最小 TP,再谈扩展。
这周值得警惕的三种说法
信号多了,噪音也多,按"谁的账"筛一遍:
"GPU 利用率提升超 3 倍"的平台案例:共享调度把整卡独占改成按需共享,利用率数字当然好看——深信服基于 Kubernetes、Volcano 与 HAMi 做的正是这种"整卡独占调整为按需共享"。但那是成本分摊的故事,如果你的负载是吞吐敏感的训练,端到端 tokens/s 和电费单才是共同口径。知乎
“利用率上不去就换更快的卡”:训练速度不理想时,最直观的反应恰恰是升级 GPU,但样本读取、解码、CPU 到 GPU 传输都发生在计算前。瓶颈在 dataloader 或通信时,换 5090 提升的峰值会被等待原样吃掉。供给账没算平之前,任何"换卡"都是把问题贵买回来。知乎
“利用率不是越高越好”:这话本身没错,真正该关注的是 GPU 是否在合适的负载下保持合理利用率。但别把它接反——低 MFU 时先找饿的原因,而不是安慰自己 100% 有问题。知乎
给你的动作清单
下次 step time 不降,按这个顺序做,全程花的是分析时间不是购卡预算:
记 tokens/s,按模型计算量(常见 6ND 口径)折算 MFU,把"感觉慢"变成数字;
nsys/时间线拆开 step:计算、通信、数据等待各占多少,重叠了多少;
等数据占大头 → 算供给速率和平均文件大小,先 pack shard、调 dataloader,再谈存储升级;
通信露出 → 检查 DDP overlap、回到最小 TP,`topo -m` 核对互联边界后再分组;
以上都算平、MFU 仍然顶不动,才轮到"花钱"这个选项。
值得继续盯着的线索:这轮讨论还在升级——kernel 甘特图系列刚写到调度层,OSDI’26 的 Syncopate(自动在 tile 粒度编排计算与通信重叠)刚被搬运进知乎,因为通信早就是大规模 GPU 工作负载里的第一等瓶颈,那是"藏通信"的下一站。监控里那个 100%,以后就让它当仪表盘上的背景灯吧。知乎