

年末硬件圈最热的话题,是滑到 4 字头的 Mac mini M6。官方发售价 16+256 要 6999 元。10 月底百亿补贴干到 4699,10 月 21 日甚至短暂摸到过 4299。"最便宜的苹果 AI 盒子"的名号响得吓人,评论区问得最多的一句却是:到底能不能跑本地大模型?知乎知乎
能跑吗?能跑,也能翻车。 翻的不是芯片,是教程很少跟你摊开的三道墙。
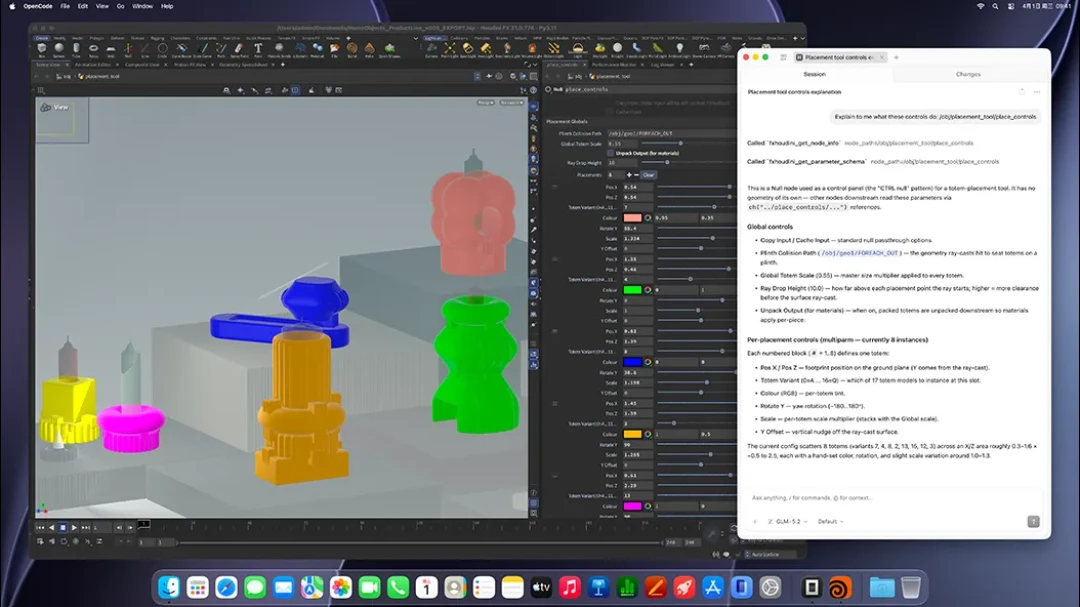
Mac 的"统一内存",是系统、模型权重、上下文缓存(KV)挤同一口锅。macOS 常驻要吃掉几个 G,16G 的舒适区就是 9B 级模型——网友实测 9B 约 23 token/s,日常问答绰绰有余;想上 14B,开始吃 swap(拿内存硬撑显存),卡到心慌。哔哩哔哩
那今年人人念叨的 27B 呢?量化之后,24G 档实测翻车。32GB 才是实用下限。而 M6 全系内存封顶就是 32GB,想跑 70B?得 64GB。哔哩哔哩知乎哔哩哔哩
第二道墙:跑分是跑分,干活是干活
苹果宣称 M6 的 GPU AI 性能比 M4 暴涨 4 倍,账面确实猛。但大模型逐字生成吃的是内存带宽,苹果规格页写得清楚:16GB 版带宽 153GB/s,24/32GB 版才是 170GB/s。丐版连带宽都没给满,32G 跑 27B 稠密模型,公开实测大多落在 10 token/s 上下。知乎哔哩哔哩
有 32G 车主买了打算干重活,结果跑 27B 做一个简单信息检索花了 5 个多小时,这条吐槽顶着 42 个赞。别拿评测跑分当预期,短上下文空机的数字,和你的日常不是一回事。哔哩哔哩
有人干脆不靠 GPU,把模型塞给神经引擎(ANE)跑:网友实测 9B 能到 45 token/s,功耗只有 GPU 的三分之一。代价是挑模型,ANE 合拍的版本才跑得动,新手慎入。
第三道墙:你可能根本不该用它跑大模型
翻车帖评论区的清醒发言反复出现:这不是跑大模型的,是 24 小时挂着干活的 Agent 盒子。2nm 带来的安静和低功耗,让它天生适合当全天待命的自动化节点——接 API 调云端模型、跑 9B 处理轻量活——这才是 Mac mini 的主场。知乎
真想本地干活,网友的方案很直接:一张 4080 Super 32G 配大内存,MoE 模型跑出 80 token/s。哔哩哔哩
那到底怎么买
只想要安静的主机 / Agent 盒子:16+512,渠道 6399 左右。256G 版硬盘焊死、读写还只有 512G 版的一半,别图便宜碰它。知乎
就想本地跑 27B 玩明白:咬牙 32G,并接受 10 token/s 的龟速和有限的上下文,别指望它替班干活。
要正经跑 70B 以上:别在 mini 上纠结,钱省下来换显卡路线或 M5 Pro。
降价是真的,但"跑大模型"多半只是个给自己找的理由。内存档位按你每天都跑的模型定,别按周末想尝鲜的那一次定。

当前文章无评论,是时候发表评论了