今年迷你主机的内卷方向变了。以前比谁更小、更便宜,现在比谁能「本地跑大模型」。
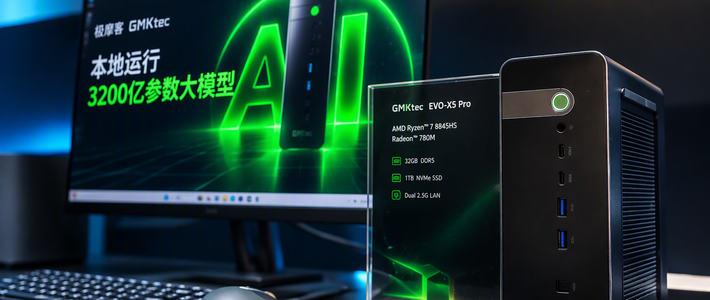
最能打的是AMD阵营的新旗舰:极摩客EVO-X5 Pro,10月初发布,把192GB统一内存塞进一台迷你主机,官方宣称4-bit量化下能完全离线运行3200亿参数级大模型,售价46999元。知乎哔哩哔哩
一台小盒子,突然就成了「桌面AI超算」。这是真本事,还是又一波智商税?
真本事一:内存就是硬门槛
玩本地大模型的都知道一句话:能不能跑,看内存;跑得多快,看带宽。
上一代锐龙AI Max+395最高128GB内存,DeepSeek-V4-Flash这种级别的模型,权重根本装不进去,连启动都启动不了。新的AI Max+ PRO 495把内存抬到192GB、带宽约273GB/s,「能不能跑」这条线直接往下挪了一档。知乎
实测也给了答案。至顶AI实验室用EVO-X5 Pro跑DeepSeek V4-Flash(Q4量化):每秒17个token,开启投机解码后提到27个;换Qwen3.8 Flash Next能到34个token/秒,首字延迟1.4秒哔哩哔哩。更轻的模型更舒服,Qwen3.6-35B-A3B直接跑出90 token/秒,已经接近云端API的输出速度。知乎
真本事二:不用运维,开机就能用
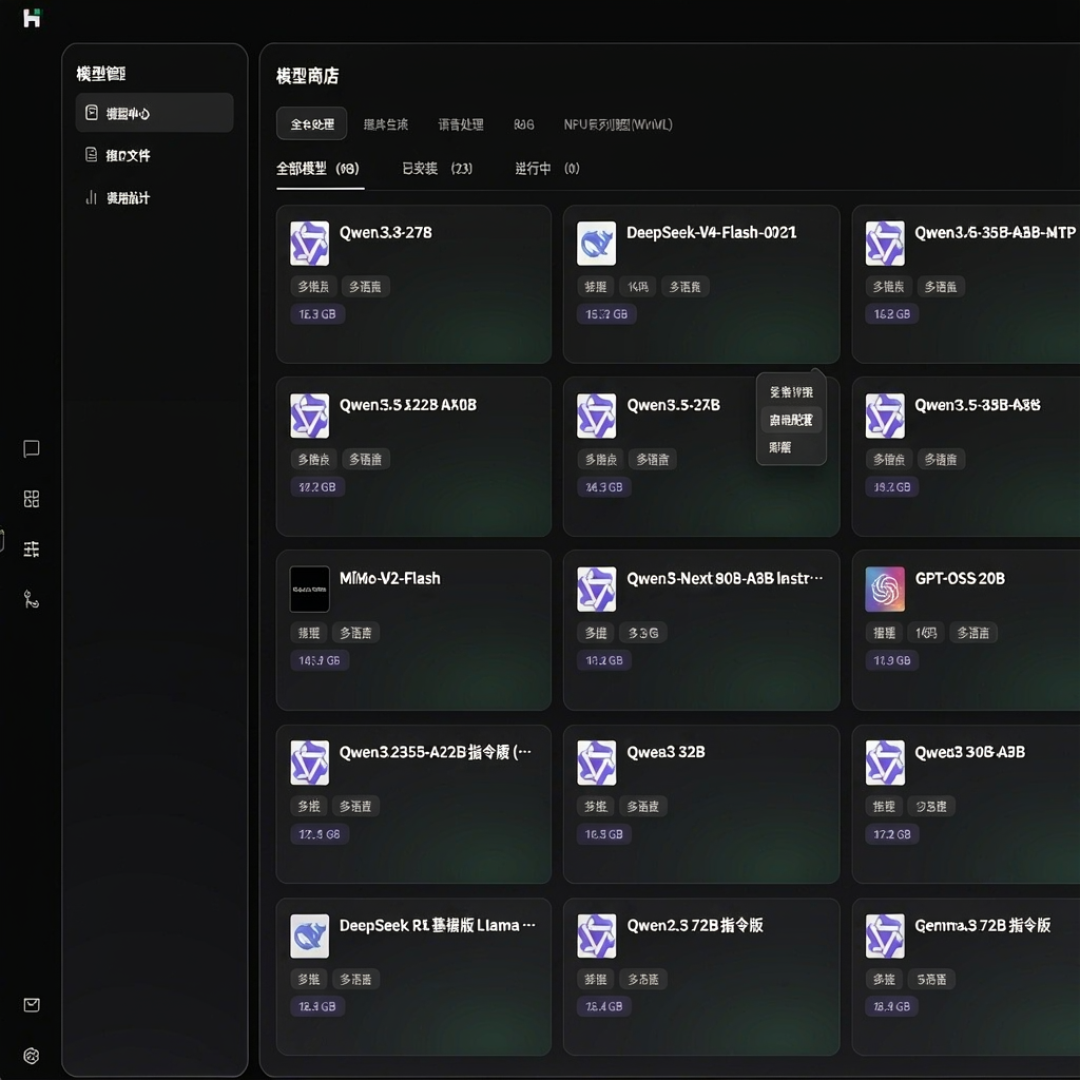
传统本地部署的流程:装系统、配环境、装推理框架、下权重、解决报错——没有半天搞不定,还未必跑得起来。EVO-X5 Pro预装了本地推理引擎,模型下载、启动、显存分配,全在图形界面里点点选选。知乎
这一点对企业是决定性的:数据全程不出局域网,不烧云端token,金融、医疗这类合规敏感行业,省下的是硬件差价之外的部署人力和合规成本。
但短板也是真短板
第一,带宽墙。273GB/s是物理现实,3200亿参数级的模型实测只有14 token/秒上下,预填慢,长上下文的首字等待需要耐心。作为对比,Mac Studio M5 Max的带宽是614GB/s,翻倍还多。知乎
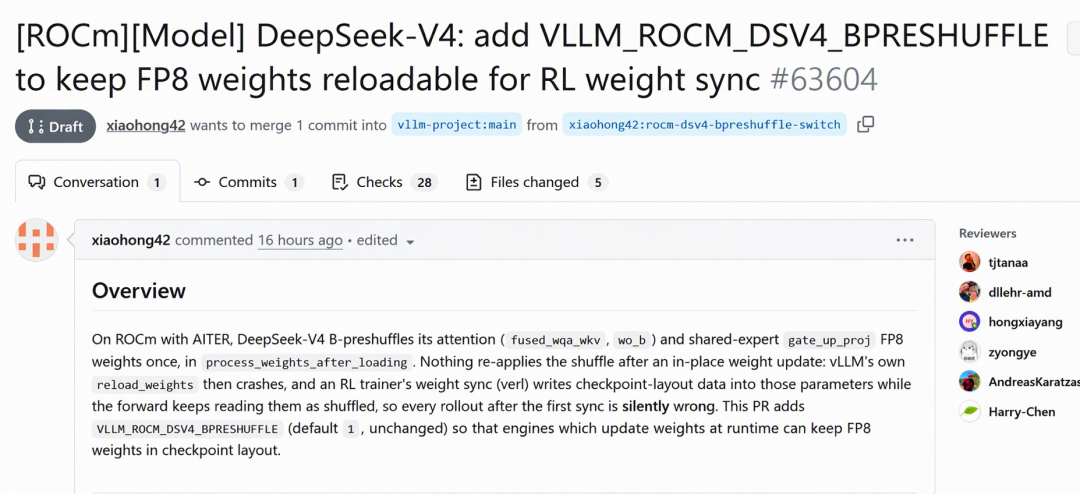
第二,生态还在补课。这套AMD平台没有原生FP8计算能力,靠软件路径模拟。vLLM在10月底刚为它写了专用kernel,算子层面提速1.7~2.54倍,但端到端只快了约6.8%,而且目前还是Draft状态——社区的判断是「等合并了,vLLM在这台机器上才算真正可用」。而NVIDIA那边,还有CUDA的先发优势。知乎
连AMD自家亲儿子Ryzen AI Halo(6799美元),都被知乎博主评为四种本地AI方案里最差的一个:架构老、算力不够、价格没优势。知乎
所以,双11这钱怎么花?
企业用户,数据合规是硬需求、不想养运维 → 开箱即用的192GB档整机,目前几乎没有平替;
极客玩家,主要跑300亿参数级小模型 → 128GB的AI Max+395机型(如阿迈奇M1A PRO+)性价比更高,等vLLM生态成熟还能白捡优化红利;
既要3A游戏又要AI → NVIDIA阵营更省心;
纯办公影音 → 别为AI交税,两千档迷你主机足够好用。
本地跑大模型的迷你主机,2026年已经走出了「PPT概念」阶段,进入「真能用」阶段。但越是这种时候越要想清楚:你买的是算力,还是刷卡那一刻的冲动?