llama.cpp 出 1.0 了,本地推理圈安静了半天——没有新功能爆炸,没有性能飞跃,就是两个版本号:llama.cpp v1.0.0 和底层张量库 ggml,11 月 13 日同步发布。知乎哔哩哔哩
玩本地模型的人都知道这意味着什么:三年半来,这个 13 万 star 的项目一直靠 b12xxx 这种 nightly 流水号活着,每次升级像开盲盒——会不会编译不过、加载就崩,全看运气。现在版本号变成了一句承诺:破坏接口升第一位,加功能升第二位,修 bug 升第三位。第一位不动,你原来写的代码照常跑。知乎知乎知乎知乎
但有个反直觉的地方:1.0 不是"冻结",是"开始讲信用"。规矩管住的是 include/ 目录下的公共 C API;命令行参数、llama-server 的 HTTP 行为、Web 界面并不在这张表里。维护者把话挑明了:以后主版本反而可能跳得更勤——因为每次破坏性改动都必须提前挂到版本号上打招呼。知乎
对拿 llama-server 自己起服务的人,升级有三个真会踩的坑:
–defrag-thold 参数失效了。老版本遇到它只是打一行弃用警告、照常启动;1.0 直接报错退出。更阴的是它的环境变量版本 LLAMA_ARG_DEFRAG_THOLD:不报错、静默失效,写在 docker-compose 里看起来一切正常,其实已经不起作用——再配上容器自动重启,就是"我什么都没改,服务却无限崩"。知乎知乎
服务挂局域网、开了工具/MCP 又没设密钥的,现在直接拒绝启动。三个解法:加 --api-key(推荐)、绑回 127.0.0.1、或显式加 --allow-unauthenticated-tools(只建议完全隔离的实验网)。
要读 NAS 或内网图片的,记得加 --media-allow-private-urls。
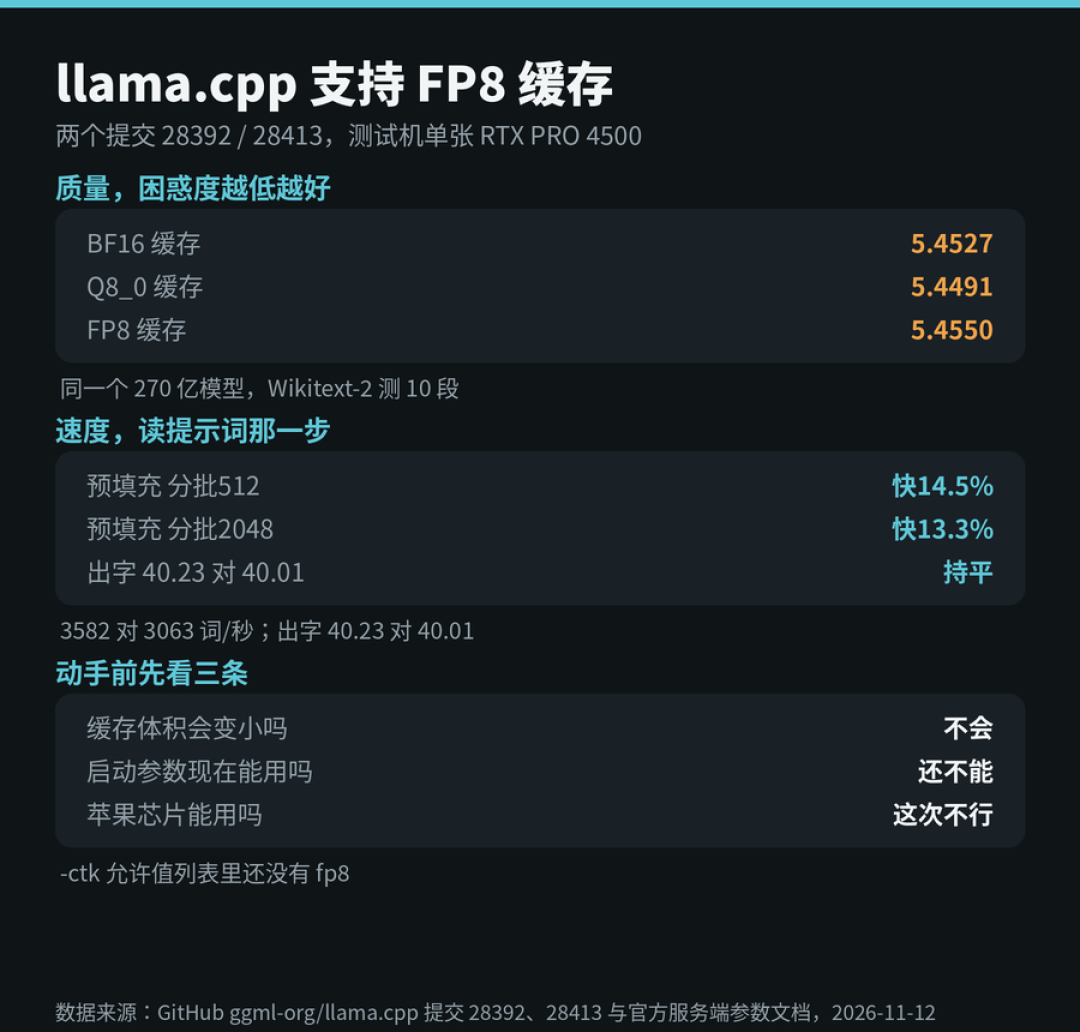
顺带几条实际的:这版清掉了 35 个废弃函数,推测解码从扩展头文件升为标配,还新增了 OpenAI 风格的 /v1/audio/speech 接口。KV 缓存支持原生 FP8 量化(-ctk f8_e4m3 那组参数,长对话显存约省一半,目前主要是 CUDA 后端吃得到)。新模型支持里出现了 Kimi-K3.1-Pro 这类名字。知乎知乎
用 Ollama、LM Studio 这类封装工具的朋友,这次可以完全不动手——底层引擎的版本它们自己挑、自己适配。知乎
1.0 的另一半意义在生态:Hugging Face 收编之后地基砸得更稳,基于 llama.cpp 的桌面网关、"64GB 内存跑 284B"的 CPU 推理路线、千亿 MoE 消费级实测这类玩法正在批量冒出来。本地跑大模型这件事,正在从极客折腾变成"能长期用"的基础设施。知乎知乎知乎知乎
到底升不升,记住三句话:值得升,但别在主力那台上直接替;先拿测试机把启动脚本过一遍——能启动、能带图、工具调用还能用,再动真正在跑的那台;升完钉死具体版本,别挂 latest。知乎知乎