这个月早些时候,一台绿联 DXP6800 Ultra 接上 RTX 3060 Ti,把相册里近五千张照片重新跑了一遍人脸识别。核显用了 5 分钟,独显不到 2 分钟。
快了 3 分钟,代价是一个雷电显卡坞、一张显卡和一路常年待机的电。值不值,要看你接下来让它干什么,光能点亮不算答案。
先分清你要的是相册快一点,还是一台能跑模型的机器
这三种需求经常被混在一起说。相册识别是一次性的批量任务,跑完就结束;本地大模型是持续的推理,回答每个问题都要吃算力;生图和生视频更直接,瓶颈几乎全在显存。它们对硬件的要求落在三个不同的短板上,不在一条曲线的三个档位。
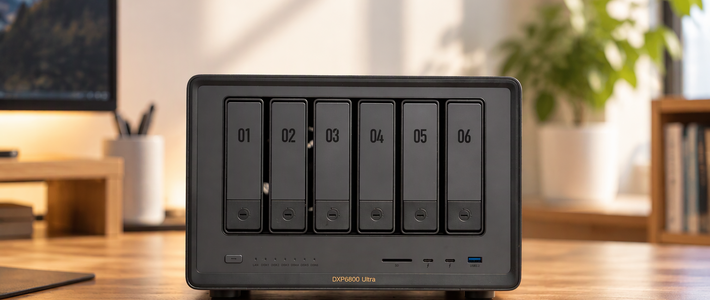
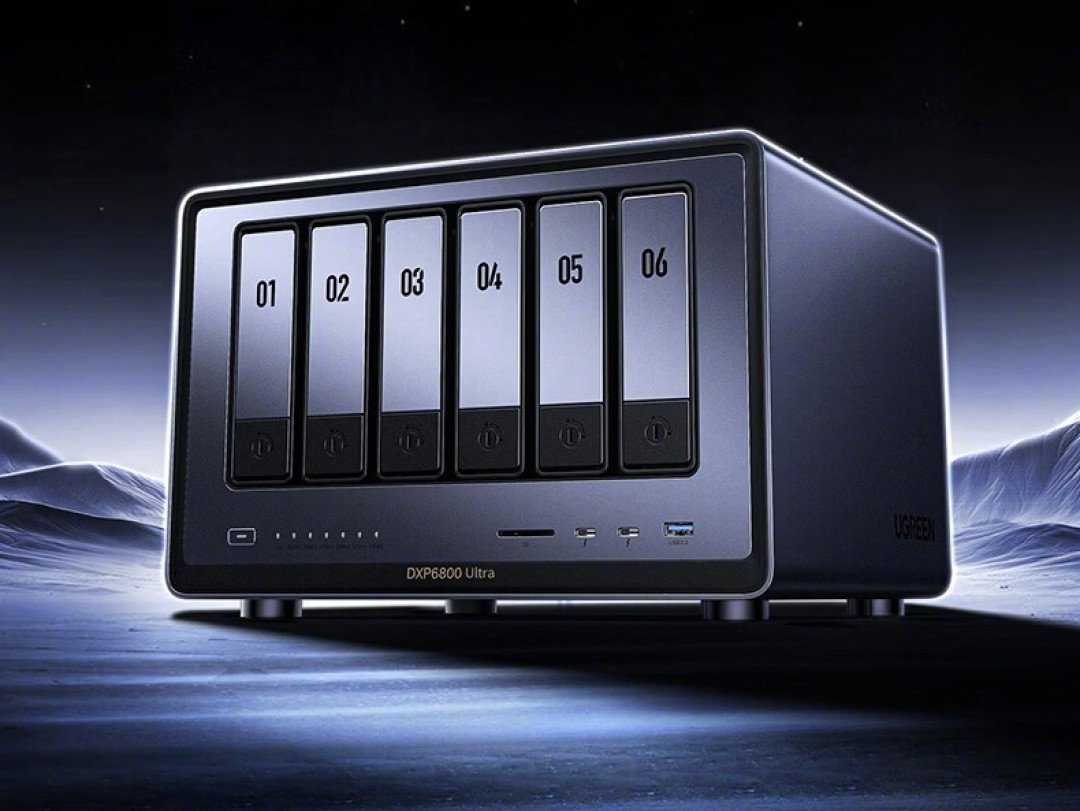
DXP6800 Ultra 的底子是酷睿 5 120U,10 核 12 线程,核显是 80EU 的 Iris Xe,标配 8G DDR5,机身里还空着一个内存槽,最高能到 96G。接口这边,两个 10GbE 万兆口,两个雷电 4,机身后侧还有一个半高的 PCIe Gen4 x4 槽,底部盖板下是两个 M.2,一个 Gen4 x4,一个 Gen3 x2。这台机器是今年 6 月上市的,六盘位加两个 M.2,官方给的整机容量上限是 208T。
把这些摆在一起,能看出这台机器的 AI 上限并不由显卡型号决定。8G 内存和一条 40Gbps 的线,比显卡更早决定你能跑什么。
核显能干的事,先别用独显去覆盖
只做相册和影音的人,最容易高估独显的价值。同一次实测里,近五千张照片的人脸识别,核显 5 分钟跑完,独显不到 2 分钟,差距明显,但不是“不能用”和“能用”的差距。换成每天新增几十张照片的日常节奏,这个差距会被摊平到几乎感觉不到。
本地模型更能说明问题。同一台机器跑 qwen2.5 的 7B 模型,纯 CPU 是 4.93 tokens/s,核显是 8.31 tokens/s,提升约 68%,同时 CPU 占用被压到 10% 以下。这个速度谈不上好用,但拿来做相册语义搜索、简单问答,已经能忍。真正让纯 CPU 模式难堪的是内存,8G 的机器在加载 7B 模型时就很紧张,模型还没开始算,内存先见底。
B站账号“阵列存储专家”给过一个更保守的结论,现阶段给 NAS 装高端 GPU 基本是浪费,系统用不上,核显才是必要的。视频里也留了一句,NAS 未来会成为家庭的 AI 节点,只是现在还不是。这个判断在“相册加转码”这个范围里成立。你要是只在这台机器上存照片、看片、偶尔让它认认人脸,加显卡的钱可以先省下来,把 8G 内存补到 32G,对日常多开 Docker 和虚拟机的帮助更直接。
雷电 4 那头,40Gbps 不是全给显卡的
外接独显这条路,DXP6800 Ultra 是少数把门开得比较宽的机器。两个雷电 4,单口 40Gbps,接一个支持雷电的显卡坞,系统里能直接识别出独显,装好驱动重启,Docker 和虚拟机都能选它。这套流程在这台机器上是通的,不需要拆机,也不占用那个 PCIe 槽。
40Gbps 换算过来是 5GB/s,这是整条链路的总带宽,分给 PCIe 的部分还要再打折,实际大约 3GB/s 出头。这个数字放在显卡上不算宽,但够不够用,要看模型放在哪。7B 模型量化之后能塞进 8G 到 12G 显存,推理时权重在显存里,走线的主要是输入输出,带宽不是瓶颈,所以同一台机器上 7B 能从 4.93 tokens/s 跑到 95.98 tokens/s,20 倍的提升是真实的。
14B 就开始变味。显存装不下,模型要分层放到系统内存,每一次前向都要通过那条线搬数据,速度会掉下来,8G 内存还会让可用的分层空间更少。生图是另一个极端,SDXL 这类模型一张图 15 秒左右,吃的是显存和算力,跟那条线关系不大;生视频更吃显存,8G 的卡跑 5B 量化模型,两秒的 480p 片子要接近 2 分钟。
这条路上绿联不是独一家,极空间 Z425 也用双雷电 4 接过 RTX 5080 做素材分析,六千多张照片、七百多条视频跑一轮,说明厂商已经把外接独显当成一个正经场景。但场景正经,不代表每台机器都适合长时间干这个活。
所以外接独显的甜区很清楚,模型塞得进显存,它就很快;塞不进,瓶颈立刻从显卡变成内存和那条 40Gbps 的线。买卡之前先想清楚你要跑的模型有多大,比先看显卡型号有用。
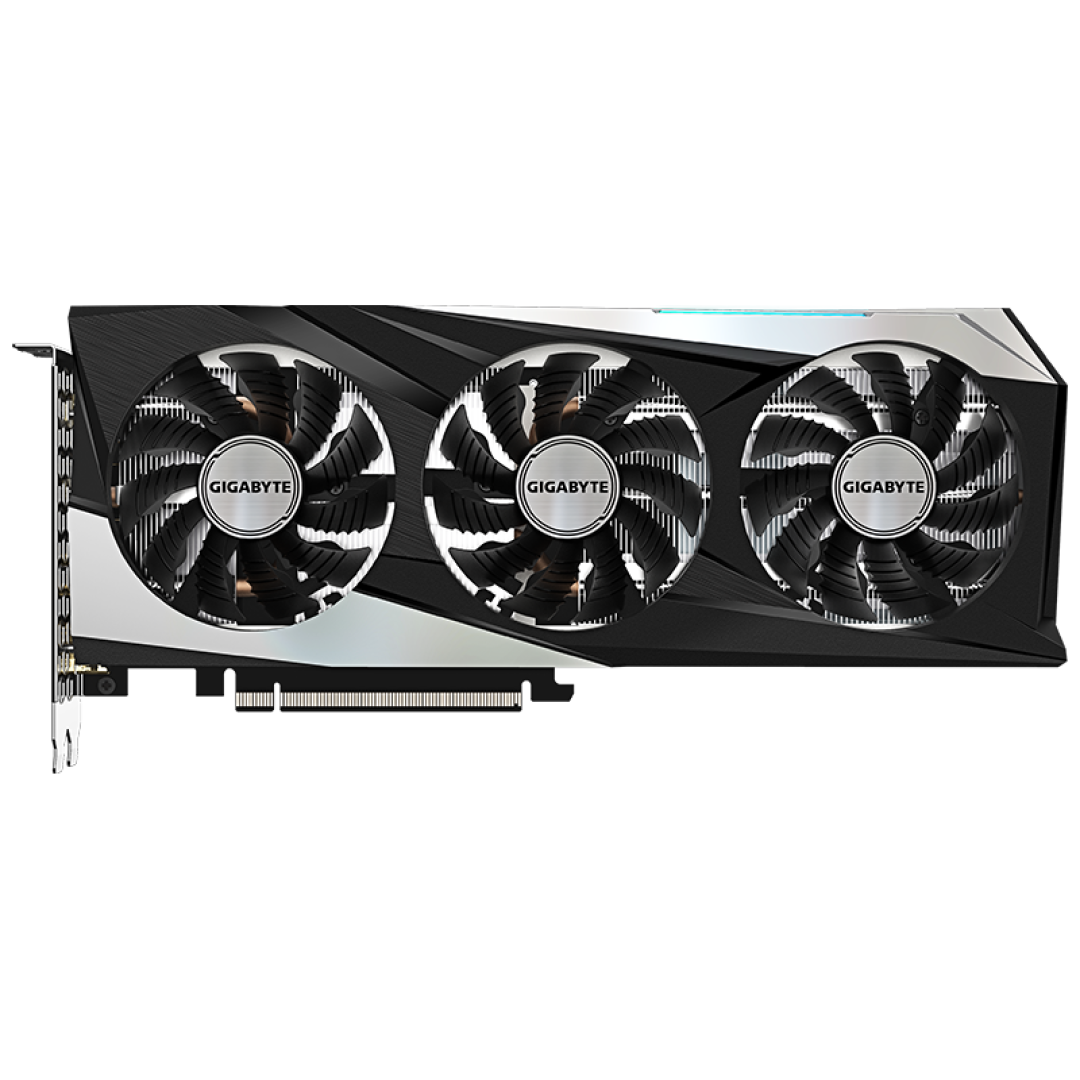
六盘位 M.2 卡卖的是盘位,不是带宽
把这张卡插进那个槽之前,先算一遍带宽。Gen4 x4 的理论上限大约是 7.9GB/s,一条 Gen4 x4 的 M.2 盘自己就能跑到 7GB/s 以上。六条盘同时满速,需要接近 47GB/s,槽只给 7.9GB/s,比例接近 6 比 1。这张卡能让你同时看到六个盘符,但不能让六条盘同时跑满。做缓存、放虚拟机镜像、给不同项目分盘,这些场景够用;拿它当六盘并联的高速池,第一天就会失望。
卡本身也有两种做法。一种靠主板的通道拆分,把一个 x4 拆成四个 x1,这种卡便宜,但只能认四条盘,而且主板要支持拆分;另一种靠卡上的 PCIe 交换芯片,六个口都能认,代价是芯片本身要供电、要散热,价格也更高。买之前问清楚是哪一种,也问清楚这台机器支不支持拆分,比看商品图上画了几个槽重要。这类卡有的要 x8 甚至 x16 的物理槽,这台机器只有一个半高 x4,卡能不能插进去、能不能按 x4 降速跑,挡板和散热片的高度对不对得上,都要在付款前确认。
板载的两个 M.2 已经说明了通道有多紧,一个 Gen4 x4,一个只有 Gen3 x2。再加上六条 M.2 的功耗和热量,这条改造的隐性成本不低。一条 Gen4 盘满载 5W 到 8W,六条就是 30W 到 48W,这些热量堆在机身后侧,风道并不是为它们设计的。机器插满六块机械盘满载时,硬盘温度已经稳定在 44 到 45℃,再加六条 M.2,机箱里的热只会更挤。
这张卡适合“我要很多个独立的 SSD 分区,但不要求同时满速”的人,不适合“我要六条盘一起跑”的人。还有一点常被混淆,外接独显走的是雷电,不占这个 PCIe 槽,六盘位 M.2 卡才占。两件事不冲突,冲突的是电和热。
真正的成本在电表和风扇上
这台机器本身的功耗不高。插满六块机械盘,休眠 27.67W,正常运行约 41.96W,满载烤机 58.14W。按 0.6 元一度电、常年不关机算,正常运行一年电费大约 220 元,这个数字对一台六盘位机器算是克制。
加一张独显,账就变了。按多出来 200W 算,24 小时满载的话每天 4.8 度电,一年电费大约 1051 元;如果只是每天晚上跑 2 小时,一年不到 90 元。拉开差距的是开机时长,不是显卡。很多人把显卡坞接上就不拔了,机器待机,坞也待机,这部分开销看不见,但会一直记在电表上。我的建议很直接,用完就关,别让一张只为偶尔推理服务的卡常年通电。
噪音也会跟着变。这台机器满载烤机时,贴近 100mm 测得 46.2dBA,主要是风扇声。同系列 6800 的用户提到过 1U 电源的底噪,说比四盘位机型吵不少。显卡坞自己还有风扇,六条 M.2 也会逼着机箱风扇提速。放在书房或卧室,这些声音会叠加。
如果你需要的是 7×24 小时不间断的推理服务,那要面对的就不只是噪音和电费,还有这台机器的定位。绿联自己在 9 月开卖了 iDX6011 Pro,Ultra 7 255H,64G 内存,标称 96 TOPS,首发 15999 元,卖点就是本地跑大模型。自己改一台 DXP6800 Ultra 加显卡坞,花的钱少得多,但得到的是一台“能跑”的机器,不是一台为长时间推理设计的机器。那条讲 NAS 要不要 GPU 的视频下面,有人一句话说得很准,“如果真想加 GPU,那说明你想要的不是 NAS,是家庭服务器”。
我的选择,三种人三种改法
只做相册、影音和文件共享的人,别加显卡。把 8G 内存补上,留着一个空的 PCIe 槽,等真正有需求再说。核显应付这些事够了,加了卡也只是把 5 分钟变成 2 分钟。
每周会跑几次 7B 模型、偶尔生图的人,雷电显卡坞是这台机器上最合理的加法。一张 12G 显存的旧卡就够,重点确认两件事,UGOS 的驱动能正常识别,Docker 和虚拟机里能选到这张卡。用完断电,别让它常年挂着。这一档的投入,先是一台显卡坞。我查到的雷蛇战核 X V2,标价 2699 元,券加国补之后到手 2204 元,这笔钱发生在显卡之前。雷电 5 的坞插在雷电 4 口上,速度按口的下限走,别为用不上的带宽多付钱。
需要 7×24 小时推理、同时跑多个模型的人,别在这台机器上叠。它只有一个 PCIe x4 扩展槽,8G 内存起步,雷电带宽也有限,叠到后面每一层都在补前一层。要么去看官方那台 AI NAS,要么单独装一台机器,把存储和算力分开。
想把 SSD 容量做大的人,六盘位 M.2 卡可以买,但要接受六条盘分一条 x4 带宽,也要接受它带来的热和电。只做系统盘和缓存,板载的两个槽已经够用,不必为了“六个盘位看起来爽”去占掉唯一的扩展槽。
NAS 加显卡这件事,买哪张卡反而是次要的,最容易错的是把“偶尔快一点”当成“可以一直当主机用”。前者是改造,后者是换一台机器。