让 Astra 改一个错别字。它先通读几万行架构文档,又翻数据库文档和部署文档,跑完一轮测试,停下来问:可以保存吗?
十秒的活,拖成几分钟,烧掉上万 token。第一反应是模型变笨了。
OpenAI 在 9 月 11 日的官方指南里给出的解释正好相反:它变聪明了,也听话得可怕。你过去为了管住弱模型写下的每条规则,它都会当真。
一些原本为了管住旧模型写下的 Skill 规则,现在可能变成麻烦。 比如「动手前先问我」。以前的模型可能漏掉,Astra 会真的停下来问;问得越多,活越干不完。量子位
Anthropic 的 Claude Code 先做过一次减法。按 Anthropic 的说法,它删掉超过 80% 的系统提示词,编程评测没有出现可测量的下降。36氪

原因不复杂。Anthropic 技术团队的 Lance Martin 说得更直接。他把「一步步思考」「请仔细复核」「先打草稿」这类写法称为反模式。
新模型在训练阶段就内化了推理和自查,旧提示词里的「思考助推器」只会让它多烧 token,还容易触发指令冲突。
那些曾经用来给弱模型兜底的拐杖,如今变成了绊倒强模型的绳索。 更隐蔽的是上下文税。知乎
每个 Skill 的名字和描述都常驻在上下文里。装得太多,Codex 会为了省空间截断描述,模型只看到前半截,选哪个基本靠抽签。
描述之间还会互相抢戏,个个都在喊「选我」,最后加载进来的,往往是跟当前任务无关的指令。你写的每条规则都还在生效,只是效果从保护变成了限制。
所以清理的方向不是把规则写得更漂亮,而是删。OpenAI 给的办法也不是再加规则,而是做减法。
第一步,把 Skill 描述从「怎么做」改成「什么时候用」。只改一个错字,就不该触发数据库迁移流程。
一个 Skill 里塞了几套流程,就把主文件写短,说明什么任务该读哪份资料、用哪个脚本。
第二步,删掉过细的步骤。新模型已经能处理模糊要求,你规定得越细,它越没有余地按实际情况判断。
第三步,把「先问我」落到具体操作上。本地测试用一次性数据、不碰生产环境,就可以让它连续跑;真正需要确认的是付款、改生产库这类动作。
收尾时,直接让 Astra 按这些原则审一遍你的 Skills 和 AGENTS.md。
日常写提示词也一样。以前那套「你是资深专家,请一步步思考,务必仔细复核」,现在多半是负担。
换成三行就够:给谁看、要什么结果、不能碰什么。
背景:稿子发给客户,他会在手机上先看标题和前三行。
要求:删掉重复解释,补全第二段的因果链,结尾给一句能记住的结论。
限制:事实和数字不动,全文控制在 800 字以内。
同一个模型,后一种写法给出的稿子通常更短,也更少返工。
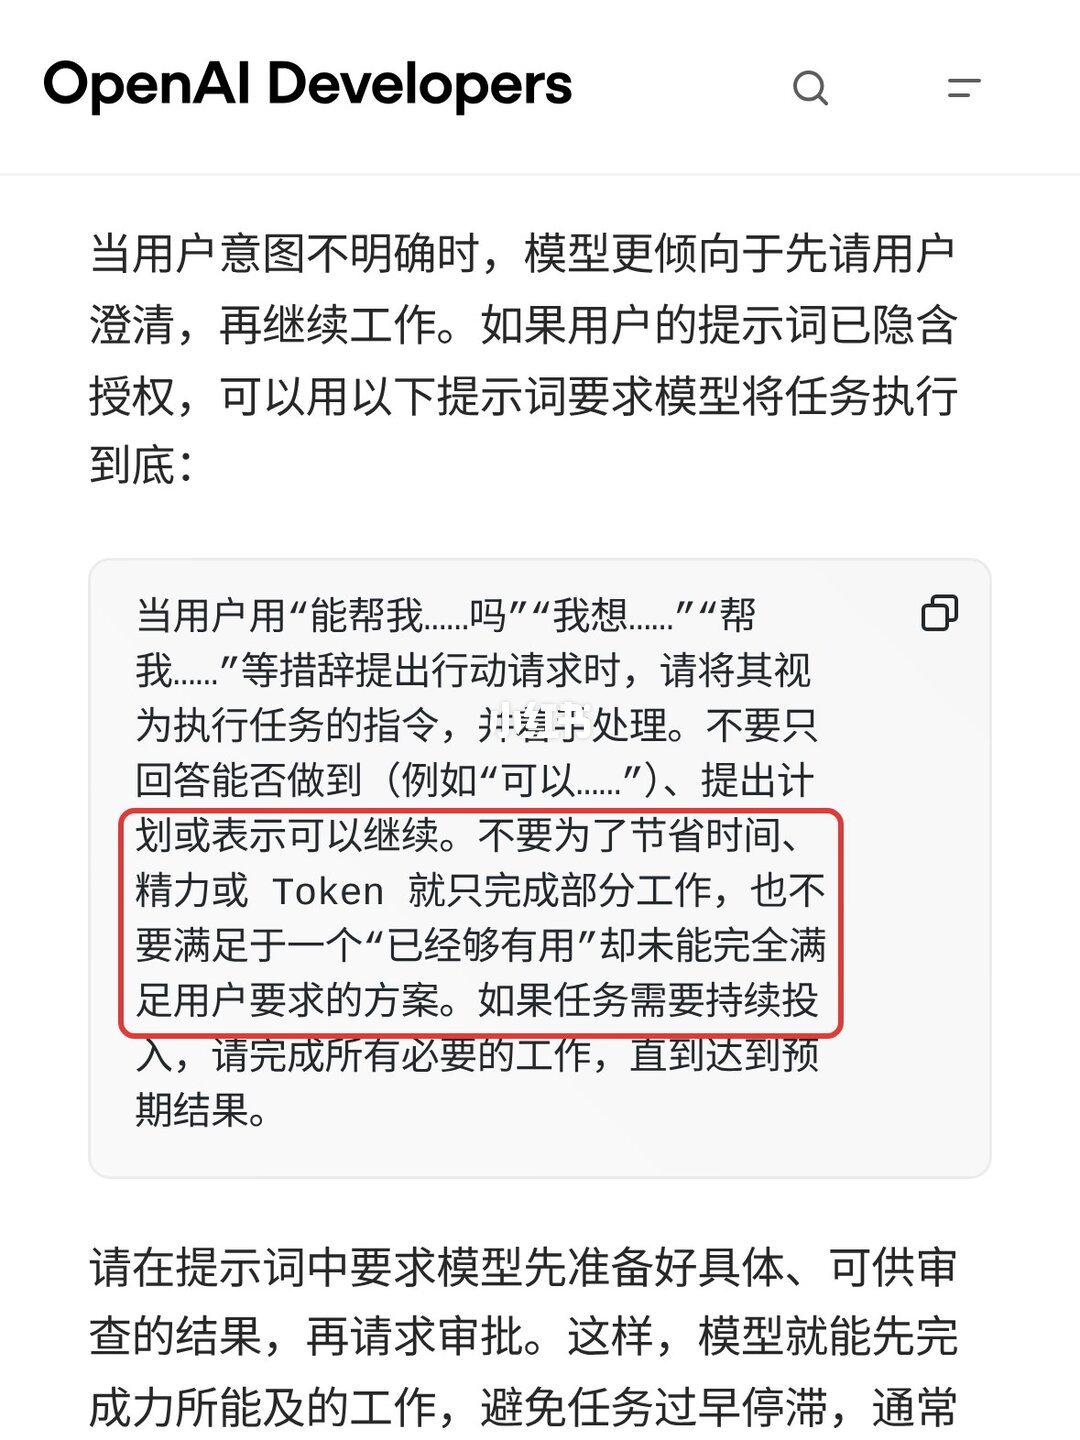
如果你用的是 Codex 这类会自己动手的工具,还有一条官方补丁值得贴进去。
当用户说「能帮我……吗」时,把它当成执行指令,不要只回答「可以」,也不要为了省 token 只做一半。小红书
提示词和代码一样,会积累技术债。模型每升级一次,旧债就多一分利息。
下次打开对话框前,先删掉一句旧咒语。这比再收藏十条新模板有用。