小红书一篇讲"8GB显存本地部署AI大模型"的笔记下面,堆着"RTX1080 显存 8G 内存32G行吗?求链接"这样的问诊,370条评论比287个赞还多。偏偏新卡行情火上浇油,RTX 5080从8000元左右的定价一度涨到接近2万、随后回落。显存不够怎么办?答案就三条线。小红书36氪深圳商报
第一条线:Q4是基准线,往下挤的不是文件,是智商
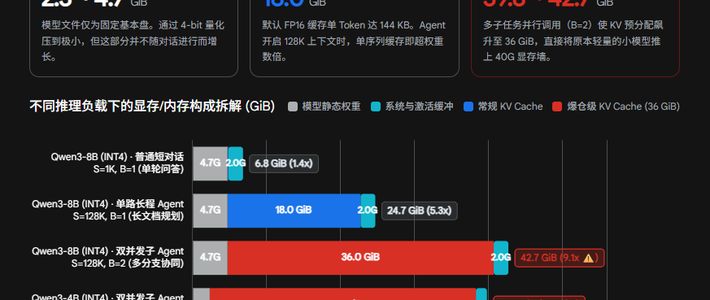
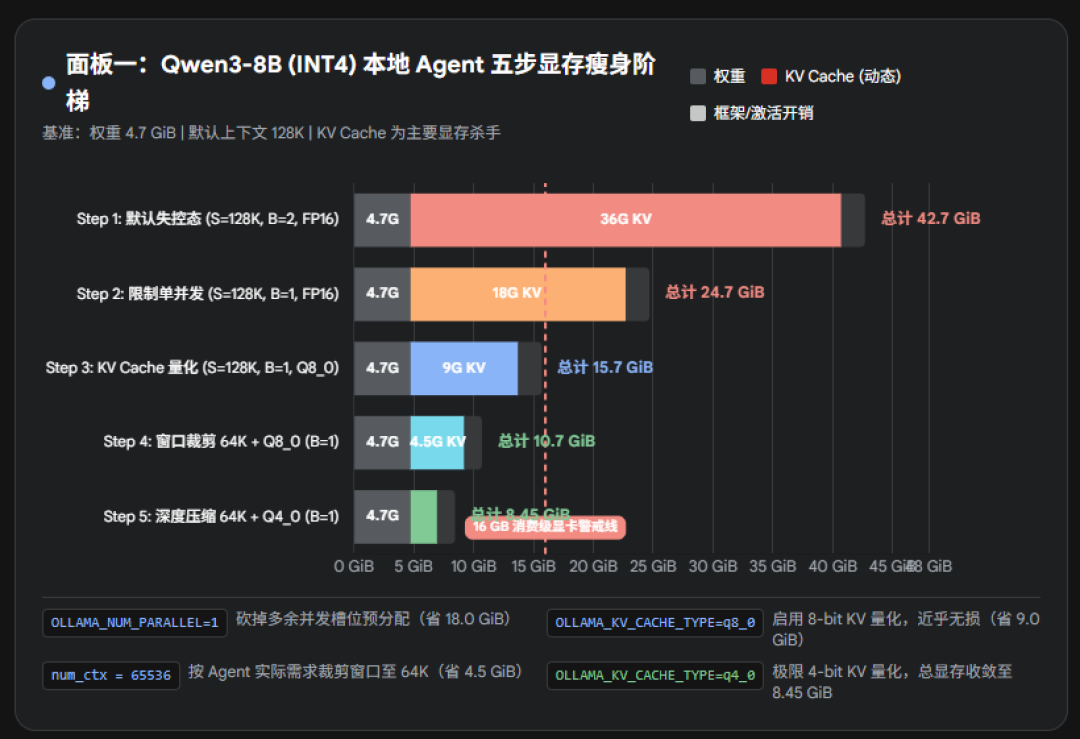
知乎玩家维生素P说得直接:“我的建议是以 4bit 量化作为一个基准线,也就是 Q4 或 int4 模型”。在这条线上,KV缓存量化、短任务缩上下文都不算乱来;再狠压量化档、上更激进的蒸馏,省的是显存,亏的是脑子。也别小看上下文——“模型文件本身的大小,往往只是一座冰山露在水面上的 1/10”,闷头吃显存的是上下文和KV缓存。知乎知乎
第二条线:32B降14B是心疼,14B降7B是换物种
降规模有一道分水岭:“32B 降到 14B,损失可接受,很多任务还够用。14B 降到 7B,就不是降一档了,是换了一个物种”。7B及以下是童工:能全天循环干杂活,一个"陨石为什么精准落在陨石坑"式的诱导题就能把它带沟里。知乎
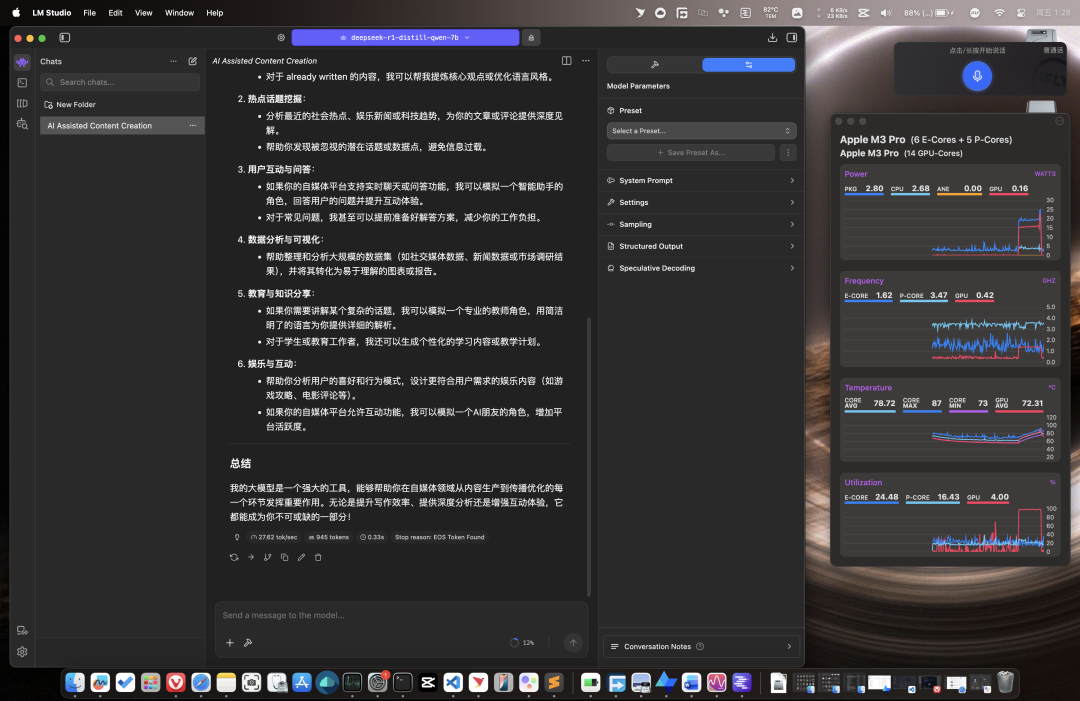
他的及格线:“我会以 14B Q4 量化模型的运行作为一个AIPC启用的基准合格线”。他自己的实测:Q4版7B在普通轻薄本最大显存占用约6G,M3 Pro约每秒27.6个token。知乎
第三条线:“16G是门槛还是玩具”,吵翻了
晒机房拆机卡的博主很直接:“之前用4060Ti 16G,27B只能靠大量量化,压缩到面目全非,推理还卡”。他据此说16G只是入门玩具、32G才是起点,评论区立刻有人回:24G才是。刘聪NLP在一张24G卡上做了同机对决:走Strata专家卸载的Flash-Next写代码更顺手,稠密27B做OCR、整理发票更稳。显存决定的不是能不能玩,是能玩哪种。小红书知乎
显存不够,内存是替补,但别把账记混
B站那条"1128G显存部署DeepSeek-V4.1"火视频下,最热留言在替它算账:“厉害了,64G一根,1128G要18根才能满足,一根6500元,光内存就要11万”。顶上更高的回复纠了基本概念——显存不是内存。更隐蔽的是归属:任务管理器只报总数,“这 15GB 是模型权重、是上下文缓存、是浏览器的硬件加速,还是桌面合成器,它一个字都不说”。哔哩哔哩知乎
最后两句实在话
知乎8G防坑指南开场白:“8G显存不是不能玩,但坑是真的多”。跑不通先看评论区高频答案:升级最新N卡驱动,再补微软VC运行库。至于要不要死磕本地,维生素P的话扎心但实在:有钱才搞本地部署,不然云端Flash便宜量大管饱。显存决定跑不跑,量化决定挤不挤,规模决定跑的是哪种脑子——账算清楚,再动手不迟。知乎小红书知乎