销售嘴里的"AI PC",和你能跑起来的大模型,中间隔着一条叫"实测"的鸿沟。
上周知乎一个提问被顶了上来:人工智能专业笔记本处理器该选酷睿还是锐龙? 底下一个高赞回答张口就是酷睿Ultra自带NPU、算力34–40TOPS、本地跑大模型比同价位快3-5倍。 而另一个拿了816赞、35万播放的回答,讲的却是完全相反的事:NPU的流水线结构,连FlashAttention都很难支持。 两边都在聊"本地大模型",可没有一个人把笔记本真正跑出来的数字摆齐。我把近半年知乎、B站上六组个人实测拉到一起,你看完这三个数,再决定为哪句话加钱。知乎知乎知乎
一、六组实测摆在一起,速度梯队一下就清楚了
设备/路径 | 推理方案 | 模型与量化 | 生成速度 | |
|---|---|---|---|---|
i7-1260P老轻薄本,无独显 | 16G DDR4 | llama.cpp 纯CPU | 16B MoE,q4(约10G) | 约6.7 tok/s |
酷睿Ultra5 225H+RTX5060 | 32G | LM Studio 独显加速 | Qwen3.6-35B-A3B,Q4 | 约28 tok/s |
同机核显硬顶(不挂独显) | 32G | 核显 | 同上 | 约12 tok/s |
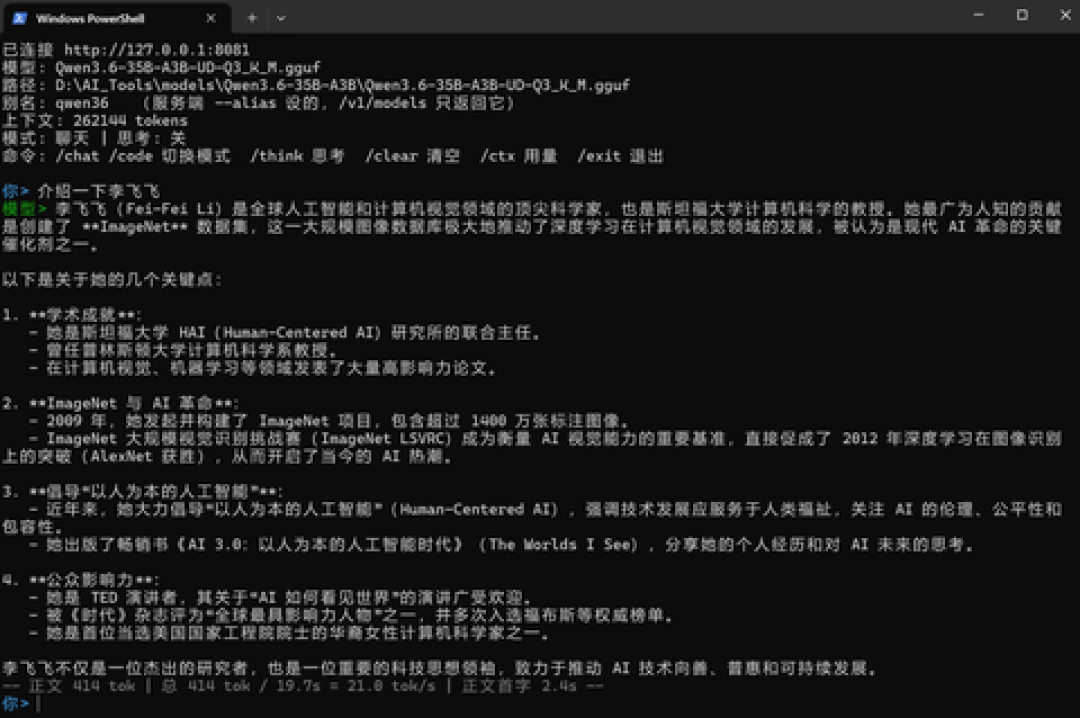
酷睿Ultra X7 358H(第三代酷睿Ultra,无N卡) | 32G | llama.cpp+SYCL核显 | Qwen3.6-35B-A3B,Q3(15.46G) | 21.0 tok/s,报告口径23–24 |
同机跑稠密27B | 32G | 同上 | Qwen3.8-27B-Q4 | 4.5–6 tok/s |
RTX3060 6G显存+大内存 | 64G | Strata / llama.cpp | 125B MoE,Q2(66.4G) | 28–34 / 约12 tok/s |
32G轻薄本,硬盘兜底 | 32G | Janas(SSD卸载) | Qwen3-Next,48G文件 | 约24 tok/s |
先声明边界:以上全部是个体实机测量,不是官方基准,换台机器就会变。但六个样本放在一起,规律已经藏不住了——决定速度的既不是NPU的TOPS,也不是模型总参数量。
二、第一个数:激活参数量。35B跑赢27B,差距是4倍
跑分几乎持平:Qwen3.6-35B-A3B、Bonsai 2 27B、Qwen3.8-27B三个模型的SWE-bench Verified编码分是73.4/72.4/71.9,差距不到2分。 但在同一台没有N卡的358H轻薄本上,35B-A3B跑出21–24 tok/s,稠密27B只有4.5–6 tok/s。 上一代酷睿Ultra5 225H挂5060独显是28 tok/s,极端状况纯核显硬顶也能有12 tok/s。 原因就一句话:MoE架构的35B模型,每个token实际只激活约30亿参数;稠密27B每个token都要跑满270亿。在核显这种算力受限的环境里,激活参数量的差异被直接放大成2~6倍的速度差。对用户的翻译:今年"本本党"的版本答案不是"更大的显存",而是MoE+量化。选模型先看激活参数(A3B、A8B这类标注),再看总参数。买电脑也一样——宣传页写"能跑70B"的,多半是MoE的70B,跑起来什么手感,一个字没提。知乎知乎知乎
三、第二个数:内存。32G是门票,焊死才是大坑
358H那篇实测报告里给出了一个非常好用的经验公式:系统内存占用 ≈ 权重 × 1.6 + 5.8 GiB(Windows基线)。 这台32G机器加载15.46G的Q3权重后,系统吃掉30.5G,只剩约0.7G空闲——权重上限约15.5G,20G级模型必换页。知乎
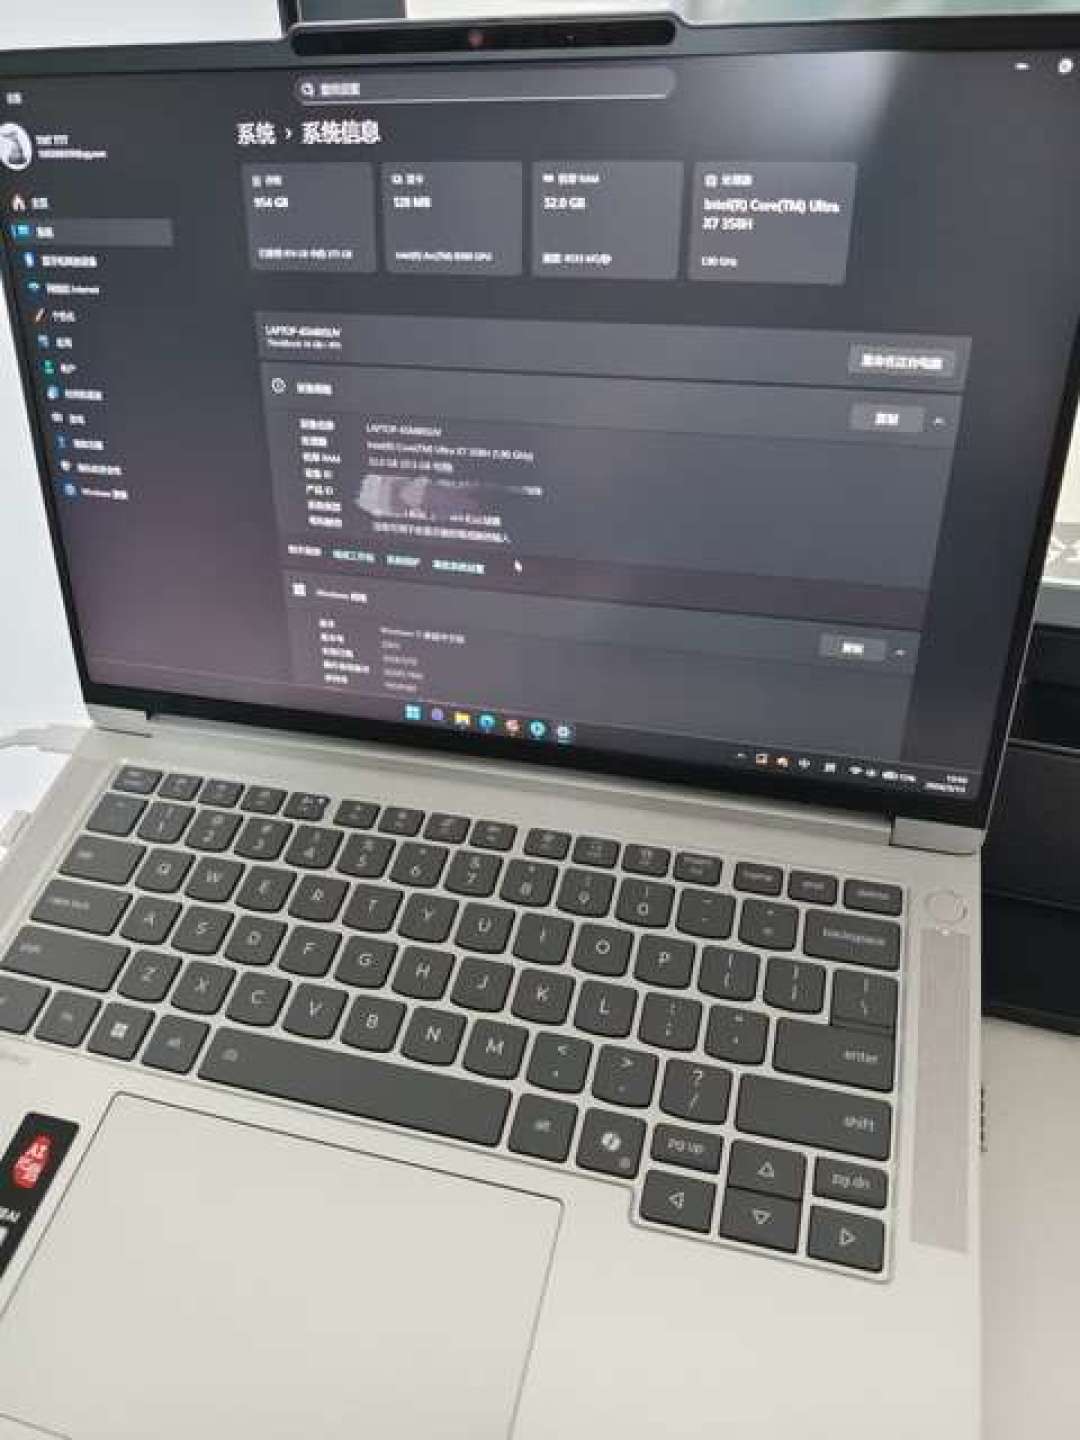
换页是什么体验?同一台机器跑Qwen3.8-27B时,一道650 token的debug题耗时1082秒,吞吐掉到0.6 tok/s;对照组Qwen3.6只用了35.3秒。 16G内存的i7-1260P则是另一种图景:跑10G权重的MoE只剩0.3–0.6G余量,6.7 tok/s勉强能用,但别想同时干别的。 而今年内存硬盘涨价、焊死内存机型变多的背景,只会把这个问题进一步放大。知乎知乎
6G显存的老游戏本靠64G内存+Strata,能把125B的Q2量化模型跑到每秒28–34个token。 32G纯轻薄本靠Janas把48G模型卸载到硬盘上,也能写出每秒24个词元的成绩。 大内存和可升级性,今年就是本地AI的生产力本身。 买之前翻到底盖看一眼:焊死16G的,直接划掉。哔哩哔哩哔哩哔哩哔哩哔哩
四、第三个数:别给NPU的TOPS单独付费
社区吵得最凶的就是这里。支持方的话术你已经看到了;质疑方的判断则很直接:端侧NPU目前还属于鸡肋,跑小模型没问题,但一启动就吃内存,基本干不了别的活。 把六组实测翻一遍,答案其实已经摆出来了:真正跑出来的数字,全部来自CPU、核显、独显这三条路——连最硬核的256K上下文方案,走的也是llama.cpp + SYCL核显这条路,没有一组是靠NPU跑出的生成速度。 官方NPU工具链这条线确实一直在推,但截至发稿,第三方在酷睿Ultra笔记本上用NPU实测大模型生成速度的公开样本,我一个都没找到。知乎知乎
证据到哪,结论就只能说到哪:现阶段"能本地跑大模型"这个需求,不值得为NPU的TOPS数字单独加钱;NPU目前的真实贡献在后台任务的能效,而不是对话速度。如果哪天官方推理栈把NPU这条路铺平,这份账才需要重算。
五、对号入座:三类人三种走法
AI专业学生/要本地编码助手的程序员:32G起步、优先可插内存的机型;酷睿Ultra X7 358H这一代轻薄本靠核显就能把20+ tok/s的MoE模型当日常工具用,实测报告口径23–24 tok/s、上下文可开到模型原生的256K,没有N卡也能干活。 256K长上下文有额外条件(核显共享显存要在BIOS里拉高),照着原报告的A/B设定再研究一遍。知乎
涉密/离线办公:16G老酷睿也能跑,6.7 tok/s加11-12秒冷启动,日常问答够用,数据全程不出电脑就是价值。 但把"速度接近云端"的期待先放下。知乎
只是心动想玩玩:别为这三个字掏溢价。先在你现有的电脑上装个LM Studio跑一个A3B小模型,确认自己真的会用,再谈换机。小红书那条128GB统一内存AI工作本的提醒,眼下成立。小红书
值得继续盯的信号:128G内存AI工作本的实际售价与量产、Strata/Janas这类卸载方案的易用化速度、以及第三代酷睿Ultra首批机型双11后的真实成交价。