如果说今年个人AI圈什么词最火,"第二大脑"一定榜上有名——这是小红书博主"三木"在9月那篇讲Obsidian插件的笔记里的原话。 火到什么程度?我们把小红书、B站、知乎、微博四个平台翻了一遍,仅"第二大脑/AI知识库"相关的高互动笔记和视频就采到了上百条。小红书
但采完这批数据,最先注意到的不是热度,而是一个不太体面的分布规律:
教程类爆款的收藏数几乎全线高于点赞数。 小红书那条《ClaudeCode+Obsidian打造你的超强第二大脑》赞3586、收藏6917。 B站那条《搭建全网千万收藏的AI第二大脑!一学就会》赞11151、收藏12628、播放40.7万。 给WorkBuddy装第二大脑的演示赞1729、收藏3490。 《Howto:用AI+obsidian搭不吃灰的知识库》赞2036、收藏3321。收藏率是点赞率的近两倍——这个比例翻译成大白话就是:大部分收藏者根本没打算立刻用,他们是在为"以后一定会用"这个幻觉下单。小红书B站小红书
而10月中旬开始,翻车声和热度一样密集:知乎《你的知识库不是第二大脑,是第二个垃圾场》、小红书《受够了"收藏即吃灰"?》《How to 拯救已"吃灰"的收藏夹?》、10月21日当天还有人发帖《怕笔记丢?我给"第二大脑"上了三道保险》。知乎小红书
所以这篇不再教你装软件。只回答三个问题:翻车的人到底翻在哪一步、你这种人该走哪条路线、以及怎么判断它真的在为你干活。
一、评论区才是翻车现场:五种最典型的死法
教程的正文是卖方语言,评论区才是买方实录。我们把几条头部教程的评论区翻出来,翻车模式高度收敛成五种:
死法一:收藏驱动搭建,先建库后有问题。 这是"垃圾场论"那篇点名的核心:“资料一篇篇往里塞,标签一层层往上加,页面越搭越漂亮……真遇到问题的时候,还是得从头找、从头想、从头解释”。 作者吾爱拆解把自己骂醒的过程很典型:他找AI是为了少干活,结果搭完库"等于给自己找了份知识库管理员的工作"。知乎
死法二:照抄教程,卡死在工程细节。 B站《20分钟构建AI第二大脑知识库》的评论区里,有用户跟做后如实汇报战果:重复文件二次摄入、没法去重;skill和工具没有固定存放位置,“时间长了会乱”;文档切得不好,“知识库变成垃圾库”。这些坑教程视频一律不展示。B站
死法三:人群错配,形式大于内容。 一条20赞的热评来自高考生:“我研究了一天,也觉得OB对于高考学生来说有一点形式大于内容,确实仅仅AI对话已经满足大部分需求。” 第二大脑的前提是你的知识需要长期复用,如果你和AI的交互是"问完即走",搭库就是负资产。B站
死法四:数据焦虑和成本焦虑。 3年老用户的判断很扎心:“哪怕是你自己手打的笔记一旦多起来,都需要复习复盘才能盘活,何况用AI建的”。 另一边是纯技术问题:能不能手机端用、同步要不要花那4美元/月、资料越攒越多token会不会烧穿体验、有没有"遗忘机制"防止库臃肿——全部是真实评论原问。B站B站
死法五:搭完即终点。 “第二大脑还是要想办法和第一大脑连接、复用,在第二大脑里整出花来,不看、不想,也没用”。 这条评论下面跟了一句自嘲:“用了AI agent之后变傻了。”B站
五种死法共同的病根一句话就能说完:过去的笔记软件解决"存",教程卖给你的也全是"存"的仪式感;但第二大脑的全部价值在"取"。 取不出来,存得越整齐,垃圾场越漂亮。
二、事实层:今年"第二大脑"其实被改写过一次
为什么老一套收藏法今年被集中撕破?因为工具层出了两个真变化:
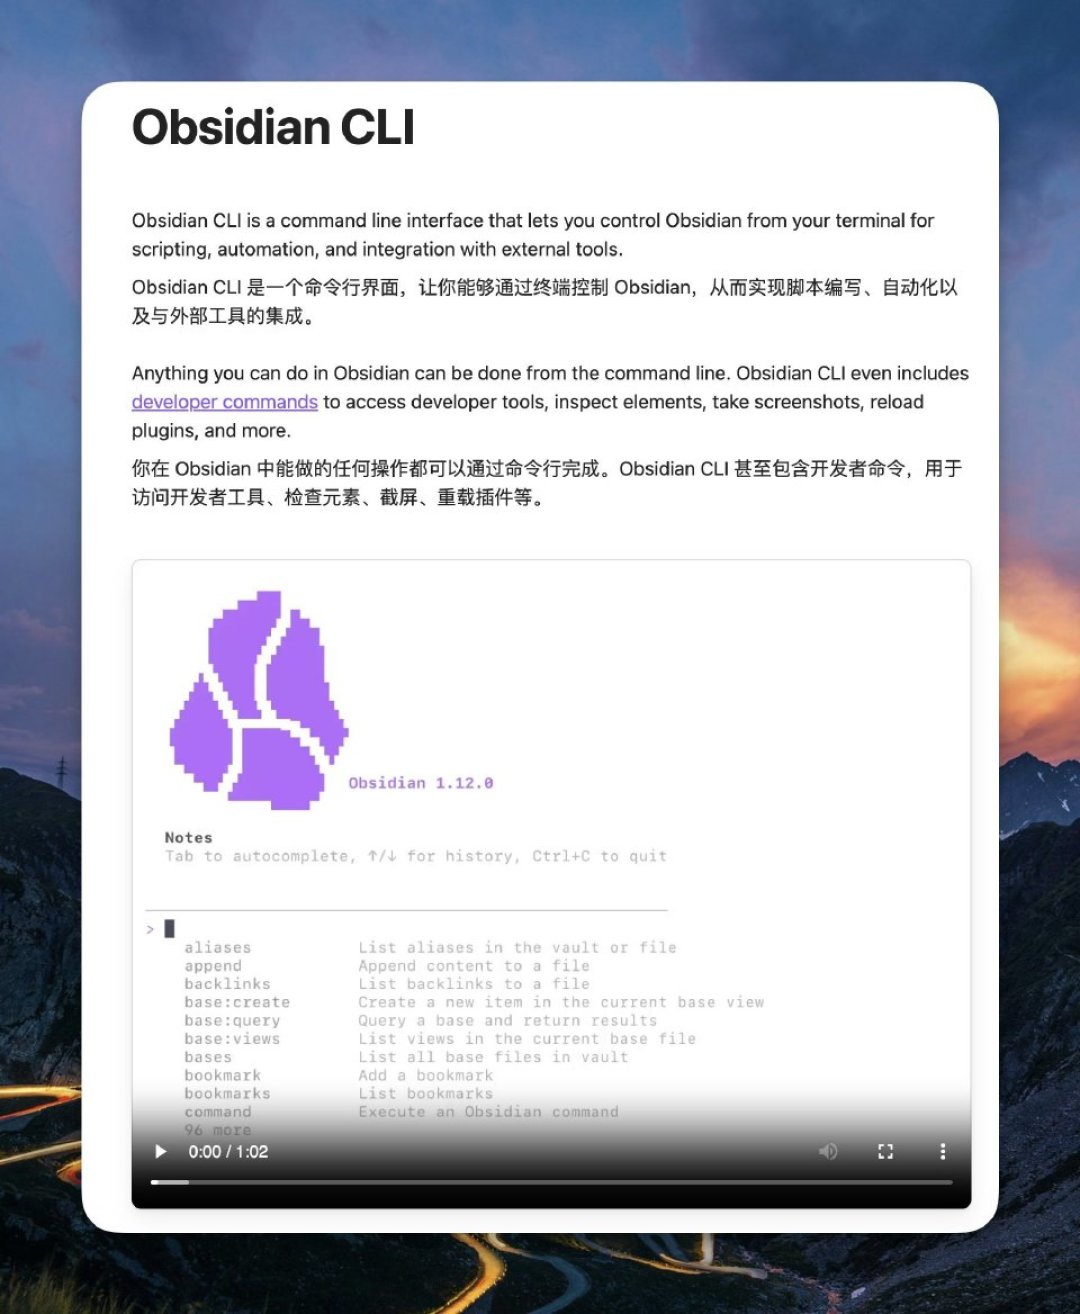
1. 软件开始为Agent重做。 2026年2月10日,Obsidian发布1.12版,核心是一个命令行工具(CLI);同一天Draw.io和Excalidraw发布了MCP接口。当时的讨论就点破了趋势:软件正在为AI Agent重做交互。CLI的意义是AI第一次能直接"读懂并操作"你整个本地知识库,而不是一篇一篇翻碎片。B站
2. Karpathy的LLM Wiki给了个"不切块"的范式。 OpenAI前研究员、特斯拉前AI总监Karpathy放出那份LLM Wiki设计文档后(gist地址已在各教程置顶评论区流传),B站、小红书4月起密集出现"同款"教程。它跟传统RAG的关键区别,大梁Max视频评论区一条作者回复讲得最清楚:不切碎、不embedding,“原始资料原样躺在文件夹里,由agent按规则文档通读后自己写概念页、摘要页,再维护一份总目录;调用时agent顺着目录去找”。 转述教程里还提到Karpathy本人用AI维护着约100篇、40万词的wiki,自己几乎不动手。 国内这边,腾讯ima、WorkBuddy这类"收藏夹→知识库"的一体化产品也在同一窗口期起量——ima那条讲解视频播放20.8万、收藏4681。B站小红书B站
范式迁移翻译成人话:从前是"你整理给AI看",现在成立的条件是"AI整理给你查"。 只有当"维护成本"被Agent接走之后,第二大脑对普通人才第一次算得过账。这也是"垃圾场论"作者没有把Obsidian一棍子打死的原因——他反的是维护劳动转嫁给用户的老搭法。
三、三条路线:对号入座,附成本表
社区信号翻完,人其实分三类,路线完全不同,抄谁的作业都可能错。
路线A:问题驱动的轻用户(偶尔写方案、做决策、备考)。
不要搭库。用AI自带记忆/对话历史,加一个网盘文件夹只存"这次真用过的资料"。参照垃圾场论作者的现行做法:先有问题→AI找料→一起核对来源→只把真正参考过的留下。他的诚实之处是承认自己"还缺一次完整验证过的复用案例"——这条验证结果值得所有观望者等。
成本:约0元/月,时间投入≈0。适用判断:你和AI的日常对话已经覆盖90%需求,别自找第二份工作。
路线B:材料复用型中度用户(创作者、产品、研究生、爱收藏长内容的人)。
可以搭,但按这三条铁律搭:一个库一个领域(别生活工作混库,B站教程作者对token交叉污染问题的回复就是"按大类分区");先用现成的LLM Wiki插件,不要自研切块;起点20-30份材料跑通闭环再扩。同步用免费方案先顶上(本地Markdown+网盘自动备份,参考10月21日那篇"三道保险":正本一个固定文件夹、备份一份另一位置、再脱机一份),验收通过之前不付费、不订阅。小红书
成本:软件免费+可选订阅,真实成本是头2-3周的习惯养成。验收标准见下一节,唯一的一条。
路线C:大体量材料的重度用户(律师、研究者、长期项目党)。
投入是算得过账的。知乎"老井"10月14日的复盘是最完整的样本:四个半月,从给DeepSeek充20块钱起步,长成了41个能调用的能力、14个知识库、32个自动跑的任务,底下压着5万多条法条、1.1万条判例、1.7万本电子书。 律师场景那篇讲得更具体:三个客户的材料散在微信群、邮箱和U盘里时,"乱"不是记性问题,是没有归位系统。 这条路线要预算的不只是钱,还有维护时间——但换回的是"举证期限不会被漏掉"这种确定性。知乎知乎
四、五个避坑清单 + 一个验收标准
避坑(全部来自翻车帖与评论区实录):
别把"收藏=读过"迁移进新软件——收藏夹不消化的东西,Obsidian同样不消化;
别在搭建第一天炫耀库:干净目录和漂亮图谱是掌控感的药,不是产出;
别混库:生活、工作、学习至少结构分区,检索交叉污染比不检索更浪费时间;
别指望搭完自动盘活:任何库都需要调用动作喂养;
别先买任何订阅计划:同步、会员、算力包,全部放到验收之后。
验收标准只有一条,也建议所有人拿它去问自己的库:下一次遇到类似问题时,你能不能可靠地把上次那份东西调出来,而且真的帮你省了时间? 垃圾场论原文把这条叫"不比存了多少,比下次能不能用上"。 两周后让Agent从库里回答一个你早忘了来源的问题——答不上来,坏的是提炼层,不是你的收藏习惯。知乎
五、接下来盯什么
LLM Wiki类插件在Obsidian生态的成熟度,以及WorkBuddy、ima们和"AI原生记忆"(各家大模型的长期记忆功能)的路线竞争——现在胜负未分,抄任何一方都可能是抄在半路上;
“垃圾场论"作者承诺的那次真实复用验证,结果大概率是两边社区都会引用的共同答案。作者的原话是"截至目前,我还缺一个完整、经过核对的知识复用案例”,跑通之后再来判。知乎
年底订阅季:如果你还在路线B,免费方案撑到验收,别被大促节奏提前收割。
2026年这轮"第二大脑"热,其实是两件旧新交替的事:旧的还是那个"收藏从未停止、学习从未开始"的老毛病;新的是头一次有个便宜、勤快、真的会替你读和整理的外包工。值不值得把材料交给它,别问软件,问你自己那个唯一的问题——上次它帮你在旧笔记里捞到东西,是什么时候?