







 深耕AI、数码兴趣领域





24
31
实测 Qwen 3.8 - Flash,接近 Opus4.8,性价比拉满。
2026-11-16 22:15:16
0点赞
0收藏
0评论
点击上方蓝字关注我,加个🌟标不迷路。
各位小伙伴们大家好,我是 cxuan。
8 月 26 号晚上,Qwen3.8-Flash 官宣发布了,这是一个多模态的 MoE 模型。哦对了,Qwen 3.8-Flash 和 Qwen 3.8-Flash-Next 其实是一个东西,默认 262k 上下文,可拓展至 1M,并且带内置工具。Qwen 在官宣 3.8 flash 的时候,也把下一代架构给指出来了,下一代,就是满怀期待的 Qwen 4。
AI 一天人间一年了算是。过去大模型的能力基本上随着参数量、训练成本和推理价格同步上涨,是一个绝对的正相关性事件,但是这还没过多久,时代就变了,现在开始卷的是 token 效率。
Qwen3.8-Flash 这次发布就做了技术升级,我看了一下,仅激活了 6B 参数,就在编程、智能体、专业工作和多模态等多项评测中接近 Opus 4.6 了,于此同时,Qwen 3.8-Flash 的训练成本相比 Qwen 3.7-Plus 降了接近 90% ,tql 。
我认为这次 Qwen3.8-Flash 的发布,不在于告诉大家 Qwen 又出了个多模态模型,也不是单纯发一下新模型。
还是挺有意思的,Qwen 这次的动作想把 Qwen 4 的叙事给大家预演一下。
还是老样子,我们先看看测评榜单,因为是多模态了,所以测评有两种,一种是纯文本,一种是多模态。
先看纯文本:
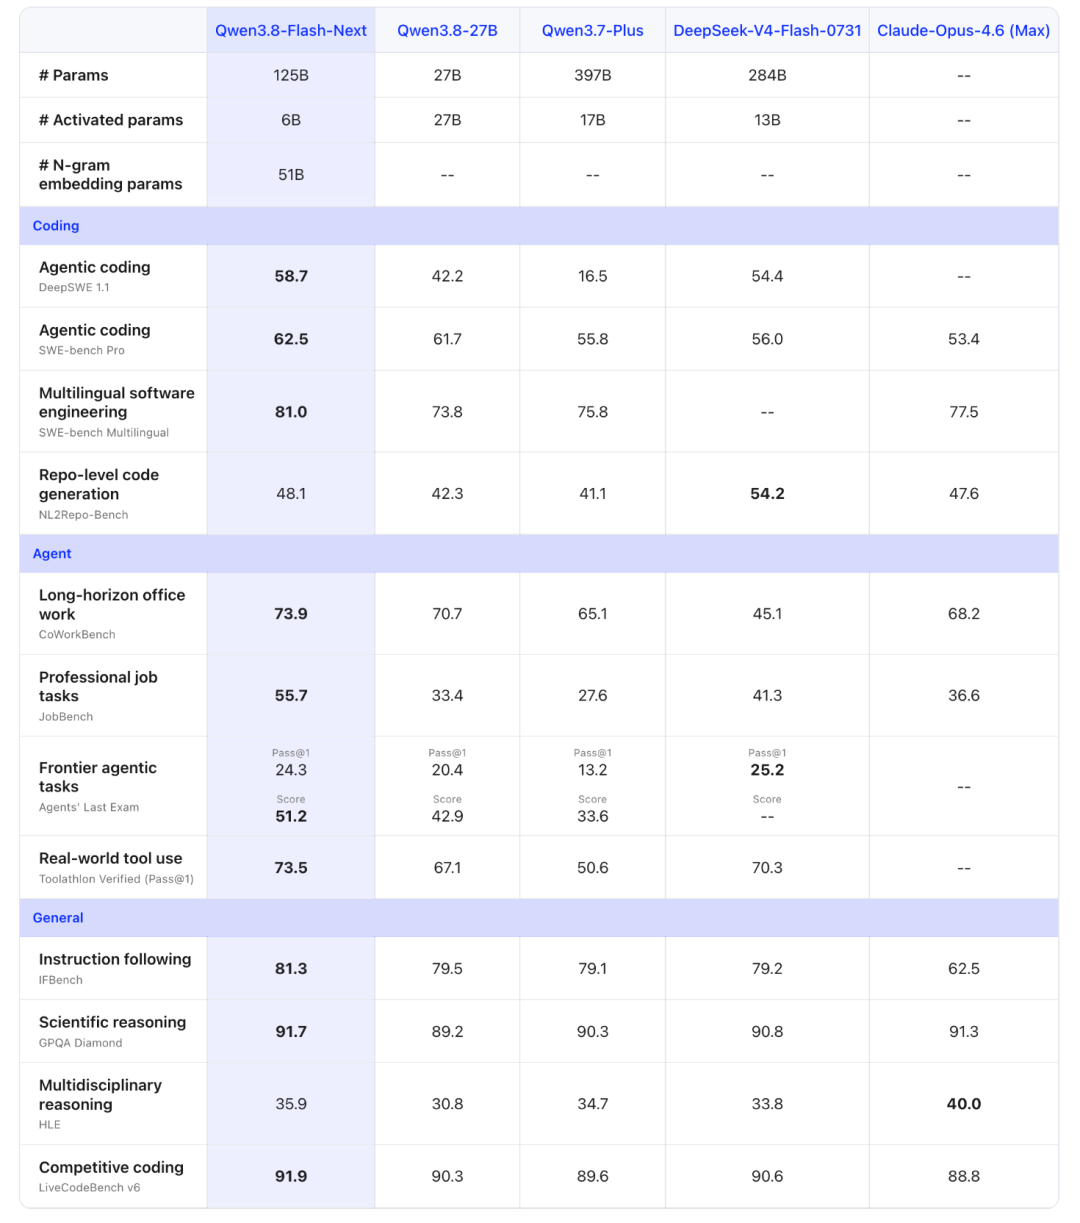 image-20260827162733353
图源:Qwen 官方技术博客
Qwen3.8-Flash 总参数是 125B,每个 token 只激活 6B。DeepSeek-V4-Flash 激活 13B,Qwen3.7-Plus 激活 17B,Qwen3.8-27B 更是 27B 全激活。
但是到了 Coding 和 Agent 榜单,6B 并没有掉队。SWE-bench Pro 拿到 62.5,高于 DeepSeek-V4-Flash 的 56.0 和 Opus 4.6 的 53.4;CoWorkBench 是 73.9,Opus 4.6 是 68.2;JobBench 更明显,Qwen3.8-Flash 是 55.7,Opus 4.6 只有 36.6。
这几项都不是单纯考模型会不会答题,它要读环境、调用工具,再把任务往下推进。只激活 6B 参数还能把长周期办公和专业任务做到这个分数,确实有点东西。
不过也没有全面领先,NL2Repo-Bench 是 48.1,低于 DeepSeek-V4-Flash 的 54.2;HLE 是 35.9,Opus 4.6 是 40.0;Agents' Last Exam 的 Pass@1 也略低于 DeepSeek。
不过每个 token 只激活 6B 参数的模型,Coding 和 Agent 成绩却追上了过去需要激活十几 B、甚至 27B 参数的模型。
这里我还想把 Qwen3.8-27B 单独拎出来说一下,之前 Qwen3.8-27B 本地部署的时候,大家反馈非常好,基本上是小模型本地部署的旗舰了。图里的数据也对得上:SWE-bench Pro 是 61.7,Flash-Next 是 62.5,只差 0.8 分;CoWorkBench 是 70.7,只差 3.2 分;IFEval 和 LiveCodeBench 也分别只差 1.8 分和 1.6 分。
差距比较大的地方,主要集中在更重的 Agent 任务。DeepSWE 1.1 上,27B 是 42.2,Flash-Next 是 58.7;JobBench 则是 33.4 对 55.7。Flash-Next 这次新增的架构,确实把 Coding Agent 和专业任务往前推了一截。
如果你更看重本地运行、数据留在自己手里,Qwen3.8-27B 依然是目前的首选。
再看多模态:
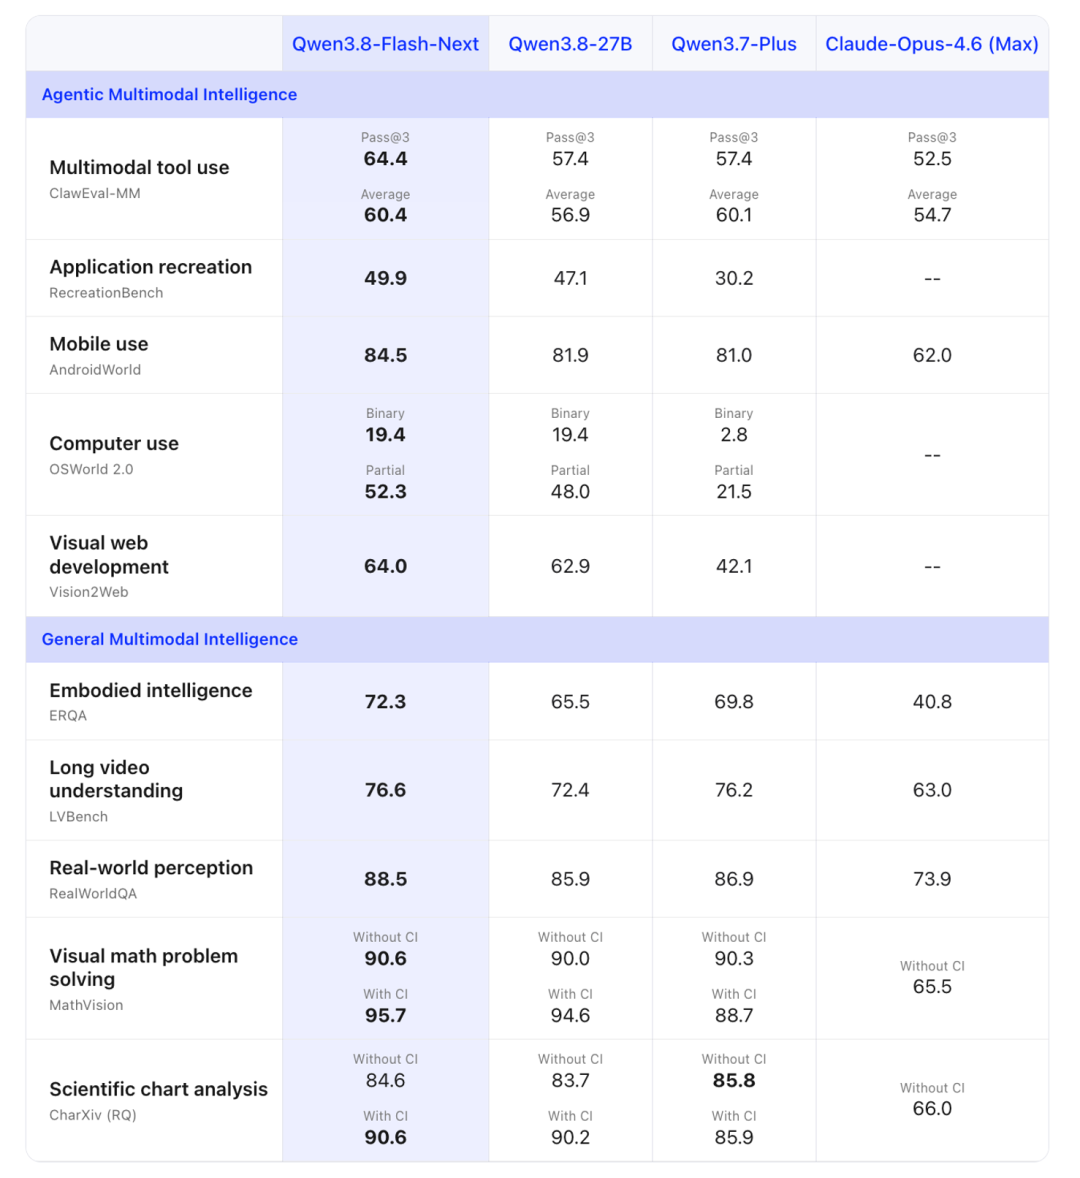 image-20260827162822742
图源:Qwen 官方技术博客
多模态这张图,我觉得比纯文本更能体现 Qwen3.8-Flash 的定位。
ClawEval-MM 测的是多模态工具调用,Qwen3.8-Flash 的 Pass@3 是 64.4,平均分 60.4,都超过了 Opus 4.6。AndroidWorld 拿到 84.5,Opus 4.6 是 62.0;OSWorld 2.0 的 Partial 得分是 52.3,也高于 Qwen3.8-27B 的 48.0。
视觉网页开发同样明显。Vision2Web 是 64.0,Qwen3.8-27B 是 62.9,Qwen3.7-Plus 只有 42.1。
这些任务有一个共同点:模型看懂图片只是第一步,后面还要点击、操作、调用工具,最后把任务完成。
通用多模态也很稳。长视频理解是 76.6,真实世界感知是 88.5,具身智能 ERQA 是 72.3,这三项都是图里的第一名。
图表分析这里还有一个细节。Qwen3.8-Flash 不用 Code Interpreter 时是 84.6,略低于 Qwen3.7-Plus 的 85.8;加上 Code Interpreter 以后直接涨到 90.6。
结合上面文本和多模态能力可以看出,Qwen3.8-Flash 的主战场就是高频 Agent 了。
技术报告一共 28 页,里面的新名词很多。我看完之后,核心其实就一句话:更聪明人花更少的力气干更多的活。
这特么是打工人的终极梦想了有没有。
先说花更少的力气。
普通模型读一段很长的内容,每次回答都要回头翻很多历史信息。上下文到了几十万、上百万 token,速度和成本就上去了。
Qwen3.8-Flas 的做法很像一边读书一边记笔记。大部分内容先压缩成笔记,需要找细节的时候,再回到最相关的几页仔细看。
负责记笔记的技术叫 Gated DeltaNet,俗称 GDN 。负责找重点的叫 Qwen Sparse Attention,也就是 QSA。名字不用记,知道它不用每次都把整本书重读一遍就行了。
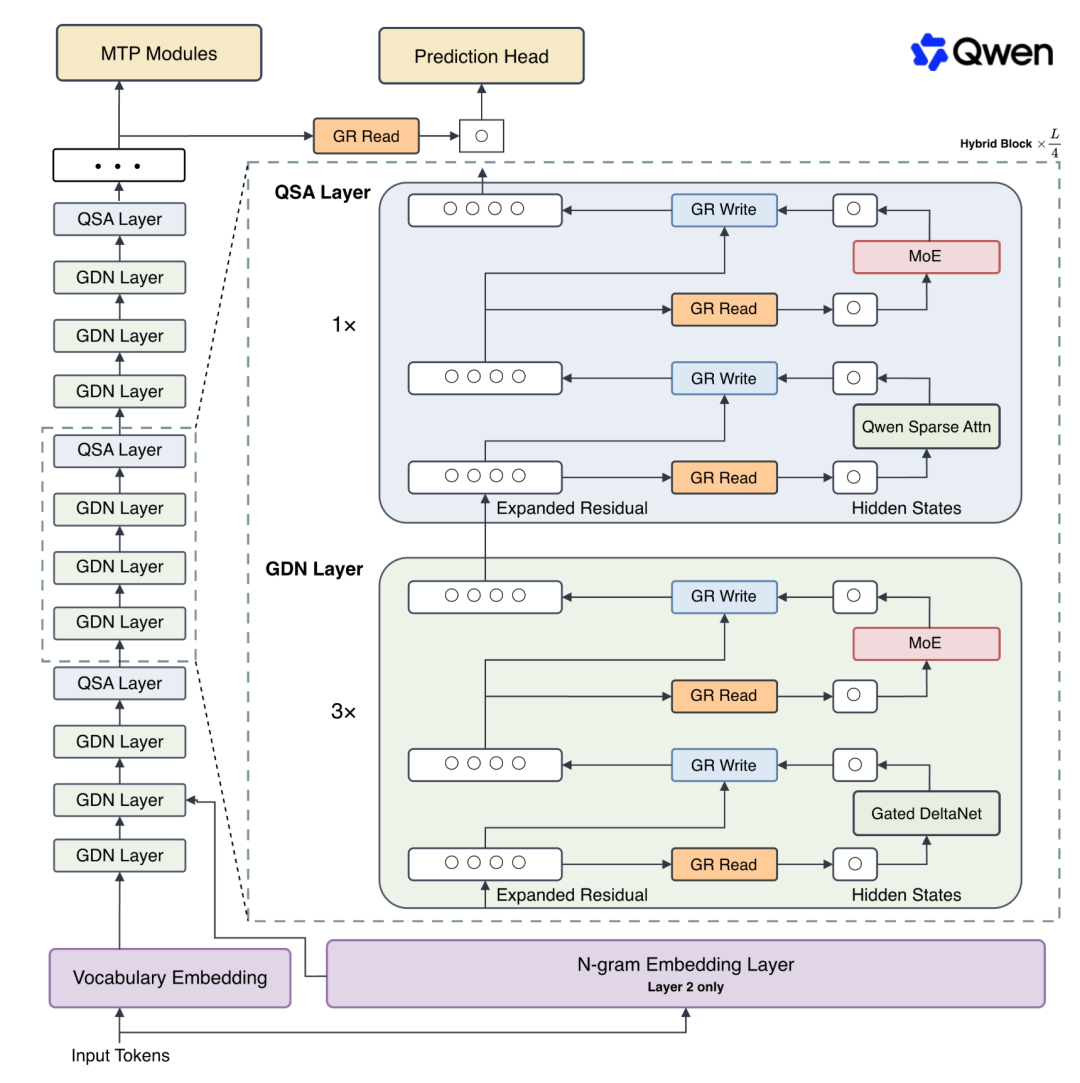 image-20260827193423617
它每四层里安排三层负责记笔记,再安排一层回头找重点。根据技术报告的数据,在 100 万 token 的上下文下,注意力模块第一次读入材料的速度提升了 7.6 倍,后面逐字生成答案的速度提升了 4.9 倍。
这对 Agent 很重要。它读一个代码仓库、几百页文档或者很长的操作记录时,能先记住整体内容,再把计算量花在当前真正需要的信息上。
第二个变化是让训练更稳定。
以前模型里的信息都像车一样都挤在一条路上。但 Qwen3.8-Flash 把它拓宽成了四条路,再由一个开关决定从哪条路读取信息,再把结果放回哪条路。
这套设计的官方名字叫 Gated Residual。还是不用记名字,效果就是模型装下的信息更多了,训练时也不容易崩了。
第三个变化是给模型加了一张巨大的短语速查表。
模型看到连续出现的两个或三个 token,可以直接去表里查,不用每次都从头计算。这就是 N-gram Embedding。
这张表增加了 51B 参数,可以放在主机内存里提前读取。它给模型增加了不少容量,每个 token 参与计算的参数依然只有大约 6B。
并且 Qwen 重新搭配了训练算法、学习率和每批数据的大小。同样训练这么多 token,现在能少跑 18.8% 的模型更新步骤。
Qwen3.8-Flash 每次激活的参数大约只有 Qwen3.7-Plus 的三分之一,训练时读过的 token 数也是三分之一,两项乘起来,训练总计算量只剩下大约 1/9。
计算量少了这么多,它的 Base 模型在 14 项评测里,仍然有 8 项超过 Qwen3.7-Plus。剩下 6 项,最大差距也只有 2.6 分。
少花接近九成的训练计算量,最后能力还能持平,这才是 Qwen3.8-Flash 这套新架构的价值。
实测一下这次新模型的效果吧。
因为这次有多模态,所以我们也加上了多模态测试。
最近办公软件太火了,所以我们用的软件是千问办公。
千问办公现在已经支持了 Qwen3.8-Flash 。
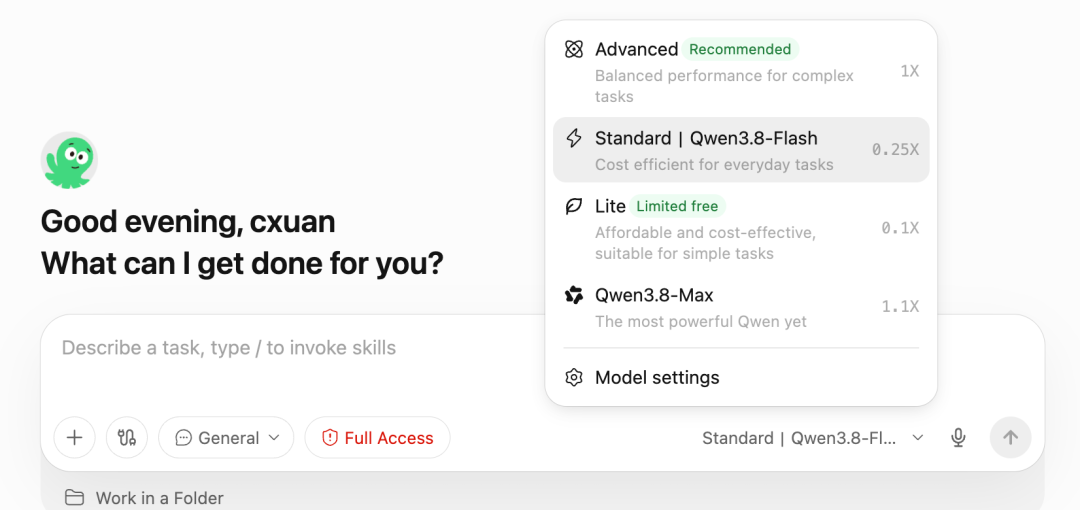 image-20260827194346438
这次我选的是 Standard 档的 Qwen3.8-Flash,界面显示的用量倍率只有 0.25X。
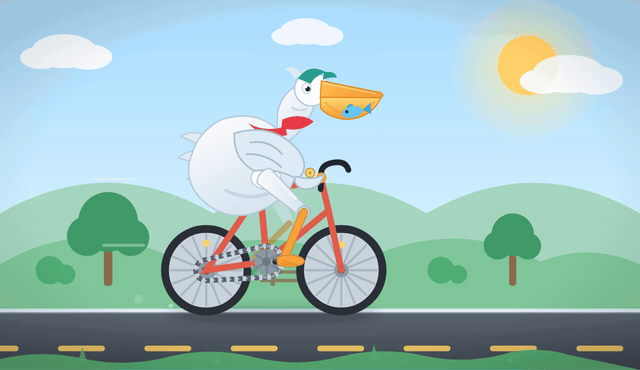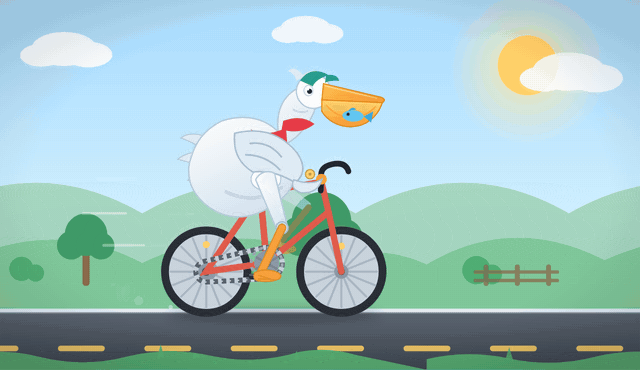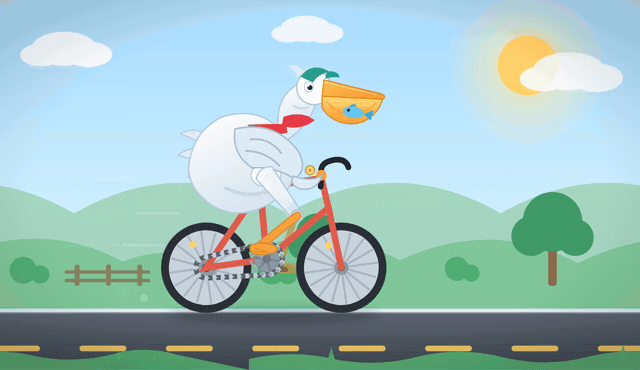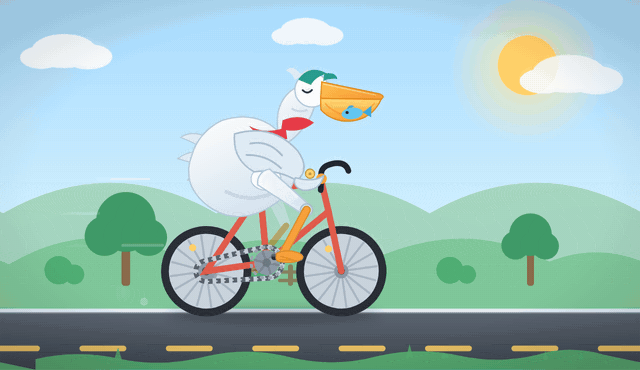
第一个测试,还是先让它绘制一个鹈鹕骑自行车的测试。
 pelican-bicycleqwen
不是 Qwen 你是经历了什么,为什么这个鹈鹕的头上是绿色的???
这个效果还是不错的,比我之前实测 DeepSeek-v4-pro 绘制的要好。。。这个老年版二八大杠似的自行车太抽象了。
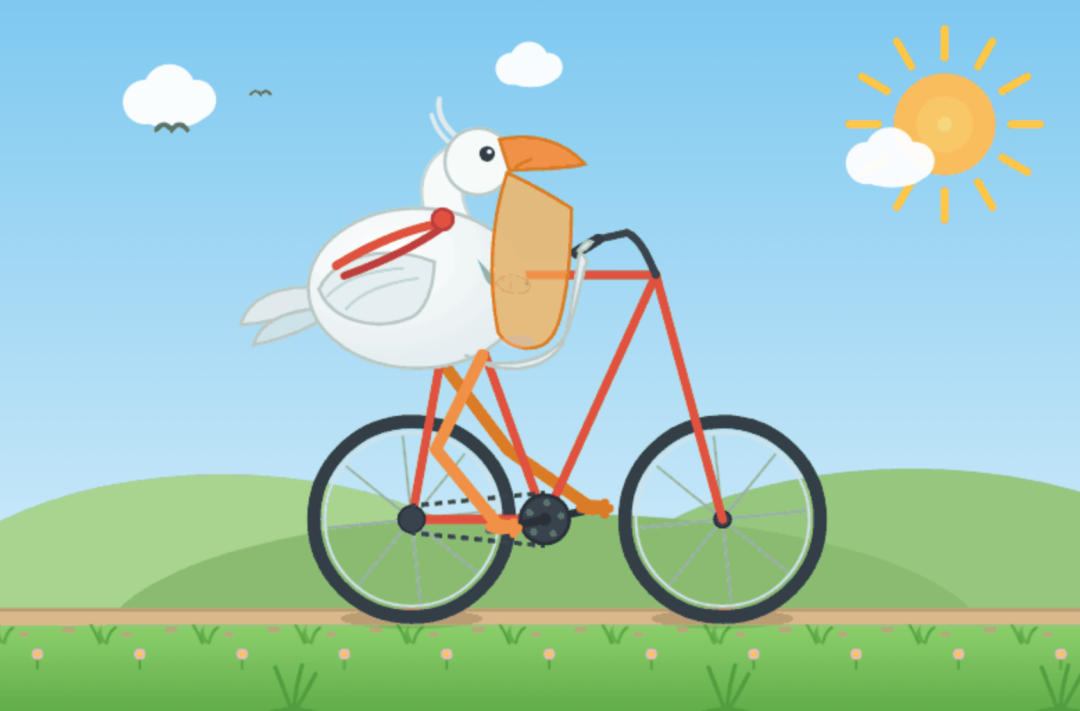 image-20260827212848535
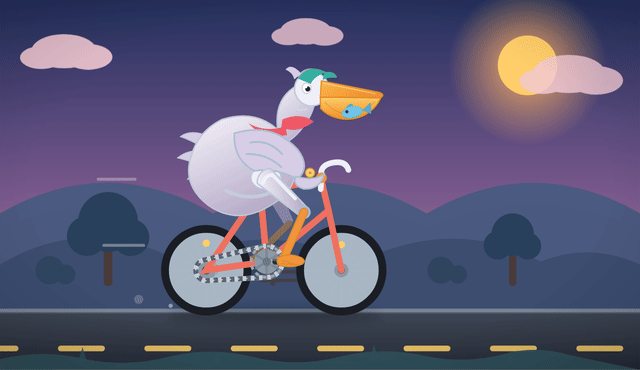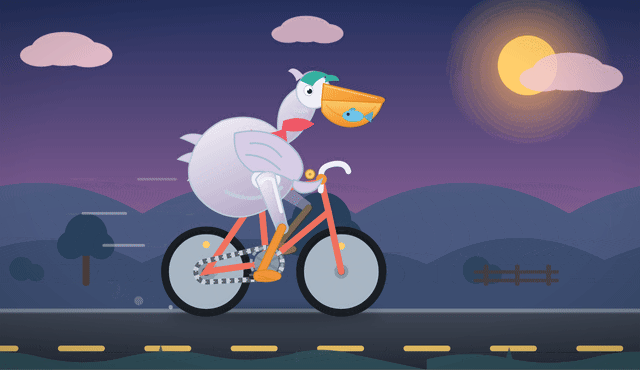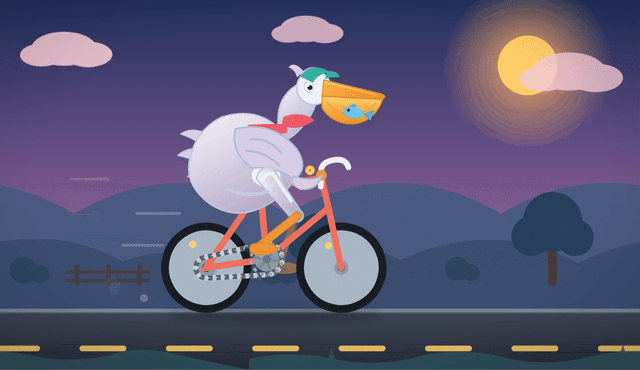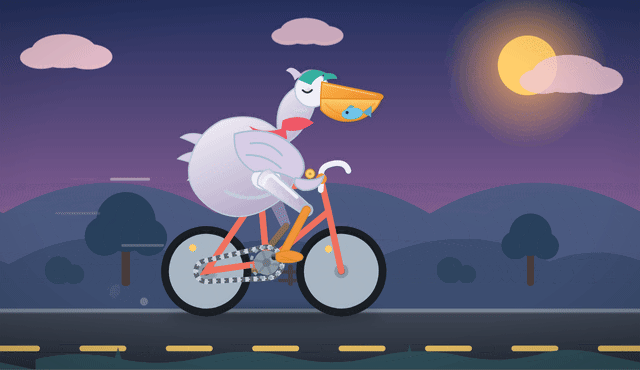
而且这是我实测这么多模型,第一个把亮色和暗色配置给加上的。
黄昏的配色明显要好看些啊。
 pelican-bicycle-dusk
然后我用 Qwen3.8-Flash 复刻了一个 Linear 的后台管理页面,但其实这个提示词我给错了,我想让 Qwen3.8 复刻的是前端页面。
prompt 如下
使用 React、TypeScript 和 Tailwind CSS,复刻一个 Linear 风格的项目管理应用。必须实现 Issue 列表、Kanban、详情抽屉、创建编辑、搜索筛选、拖拽、命令面板、主题切换、响应式和 localStorage 持久化。所有按钮必须真实可用,不得只制作静态页面。自行生成不少于 30 条逼真的测试数据,并在完成后运行测试、修复错误。不过,这个后端页面复刻的也是很不错了,给大家看一下效果。
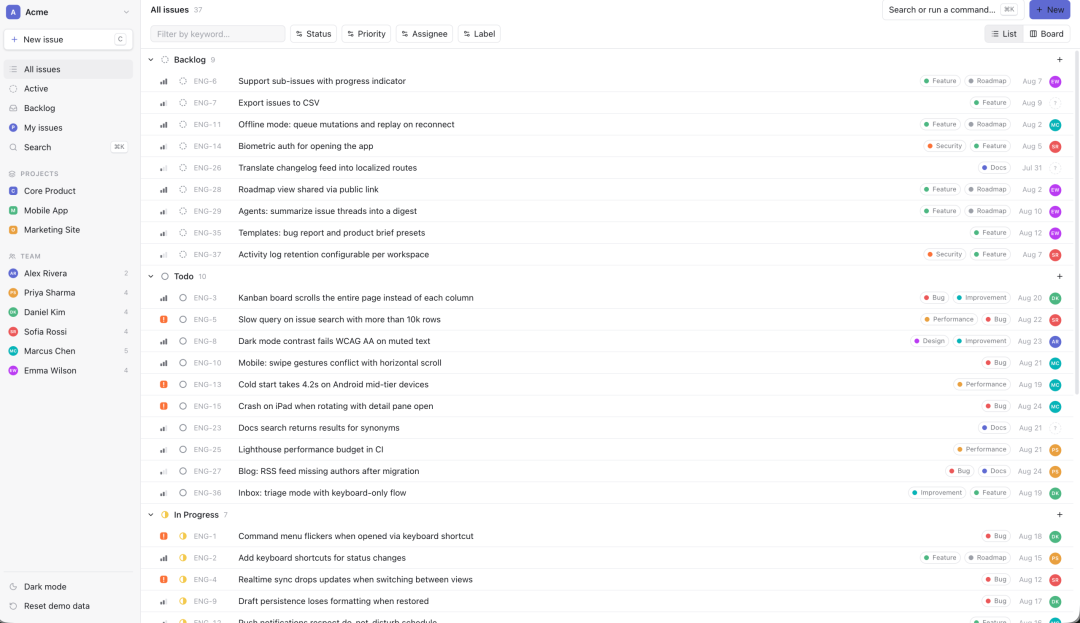 image-20260827231023939
这一版方向虽然错了,工程倒是做得很完整。页面里有 37 条 Issue,按 Backlog、Todo、In Progress 等状态分组,搜索、筛选、列表和看板切换、详情抽屉、创建编辑、命令面板、主题切换都有。
我看了一下应该是我的 prompt 给错了,我让他做的是项目管理应用,怪不得。
你刚才实现错了。目标是 1:1 复刻这个公开网页:https://linear.app/features请先完整访问并观察参考网页,再修改当前项目。严格要求:1. 复刻对象仅限 https://linear.app/features2. 不要出现应用侧边栏、Issue 列表、Kanban、项目成员或后台管理界面3. 按参考网页还原:- 顶部官网导航栏- “The system for modern product development”主视觉区- 副标题- Planning- Building- Artificial intelligence- Insights- Mobile- Customer Requests- Linear Asks- Security- 底部“Plan the present. Build the future.”CTA- 完整 Footer4. 尽量精确还原原网页的:- 页面宽度和留白- 字体大小与字重- 深色背景、网格和渐变光效- 卡片尺寸及不对称布局- 圆角、边框、阴影- 卡片内部的产品界面插画- Hover、滚动进入及背景动画5. 同时适配:- 1440×900 桌面端- 390×844 移动端6. 不要根据“Linear 风格”自由发挥,必须以参考页面为唯一视觉依据。7. 完成后启动项目,分别截取参考网页与本地页面的同尺寸截图,逐项比较并继续修改。8. 在布局、颜色、字号和间距达到高度一致之前,不要宣布完成。9. 不得只做首屏,必须完成整个页面。经过一段时间后,这是复刻 linear 的首页,还原度还是非常高的。
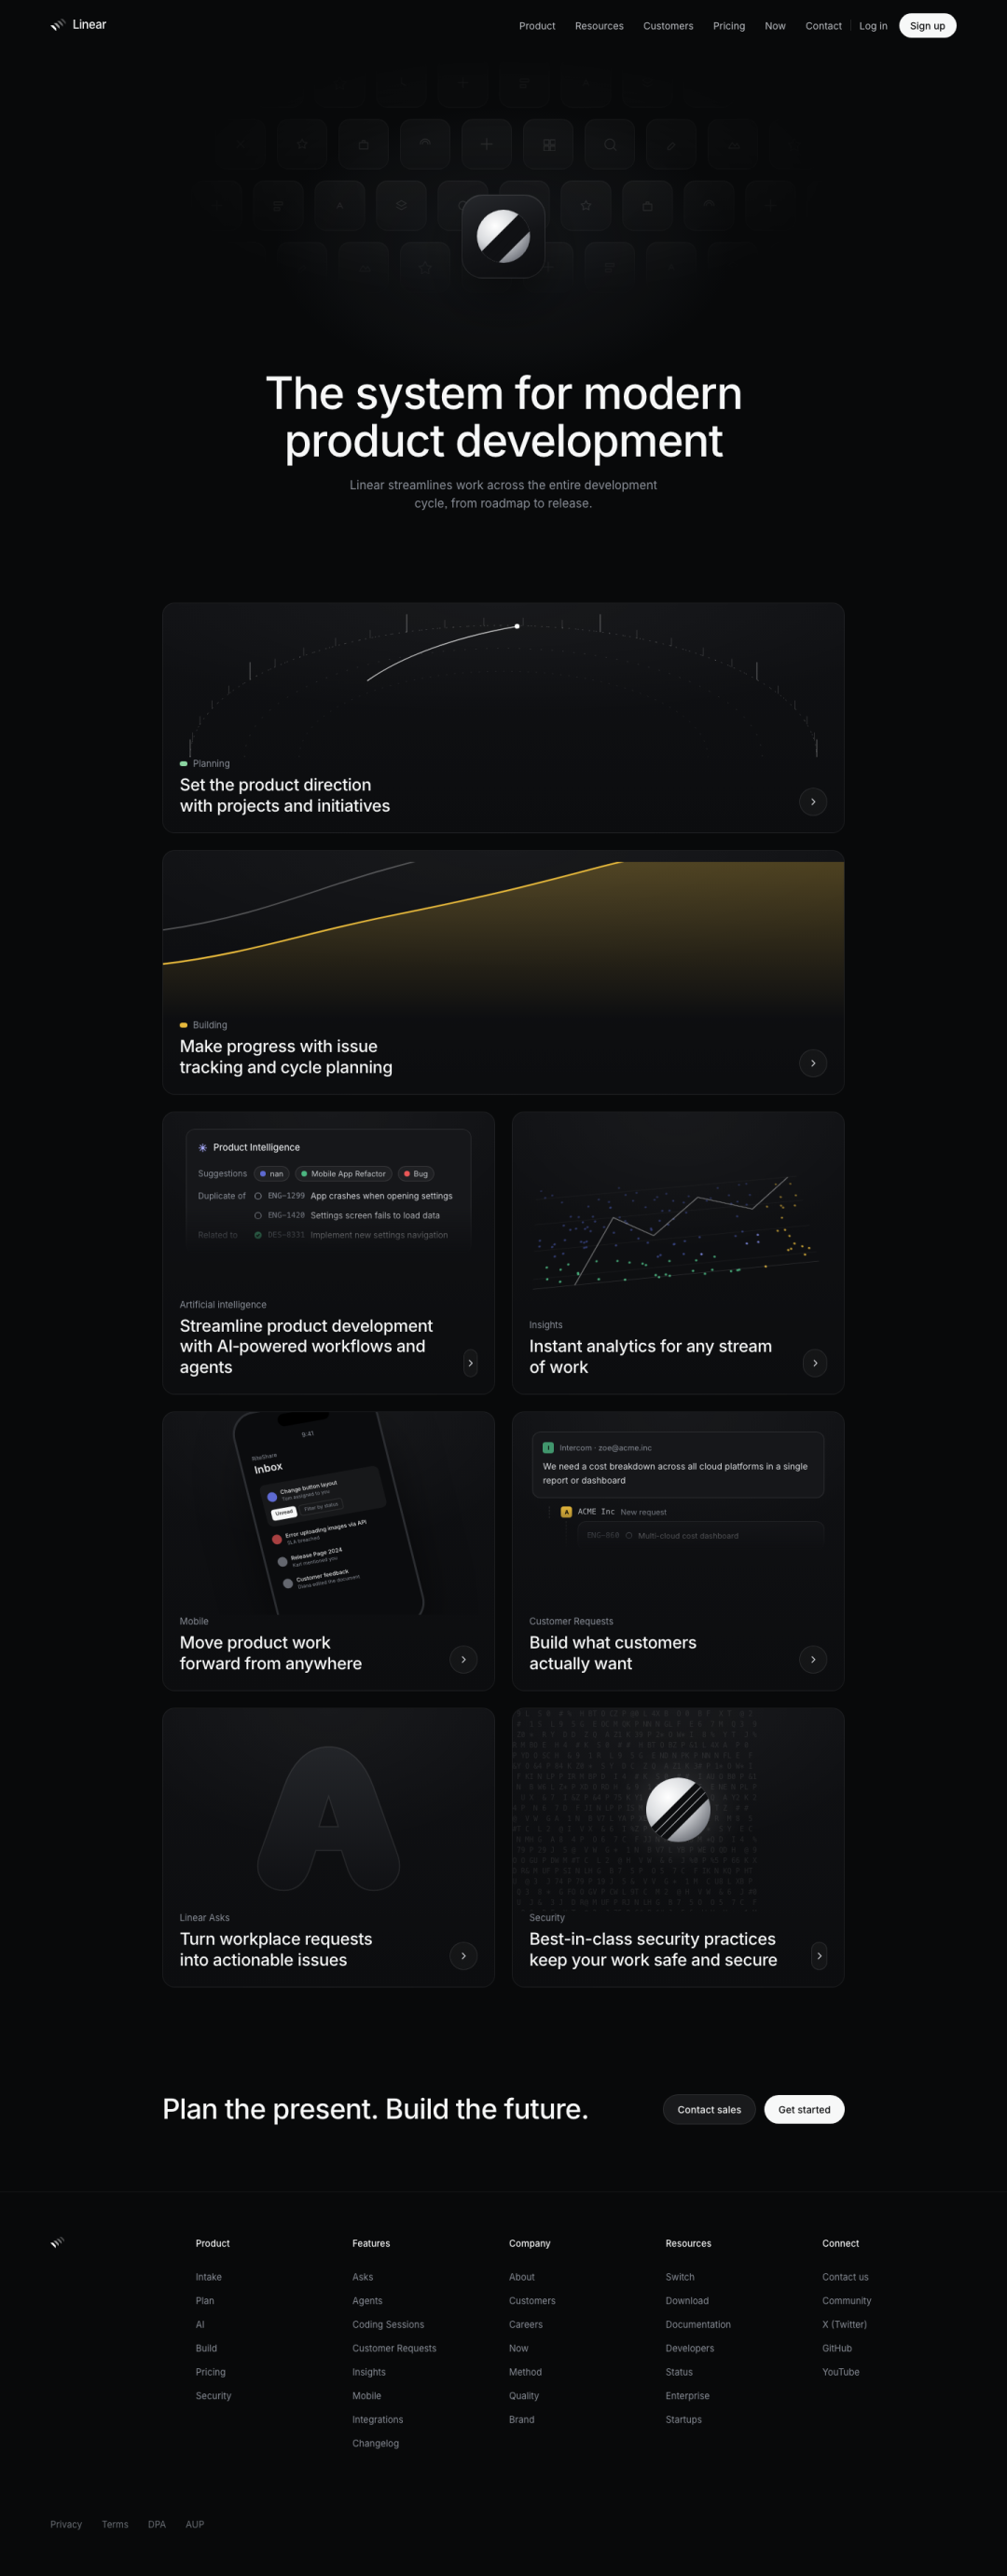 image-20260828000550449
还原度比较高的地方是页面结构、深色层次、字号关系和卡片节奏。差距主要在卡片内部的产品插画、局部留白和动画细节,离严格意义上的 1:1 还有距离。但一次修正就把完整长页和响应式都补出来,这个执行能力已经挺强了。
还做了一个稍微硬核一点的任务,我让 Qwen3.8-Flash 做了一个 3D 室内漫游、虚拟看房项目。
这组任务的难度明显更高。它需要同时处理 3D 场景、相机移动、家具模型、贴图、光照、风格切换和网页交互。
Qwen 最后用 Three.js 搭了场景,放进 25 个 glTF 家具模型、27 张 PBR 贴图和一张 HDRI 天空图,又加了环境光遮蔽、抗锯齿和阴影。它还用 Playwright 自动进入不同房间截图、收集控制台报错,最后把 201MB 的项目压到了 44MB 再部署。
我这里给大家录了个屏,看一下实际效果。
从这段 48 秒的录屏来看,客厅、卧室和厨房都能实际走进去,顶部按钮也能切换不同装修风格。房间之间的空间关系能保持住,切换风格以后家具和材质会跟着变化,已经是一个能操作的虚拟看房 Demo 了。
我用 Qwen3.8-Flash 搭配着千问办公写了一部 20 世纪的惊悚小说,Qwen 3.8-Flash 的文笔还不错。
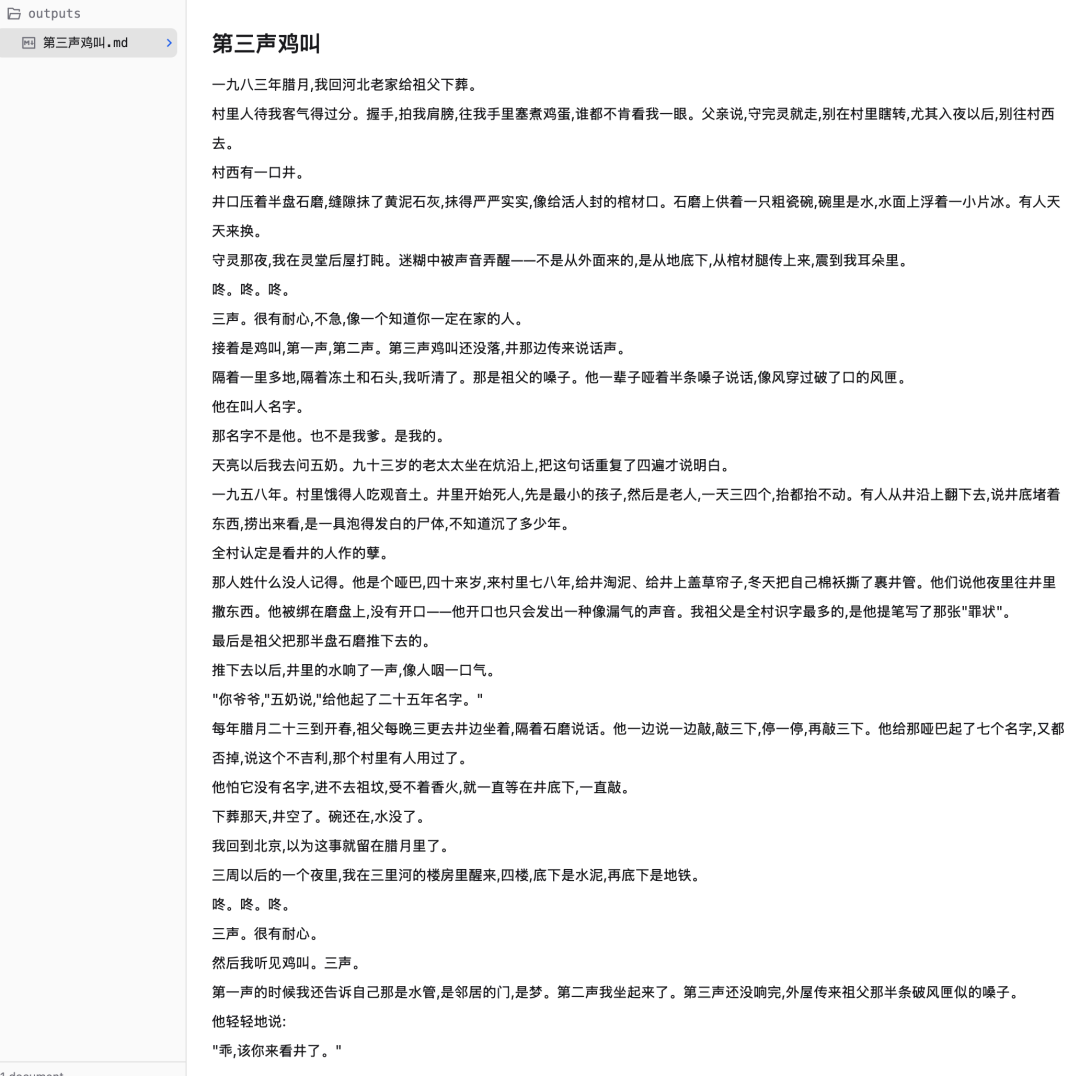 image-20260827222213904
故事从 1983 年回乡给祖父下葬开始,中间追到 1958 年的村庄旧事,最后再回到北京,把井底的敲击声接了回来,时间线没有写乱。
它写得比较好的细节是:半盘石磨、黄泥石灰、粗瓷碗、腊月结冰的井水,这些东西结合在一起,就把河北村庄的阴冷感就出来了。
最后一句“乖,该你来看井了”,把前面祖父守井的事情落到了主角身上,它没有靠血腥场面吓人,氛围、悬念和结尾都是完整的。
最后说一下价格问题。
价格现在是各兵家必争之地了,因为模型能力基本上快打平了,所以现在的关键是谁能以低价拿到最强的模型效果。
Qwen3.8-Flash 这次每百万 Tokens 输入 0.8 元、输出 2.7 元,这个价格已经低到可以放进大量、频繁的 Agent 任务里使用了。过去用旗舰模型跑一次长任务,都得肉疼两天,现在终于能豪横一把了。
Qwen 3.8-Flash 已上线千问 AI 平台对外提供API服务,每百万 Tokens 输入0.8元,输出 2.7 元。按 1 美元约 7 元粗算,输入价格大约是 Opus 4.6 的 1/44,输出价格大约是 1/65;相比 DeepSeek-V4-Flash 的忙时价格,缓存未命中的输入和输出也都不到 1/3。在真实任务中,Agent 工作需长输入(Input),缓存命中价格对综合成本影响大,Qwen3.8-Flash 缓存命中价格低至每百万 Tokens 0.1 元,将性价比打到极致,量大管饱,更适合大量、频繁的日常智能体任务。
如果这篇文章你觉得还不错,谢谢你的三连,也希望可以转发给同样关注 AI / 科技 / 开发效率的朋友。 我是 cxuan,我们下期再见。
相关链接:
技术报告:https://github.com/QwenLM/Qwen3.8-Flash-Next/blob/main/tech_report.pdf
技术博客:https://qwen.ai/blog?id=qwen3.8-flash-next
Hugging Face:https://huggingface.co/Qwen/Qwen3.8-Flash-Next?spm=a2ty_o06.30285417.0.0.1d73c921FsyOPe&file=Qwen3.8-Flash-Next
ModelScope:https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next?spm=a2ty_o06.30285417.0.0.1d73c921XAP2dV&file=Qwen3.8-Flash-Next
千问AI平台:https://www.qianwenai.com/models/qwen3.8-flash