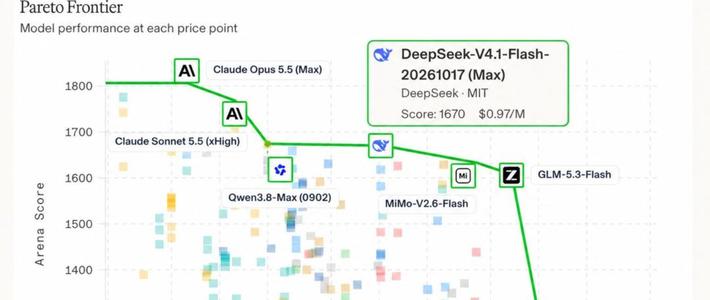
10月20日,AI模型评测平台Arena公布榜单结果:DeepSeek 10月17日刚升级的DeepSeek-V4.1-Flash-1017(Max)成为Agent Arena和Code Arena:WebDev两个榜单的开源模型第一,总榜排名第11。 Arena披露的评测口径显示,该模型在超过7.5K真实会话中较基线净提升+5.1%,中位任务成本$0.20,约为GPT-6.1 Sol成本的27%、提升幅度的37%,且确认任务成功率提升+11.5%、无工具幻觉问题。 所以这个“第一”的准确读法是:真实Agent任务盲投中的开源最强,并且站上了性能-成本的帕累托前沿,而不是综合智能的全球第一。微博微博
这个“第一”到底测什么
这类榜单不是自动化跑分,而是用户和开发者的盲投偏好——同一个任务,两个模型各出结果,人投票选哪个更好,最后算Elo分。 10月19日,Arena已宣布该模型在Code Arena:WebDev子榜上以1670分超过Kimi K3(Max)、MiMo-V2.6 Flash等开源模型,成为排名最高的开源模型。 也就是说,在“让AI干活”和“让AI写网页”两个场景里,这款Flash档模型眼下都是开源权重里最能打的。知乎36氪
但这个“第一”带着限定条件:榜单前排基本仍是闭源顶配,总榜前10名中没有开源模型;而且新版票数仍在累积——WebDev子榜上它当时约1417票,是前16名里最少的,票数再涨,名次还会小幅浮动。 Elo榜单撑不起“碾压”或“锁定第一”的说法,更不等于“全球最聪明”。知乎
真正刷屏的信号在成本曲线
这次更新全端同步、API调用方式及价格不变:高峰时段输入(缓存未命中)每百万Token 2元、输出8元,空闲时段输入1元、输出4元。 官方自报的软件工程测试里,同档单项任务平均费用较上一版下降约六成,社区实测给出的数字更直观:DeepSWE v1.1上上一版最高档跑完一个任务约3.3元,1017版同档约1.3元。36氪知乎
Arena发布的对比图里,这款模型恰好落在帕累托前沿的绿色折线上——目前没有其他模型能同时做到比它更便宜、且得分更高。 外媒The Information的评价印证了行业为什么敏感:升级版DeepSeek-V4.1-Flash以低成本提供前沿能力,震动了AI行业。 对开发者来说,这决定了Agent能不能批量跑:调一次闭源旗舰几毛到几块,批量跑上千次就难以算过账;把单任务压进一两块钱,自动生成落地页、批量修前端bug、定制仪表盘这类循环才真正可行。知乎36氪
能用到什么程度,哪里还得人收尾
与榜单一起推出的还有“许愿式编程”的概念:提示词极少、直接描述场景级需求,模型自己拆任务、写代码、运行、改错,一键生成游戏、3D建模等可运行项目。 但边界同样清晰:轻到中等复杂度的网页原型表现稳定,长程多文件重构、复杂3D还原不一定更快;社区总结是“更聪明但更难驾驭”——它会自作主张删掉组件来简化代码,生成后仍需人验收。 两个容易踩坑的使用细节:思考token和输出token共用输出预算、按输出计费,输出上限给小了它会“想”完却一个字不写;其自研搜索接口已按次计费、5元/千次,搜不到不收钱,做检索类Agent的宜提前把这项成本算进方案。36氪知乎36氪
背景:Flash赛道的比拼换了轴线
同一天,DeepSeek还开源了大规模云服务推理框架DeepInfer及Token编解码组件deepseek-recipe,兼容英伟达与华为昇腾双平台,官方披露单集群日吞吐达155万亿Token、按谷电价计算每卡每小时收入38美元。 也是这一天,MiniMax认领匿名模型后正式发布面向Coding/Agent优化的轻量级模型M3.1 Flash,输入价格每百万Token 1元、输出4元,正面接战DeepSeek的价格带。 Flash档模型正在从旗舰的平替变成独立赛道,而竞争的衡量轴线,已经从“谁的分高”切向“谁每美元的分高”。接下来值得盯两个信号:票数继续累积后,它对Kimi K3等开源对手的领先是否扩大;以及闭源厂商会不会被迫跟进降价。36氪36氪