"提速35%"能做什么?先纠正一个容易误读的地方:这不是相对云端语音服务的提速,而是推理引擎对模型原生运行时的领先幅度。本地运行 AI 模型的开源平台 Ollama 于10月24日宣布,其 Mac 应用正式支持文本转语音(TTS)生成,Windows 和 Linux 版本随后跟进。 首批接入的语音模型是语音AI公司Gradium旗下的Phonon——也是该公司官网公示的首个开源端侧TTS系列。 官方测试显示:在MacBook Pro M5 Max上,借助苹果自家MLX框架加速,Ollama的Phonon推理比"第二快引擎"Gradium自有运行时快35%。IT之家Gradium官网Ollama官方博客
真正改变创作者节奏的是速度与流式的组合:本地聊天模型的回复被管道传给Phonon时,音频在第一、两句话就绪后就开始播放。 这项能力目前只要求Apple Silicon和Ollama 0.40.9及以上版本。Ollama官方文档Ollama模型库
口播流程从"等导出"变成"边写边听"
Ollama给出的入口都指向同一件事:语音输出第一次像拼写检查一样嵌进本地工作流。
第一个是官方演示的管线:本地聊天模型的回复直接管道传给Phonon,文本流到哪一句、就读到哪一句,写脚本和听效果不再是两个环节。第二个是命令行落盘:`ollama run phonon “文案” > speech.wav`直接导出音频文件,输出为24kHz单声道。 IT之家在国内报道中把这组能力概括为"数据不出门"——推理全程在本机完成,文本无需上传。 第三个是API:开发者可以通过兼容OpenAI的接口,为现有聊天机器人和语音Agent添加本地语音输出,已按OpenAI SDK写好的代码只需改一处base URL即可从云端TTS切到本地。Ollama官方博客IT之家RTE开发者社区
35%本身在单条成片里很难被感知,它的意义在于余量:引擎级提速与流式生成叠加后,"改一版文案、重听一版配音"的循环从分钟级压进秒级。
提速的账本:快过谁、快多少、准不准
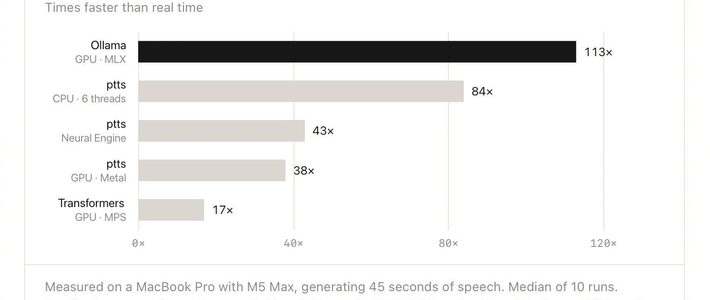
官方吞吐图给出了完整账本:Ollama的GPU·MLX模式达113倍实时,Gradium自有运行时ptts的CPU模式为84倍、神经引擎模式仅43倍,Hugging Face Transformers参考实现17倍——113除以84,恰好是标题里35%的来源;中文媒体"比原方案最高快35%"的说法也出自这一组实测。 测试条件是单一机型M5 Max、生成45秒音频、取10次运行中位数;ptts落败的底层原因在于它以CPU 8-bit权重、神经引擎fp16、GPU f32的混合方式执行,而Ollama直接以bf16跑模型。Ollama官方博客RTE开发者社区
快的前提是准:官方准确率图上,Ollama与Transformers参考实现的词错误率同为1.2%——用Seed-TTS英语集200个句子生成音频后,再以Whisper large-v3转写比对。需要留意的是,以上数字均为Ollama自测数据,截至10月27日国内传播发酵时尚无第三方复测,其他机型的幅度不宜直接套用官方结论。
三个边界,比速度更影响你用不用
最直接的:首发五种语言不含中文。Ollama对这组语音模型的定位是"以五种语言、数十种音色朗读文本",英、法、德、西、葡,默认模型为英语——做中文口播的团队目前拿不到即插即用的本地配音,这轮重塑最先发生的是英语和出海内容管线。Ollama官网
其次是商用许可。默认31M英语模型采用Apache 2.0,可商用;所有40M模型(含五语multilingual包)为CC BY-NC 4.0,仅限非商业使用——首发可商用的只有英语31M这一档,想用本地模型给商业项目配法语、西语旁白,目前许可不允许。 官方文档注明,默认包已附带Gradium的Zoey、Easton、Freya等多个英语音色。Ollama官方博客Ollama官方文档
最后是运行条件。模型本体很小,在M5 Max上加载后占用最高约141MB,门槛几乎不在硬件,而在上面两条边界。Ollama模型库
对内容创作者,这次更新把"写稿—配音—试听"整条链路收进一台不联网的Mac;下一个值得盯的节点,是官方对中文语音支持和Windows/Linux跟进的披露。