这一周的知乎、小红书和B站,“本地部署"话题下面刷得最多的三个字是:Token自由。有人说"终于不用惦记余额了”,有人说"本地部署都是噱头",吵得最凶的那条问题底下,32条评论分成了两派。但很多人没注意到,账本的对手盘这半个月悄悄改了价——云端套餐已经把"每百亿token"的实购价,压到了比显卡电费还低的位置。
先把结论放这儿:如果你的本地部署预算表里写的是"省钱",这笔账这个月被云端掀翻了;如果你缺的是云端"不给的那批token",照买——但别把预算表写成省钱。
一、云端先把账掀了:从"目录价"到"套餐价",实购价掉到四分之一以下
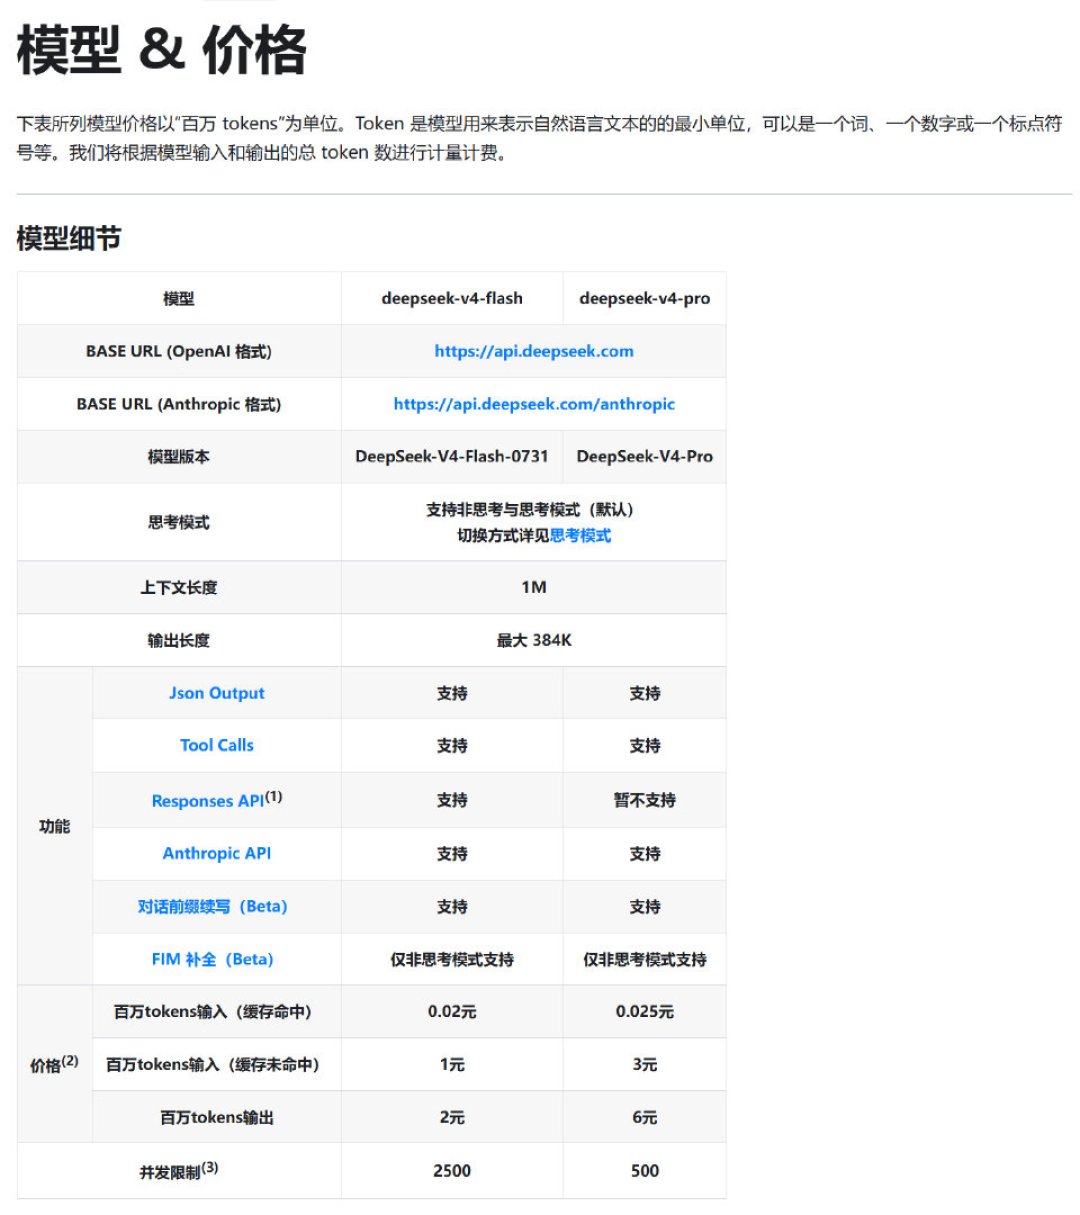
独立开发者陈随易10月26日在知乎晒了自己的实测账单:opencode 70块/月的Base套餐,近10天跑了36亿token,配额只用到80%;按他的口径粗算,套餐满负荷约50亿token。对照DeepSeek官方API"1.6亿token十块钱"的目录价,50亿token官方价要300元上下——同一个V4.1 Flash,70块撬动300块。 折算单价:套餐约14元/十亿token,目录价约62元/十亿——“用云端的真实价格”,已经不是你去背API目录价能算出来的了。知乎
低价线还在往下探。10月27日的知乎回答里,opencode的DeepSeek 4.1、GLM 5.3现在是免费的(上下文限200K);当天微博也有网友嘀咕,“免费deepseek感觉额度变少很多,可能登的人太多了撑不住了吧”。 再往前,彭于晏9月底那篇V100实测文里就记了一笔——Qwen3.8-Flash在QCoder"已经免费很多天了"。 各家Flash白菜价之后,此后你算本地部署省多少钱,基准价都得按这个改,而不是按两年前的印象里那个"API很贵"。微博知乎
二、卡侧的账:你"白嫖"的每一秒,电表都在转
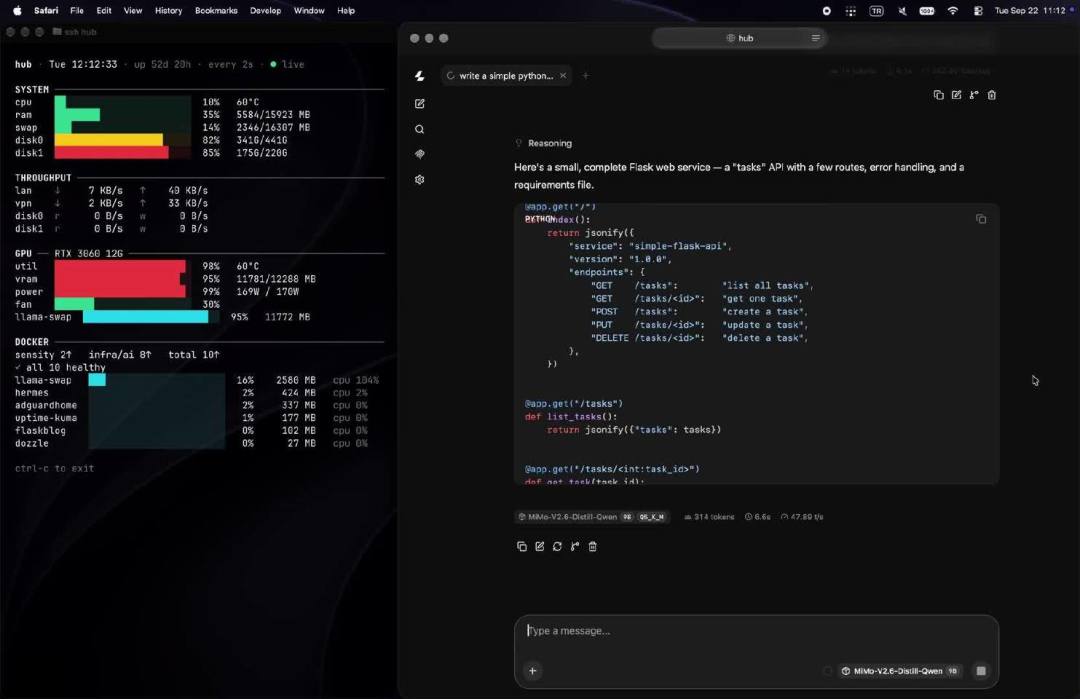
"本地不要钱"是最大的错觉——显卡每吐一个token,电费都在跑。拿社区实测口径粗算(数量级估算,非精算):
唯学可悟10月22日晒的5999元新卡RX 7900 XTX(24G显存),跑Qwen3.5-27B Q4_K_M量化,权重全装进显存、上下文开到96K,生成速度30 Token/s左右。知乎
彭于晏那张2888元上车的Tesla V100 32G,用llama.cpp原样跑只能到最高50多 tok/s;换上魔改的Ninfer定制引擎后,写代码速度150~200 tok/s都很普遍——但这已经是"给10年老卡做外科手术"的结果。知乎
按解码50~100 tok/s、整机功耗350W、居民电价0.55元/kWh折算,纯电费就是约540~1070元/十亿token,是70元套餐单价(约14元/十亿)的40到75倍,是官方目录价的9~17倍。再叠上折旧:5999按30个月摊约200元/月;叠上能力折损——码师9月底那篇对比给过一句狠话:本地能跑的和API顶级模型差一到两代,“这不是跑分差距,是实际任务完成率的差距”。 速度差也是现成的:彭于晏实测llama.cpp一个鹈鹕测试要25分钟,Ninfer压到12分钟,而同类任务云端订阅5分钟以内。 本地token的"免费",单价算上电费和折旧后并不便宜,算上能力差和速度差更不划算——"省钱"这个理由,在云端套餐价时代已经基本不成立。知乎知乎
但这句话的强度只能到这里,别过度解读:低负载间歇使用时,卡的折旧是沉没的、电是按次走的;这笔账只对"准备为省钱专门买卡"的人成立。
三、真正让本地赢的,是三种"云端买不到"
评论区里给本地派撑腰的,恰恰都是"钱买不到"的场景——这也和福州那位网友的口径一致:“本地部署都是特化需求,没法算经济账”。知乎
数据不出门的:小红书工厂主童公10月27日的账本很典型——客户图纸、工艺参数、报价单不敢扔云端,“一台二手 RTX 3090 + Ollama + Qwen2.5-7B”,整套本地AI知识库半年回本。 这类需求里,合规不是成本项,是一票否决项,云端再便宜也用不了。小红书
云端不给那批token的:知乎评论区里有人本地跑9B玩RimWorld、有人跑角色扮演和"无审查"任务。北京一位网友的评价很实在:本地跑模型"速度和智力都不如4.1flash,但是对于需要本地的任务来说,这是有和没有的区别"。 这个账不是"贵和便宜",是"有和没有"。知乎
真折腾党、学习党的:唯学可悟把A卡的坑全踩了一遍——ComfyUI缺FlashAttention加速、视频N卡15分钟A卡一个多小时、Qwen TTS只认CUDA——最后说"不后悔",因为买回来的是Linux、ROCm和排查依赖的能力。他自己的结论也写得清楚:如果主要需求是稳定干活,“那么 NVIDIA 依然是值得优先考虑的选择”。 折腾没问题,但请把5999记成学费,别记成省钱。知乎
四、双11前两周,三个提醒
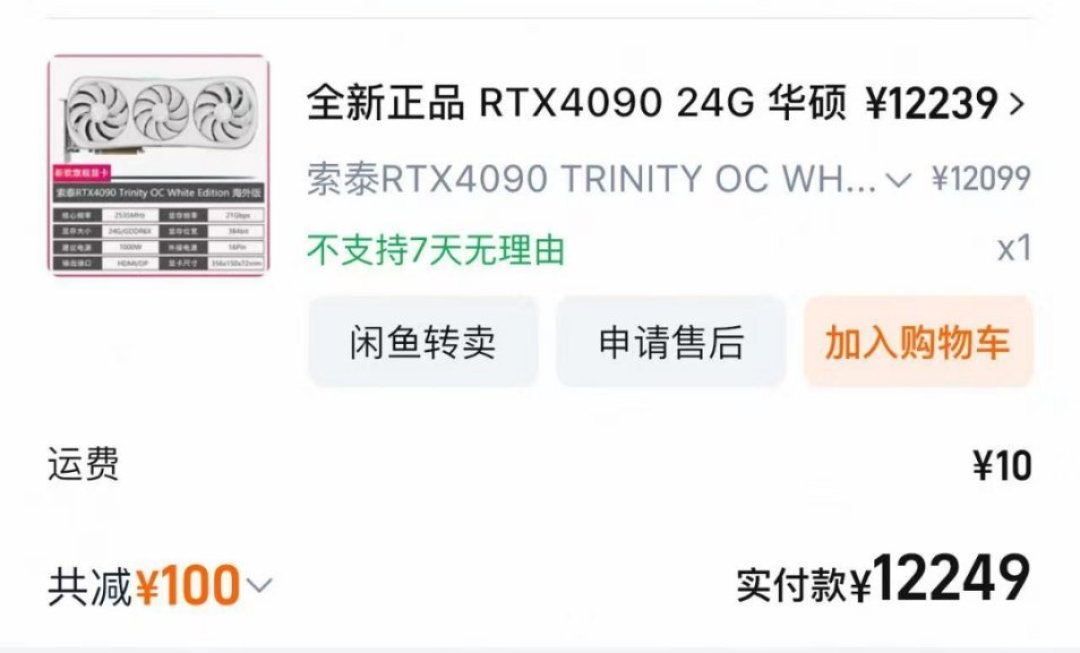
别追高。彭于晏的V100买价2888、如今已经涨价到4K以上;唯学可悟盯着的5070 Ti指导价6299、京东常年8000上下。 彭折腾一个多月后的原话:"非经验丰富的程序员强烈不推荐,别追高显卡当韭菜。"也有网友去年底晒出一张工作室装机订单:一块全新的RTX 4090 24G,实付12249元——“如今涨价涨的太离谱”。知乎微博
2. 二手水位比你想的浑。B站"九物AI生产力"10月25日把闲鱼26个显卡回收页切成240片逐片识别,整理了1054条真实报价:同一张RTX 4060 Ti,不同品牌口径的报价差了161%;同一张4080,旗舰比丐版贵39%。 双11捡3090之前,同一张卡至少比三家回收口径。哔哩哔哩
3. 免费窗口在倒计时。WorkBuddy的3500积分10月31日截止,opencode的"目前是免费的"里,"目前"两个字就是最大的变量。 最优动作顺序是先薅这两个窗口、实测自己真实的月token消耗,再去决定要不要买卡——很多人薅完才发现,自己一个月根本烧不到套餐额度的一半。知乎
五、那么双11到底谁该买卡:一张分档对照
月消耗几亿token以内、以聊天/写作为主的:别买。14元/十亿的套餐价,电都烧不出这么便宜。
图纸/代码/病历类数据不能出门的:买,按任务选卡。7B~14B的私有知识库,二手3090档(两千上下)够用;要舒服跑27B Q4再看24G的卡——N卡生态省心,A卡便宜24G但要预留踩坑时间。
要无审查、要24小时黑灯跑批、要本地多模态整活的:买,但预算表写"有和没有",别写"省多少"。
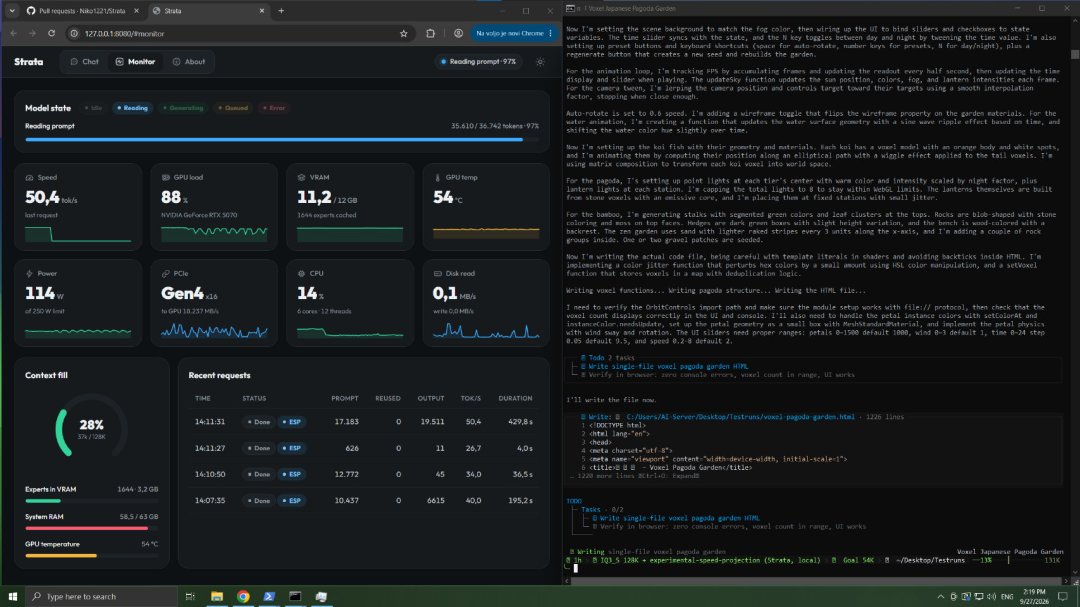
继续观察:免费套餐能撑到几月(撑不住了这笔账会翻回来);Strata这类把显存瓶颈转移给内存的引擎还在不在迭代(在,就更不用急着上大显存卡);Qwen4-27B级别的新开源模型能力到哪一档。知乎
本地部署真正的分水岭,从来不是"能不能跑起来"——教程区满屏的"装完了真香"都证明了装起来不难——难的是诚实回答一句:我缺的到底是便宜,还是云端不给的那批token。 评论区聊聊你的账本:月消耗多少token、走云还是走卡、双11准备动手吗?