这个"12个AI"出自B站一个从本届世界赛开赛更新至今的预测系列:UP主把S16瑞士轮的赛事数据喂给豆包、Kimi、GPT、Claude、Gemini、Grok、混元、DeepSeek、千问、GLM、MiMo、阶跃12个主流大模型,让它们逐轮预测赛果,再由比赛逐轮"对账"。第四轮预测视频发布于北京时间10月27日深夜,到28日上午播放量已逼近5万。至于"谁的眼光最准",这个系列自己公开的账本先给出了一个不那么给力的答案:UP主在视频简介里写明,12个AI上一轮的平均命中只有五成左右。 五成命中率,基本等同于抛硬币。真正值得较真的问题其实是:在"平均五成"的大盘之上,哪些模型的个别命中经得起复盘,哪些共识恰恰是被历史打脸最多的对象。哔哩哔哩
第四轮的票怎么投:内战一边倒,只有一场AI不敢说满
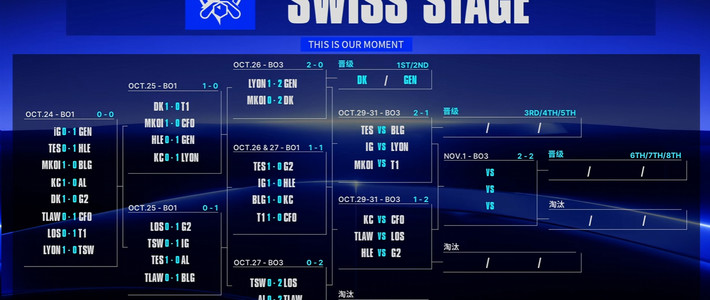
第四轮对阵10月27日抽签落定。2-1组是TES对BLG、iG对LYON、MKOI对T1,三场晋级战的胜者直接进八强。 1-2组是KC对CFO、TL对LOS、G2对HLE,输的一方当场止步十六强。比赛从北京时间10月29日凌晨4点开打,第一场是MKOI对T1。 三场晋级战加三场生死战共六场对决分三天进行,全部BO3,直到31日清晨G2对HLE收尾。知乎微博知乎
12个AI的投票结果相当干脆:观众在评论区复述的票型里,三场最没悬念的比赛全是12比0。 其中最受关注的LPL内战BLG对TES,也全票押向BLG;另一个独立运营的AI预测系列用四个大模型跑同一场,结果同样是全票BLG二比一,但给出的最高信心值只有六成。 票投得齐,不代表AI真有把握。分歧真正出现的地方在HLE对G2:豆包在这轮干脆判了HLE淘汰,12个AI给G2的胜率则给到了接近五成的49%,有观众因此在评论区吐槽,HLE刚被iG击败一场,AI就"太不把hle当人了"。哔哩哔哩哔哩哔哩
三轮账本翻下来:命中最亮的,都是逆共识的那几次
第一轮LPL四队0胜4负集体翻车,12个AI赛前没人算出这个下限,唯一的高光是几个逆势的判断:豆包神预言了iG首战被翻,Grok把BLG爆冷输MKOI的剧本全中。 第三轮,12个AI又全员看好HLE击败iG,结果iG再赢一场,UP主专门做了期视频让12个AI"挨个上台认错"。 同一轮预测里,Claude赌BLG翻车,结果BLG顺利击败了KC。哔哩哔哩哔哩哔哩哔哩哔哩
这份账本里反复出现在"对的那一边"的名字是豆包:第三轮判AL回家的预测已经应验,AL以0胜3局、一局未赢的战绩出局,LPL一号种子再次止步十六强。 而赛前流传的各家AI八强预测里,Kimi还认为LPL四队都能进八强,这个前提如今已不成立。 到第四轮视频的评论区,被顶到前面的说法是"信一手豆包",理由朴素得近乎玄学:它好几次蒙对了。 注意观众自己用的词是"蒙对"——这恰恰说明,三轮跑下来没有任何一个模型展现出稳定的领先,所谓"眼光最准",目前只是豆包凭几次逆共识命中暂时领跑。小红书微博哔哩哔哩
为什么准不了:数据越喂越保守,评价绑死在上一场
UP主在评论区回应过这套系统的输入:底层数据有近三年选手国际赛数据、近5年世界赛数据、近1年联赛数据。 此外还有每场比赛的BP与进程简报、选手能力画像、近两月排位数据,并叠加随机性算法、盲选机制和爆冷机制来防止模型抱团。效果并不理想:他自述纯看数据时所有AI都会选GEN夺冠,数据喂得越足,模型反而越不敢下与共识相悖的判断;反过来,它们又对离自己最近的证据过度反应——iG爆冷拿下HLE一场,HLE立刻被压到接近五五开。哔哩哔哩
这两夜对账:三个观察点
预测对不对,北京时间10月29日凌晨起自动揭晓。第一个看点是BLG对TES:这是瑞士轮内战,也是AI共识风险最高的一场,若TES胜出,就是这个系列里共识再一次被爆冷打脸。第二个看点是HLE对G2的生死战:这是票型分歧最大的一场,无论谁赢,豆包的"蒙对"账本和其余模型的保守账本都会当场重写。评论区那条高赞总结是,AI的评价强绑定于上一场。 这场五五开,就是对它最直接的检验。第三个看点是iG能否晋级:社区流传的前教练朱开的晋级预测,同样押iG、BLG、T1三队从2-1组突围。 人肉分析和AI共识撞进同一个答案,说明真正的变量全在"爆不爆冷"一侧,而不是谁强谁弱的方向。赛程层面还有两个与AI无关的确定项:第三轮战罢,DK和GEN已经率先锁定八强席位。 而TES与BLG无论谁赢,LPL的八强席位至少已经保底一席。需要说在前面的是,这个系列自我定位就是"图一乐",第四轮比赛在北京时间28日尚未开始,本文的"最准"只是基于前三轮已核验战绩的阶段性回答,最终答案要等31日清晨G2对HLE打完才有定论。哔哩哔哩小红书知乎