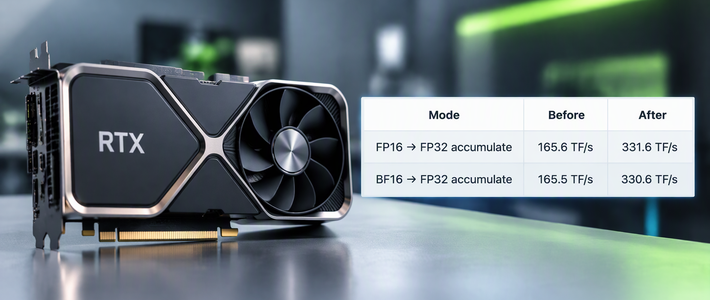
这两天,本地大模型圈被一条消息刷屏:你的 30/40 系显卡,可能一直被老黄按着半速跑。一张 RTX 4090,硬件没换、功耗墙没动,FP16/BF16 张量吞吐从 165.6 TFLOPS 飙到 331.6,近乎翻倍。RTX 3090 Ti 的 BF16 也从 87.5 干到 157.4,Wccftech、NotebookCheck 的跟进报道已经出来。知乎知乎
开源项目 gpu-unlock 10 月 18 日建仓。40 系分支 gpu-unlock-ada 两天攒下 2.7k star。二手市场已经有人把 3090 挂到万元左右。小红书知乎小红书
先别动手。"翻倍"是真的,但它翻倍在哪,跟你想的不是一回事。这个解锁只放开"FP16/BF16 输入 + FP32 累加"这一条路,最好的情况下,训练和部分计算密集的推理能提升 50% 左右。老黄用的开关是一组"速率选择寄存器",把 GeForce 的这条 Tensor Core 路径锁在半速——纯商业分段,不是物理极限。知乎知乎
解锁的方式也不改驱动:一个独立的 Linux 内核模块,在官方驱动接管显卡之前先把寄存器配置好,不用破解驱动也不用改 UEFI。更"野"的是执行手段——借 NVIDIA 自己签名的固件在 GPU 安全世界里跑,让老黄的固件"自己解锁自己"。微博知乎
然后是绝大多数人误解的部分:这波解锁,跟你的本地大模型出字速度基本无关。生成阶段是带宽受限的活,算力再强、内存供不上照样突破不了天花板。知乎
社区实测也对得上:vLLM 长上下文 prefill 快了 33~36%、首字等待降了 25%,但 decode 一段,12 个测试单元的波动区间全部重叠。说人话:第一字来得早点,后面一个字都没变快。知乎小红书
另外三盆冷水,一盆比一盆醒脑。
实测收益打折。指令吞吐翻倍,真实矩阵乘法只快 12~34%。持续压测时 SM 频率从 ~1720MHz 掉到 ~1330–1365MHz。30 系散热本来就紧,老玩家的原话是多等一会,别冒风险做变相超频。你最常跑的 llama.cpp Q4 量化,大多吃不到。知乎知乎小红书知乎
平台有墙。Windows 版改成 EFI 阶段执行,主板、BIOS、PROM 哈希全部写死编译,实机验证过的机器只有三个方案。解锁瞬间显示会黑屏一段。折腾前想清楚,自己是玩家还是小白鼠。知乎小红书
热度跑在收益前面。"万元挂价"目前只是个别报价样本。游戏帧率的提升至今没有一条经过核实。收益还没进你口袋,溢价先让你买单。小红书小红书
谁真能受益?拿 3090/4090 训模型的实验室和小公司是最直接的受益者。重长文本 prefill 的用户、跑 FP16 路径的 ComfyUI 生图党也能喝到汤,但社区读数挺分裂:B 站高赞的省流结论是 FP16 模型之外几乎没提升。3090 Ti 的 BF16 生图又有人测出 47% 到 59%。如果你的本地大模型主要是聊天、写代码,这次解锁的体验变化约等于零。知乎哔哩哔哩小红书
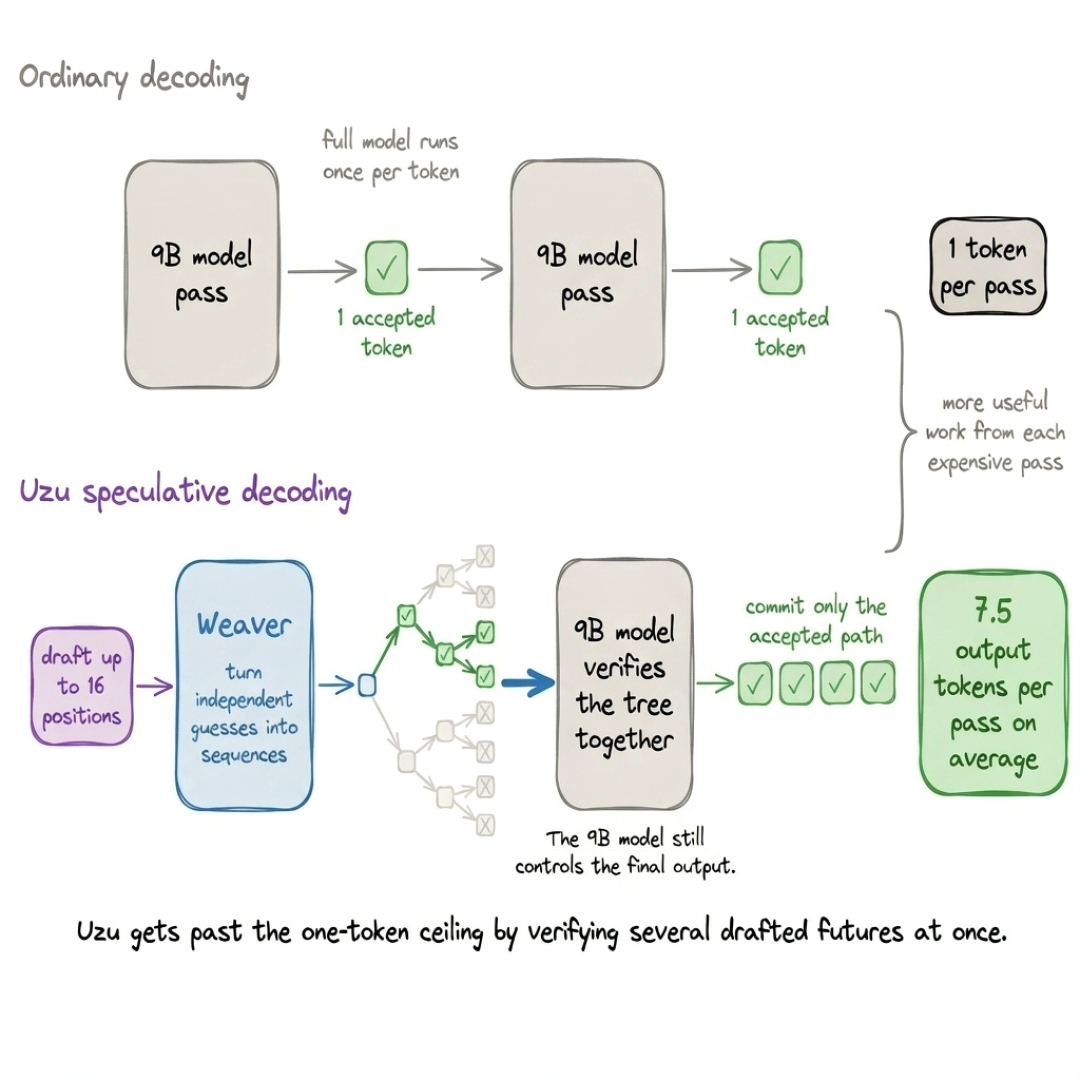
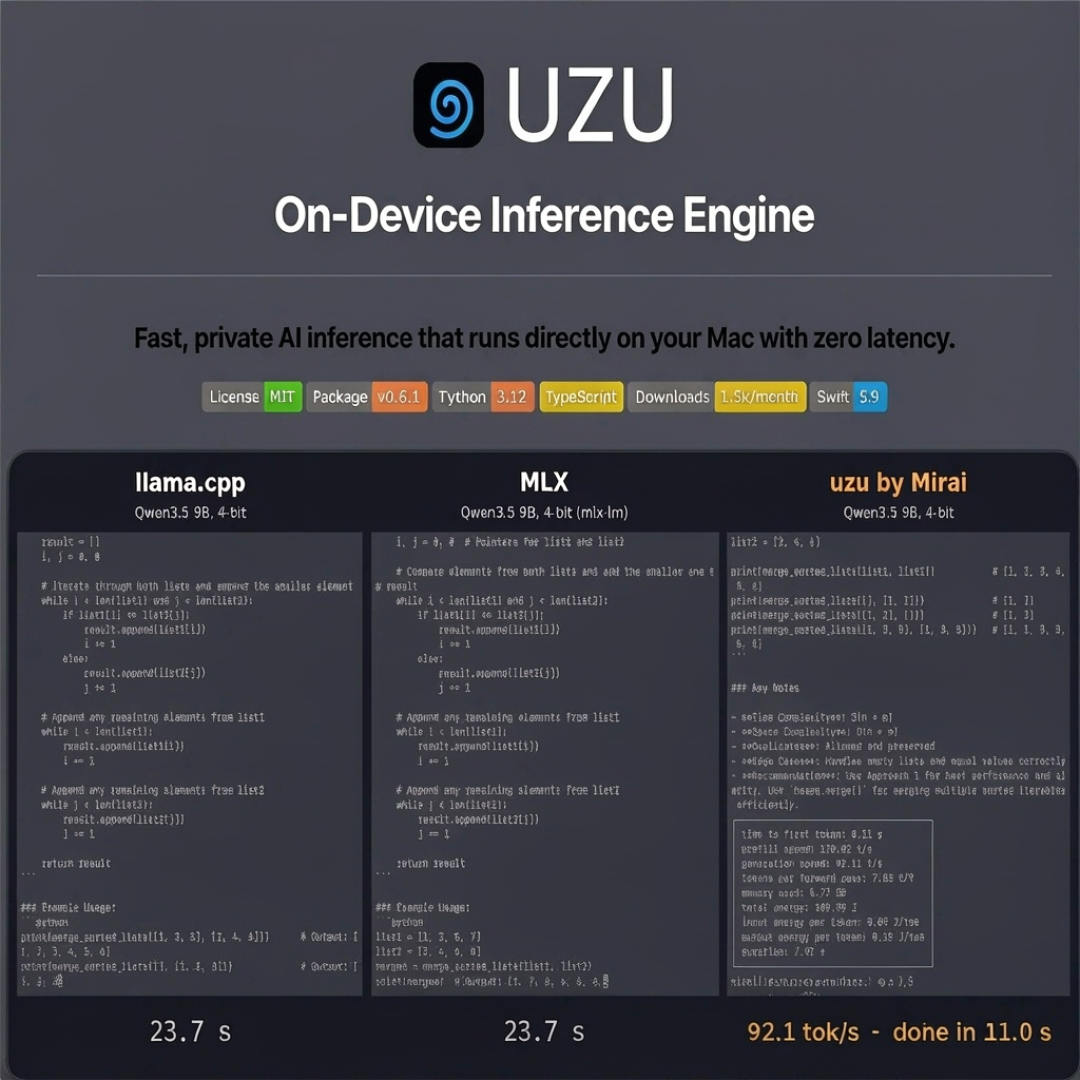
双 11 前真要花钱,建议花在瓶颈本颈上:显存容量和带宽——更大显存、统一内存小主机、把权重搬进内存的卸载工具,这些才决定"能不能跑、跑多快"。软件层面也不是没人硬闯带宽墙:Mac 上的推测解码项目 Uzu,同一台 M5 把 Qwen3.5 9B 跑到 92.1 tokens/s,llama.cpp 只有 22、MLX 25.1。路子不同,原理一致:正面打不过带宽,就用算法绕开它。知乎
一句话收个尾:这次解锁的是老黄的产品刀法,解不开的是物理规律。本地大模型想变快,先被解锁的应该是预期。