本地模型接上Claude Code真能干活了:标称速度别全信
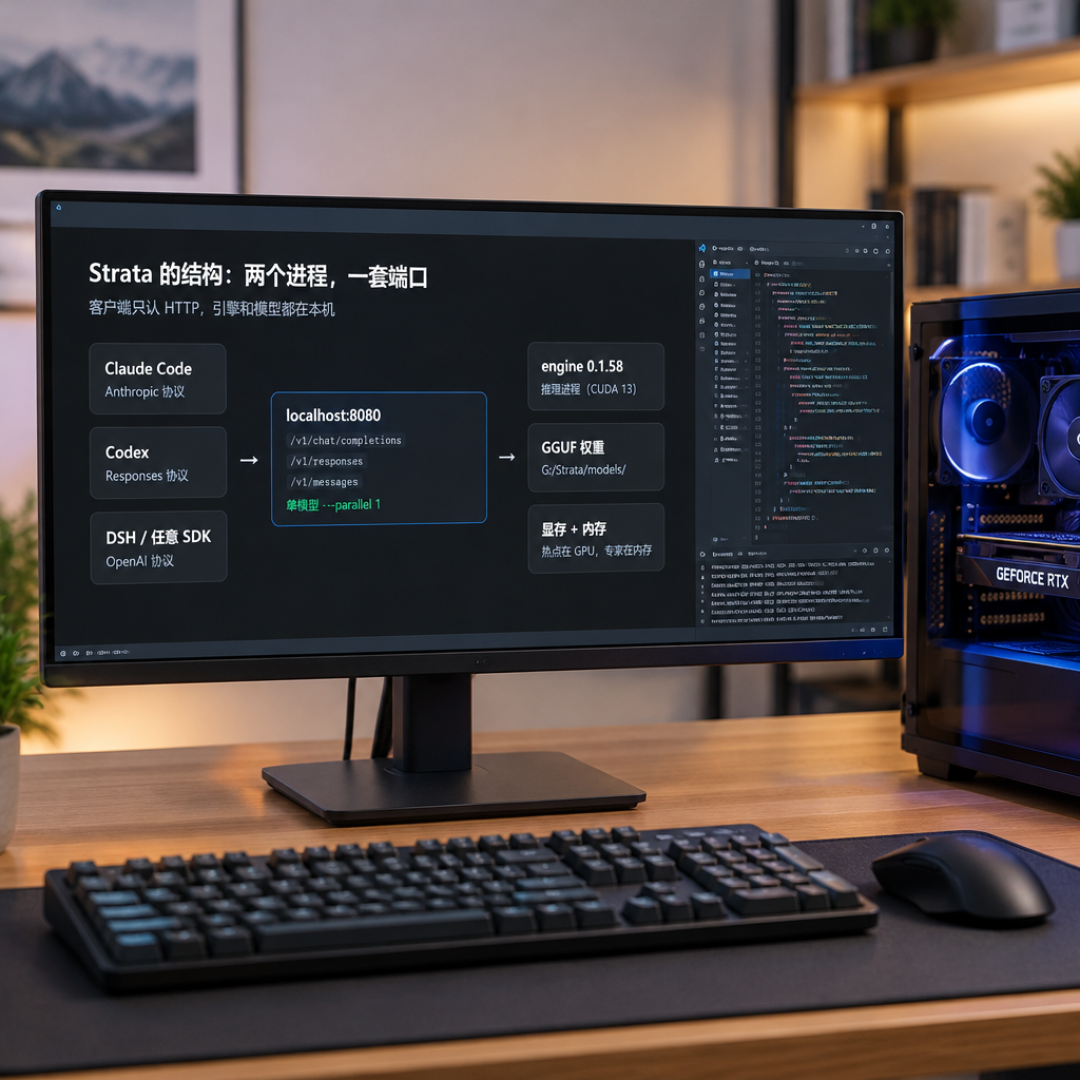
本地大模型圈这个月聊的话题变了:不再是“能不能跑起来”,而是“能不能接上编码客户端干活”。主角是个用 C++ 写的开源本地推理引擎 Strata,一键装完就能在自己电脑上跑大模型。它连客户端协议都直接对上:Claude Code 只认 Anthropic 协议,Codex 只认 Responses,同一个端口三种客户端都能直接接,不需要任何中间转换层。哔哩哔哩知乎
“能干活”已经有实测记录。有人的机器是套 X99 洋垃圾:E5 2673v3 搭笔记本版 RTX3060 12G,全套两千块出头,Strata 跑 IQ3_S 量化,预填充最高 700,输出平均 55-65,正拿它写 React 前端页面。另一位拿 64GB DDR5 加 5060 Ti 16GB 跑了两个月,结论摆得很直:本地部署能干活,但界限很明确。单文件代码、文档改写、批量脚本、离线分析,够用。知乎知乎
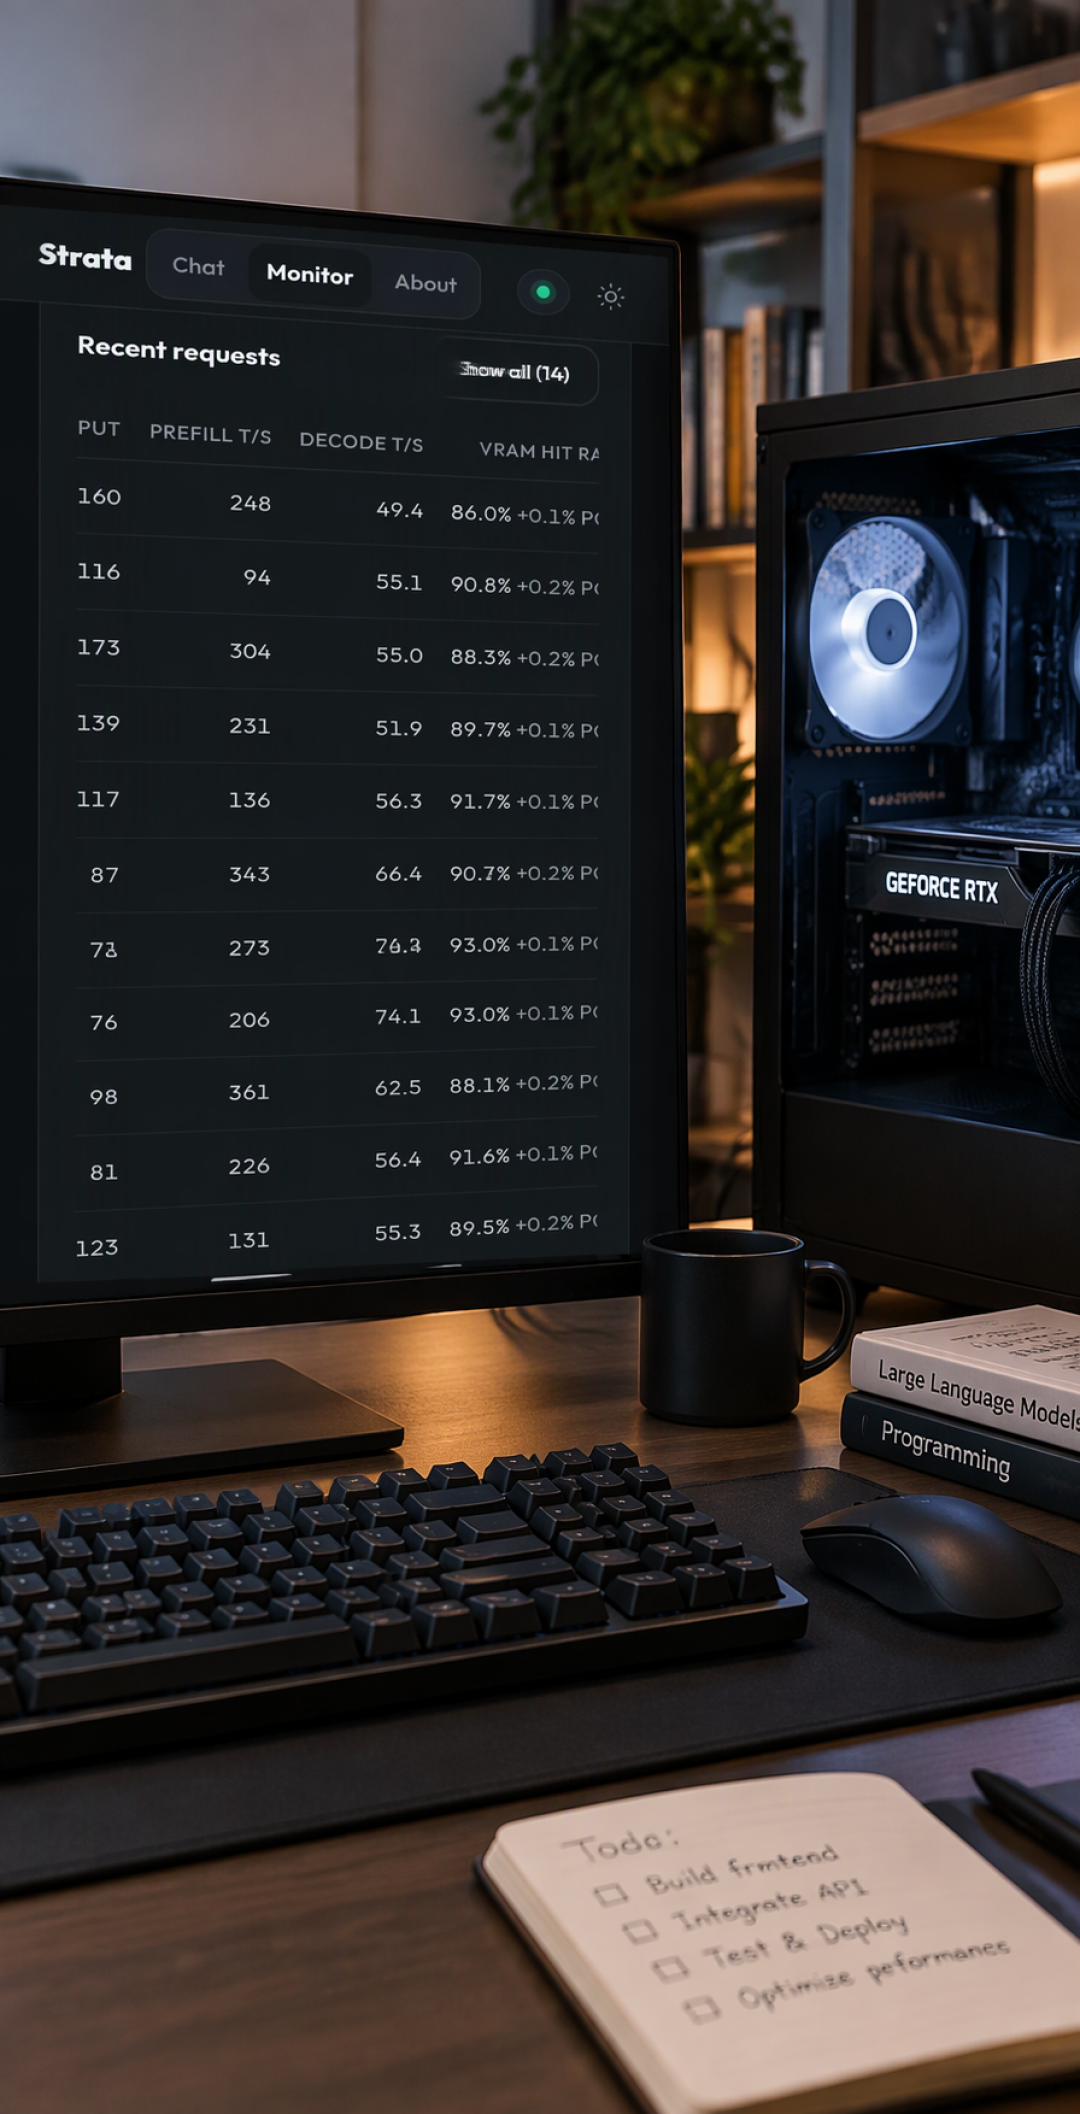
但标称的速度数字只能当区间看。Strata 跑推理分三层:显卡算、内存放专家池、固态补缺口。有人拿三张卡并排实测:同量化、同 128K 上下文,RTX 3090、4090、5090D 分别跑出 86–110、132–140、158–165 t/s——专家进显存,显卡带宽和算力说了算;挤回内存,总线加内存带宽就是速度地板。CPU 那关反而没那么要紧:显卡日报上手视频评论区最高赞的省流写着“不是很重要”。哔哩哔哩哔哩哔哩哔哩哔哩
硬件升级真正要花钱的只有三样,换卡、加卡、加内存。第一道坎是内存余量:84.3GB 的 IQ3_S 加载完只剩 4.4GB,开几个浏览器标签就开始换页,速度从 40 tok/s 掉到个位数。有人拿魔改 P104 试出反方向的经验:预填充太慢,输出速度不够,做不了 Agent 的本地大脑。哔哩哔哩知乎哔哩哔哩
第二道坎是长输出:一次让模型写 1794 个 token,花了 317 秒,写得长就是慢。第三道坎在内存账:一个只有 2.2GB 的模型文件,光是为了记住 128K 长度的 Agent 历史记录,KV 缓存就高达 18GB。模型文件大小从来不是内存预算。知乎知乎
接之前有两个小细节:一是自己下载的 GGUF 要用 --model-path 指目录,写成 --model 会先去 HuggingFace 校验权重,国内网络下必超时。二是一个端口同时只装一个模型,起新的之前得先停旧的。知乎
社区迁移是真的:有人建议把本地模型服务从 llama.cpp 换到 Strata,小红书那句“Ollama 拜拜”的帖子攒了一千多赞。边界不变:只想跑个 7B 模型聊天,Ollama 更省事;要接编码客户端、要跑 70GB 以上的模型,才是 Strata 这套更合适的位置。哔哩哔哩小红书知乎