你收藏夹里那句"请一步步思考,务必严谨周全",Anthropic 现在管它叫反模式。知乎
默认模型换了,顺手收走了"思考深度"的方向盘
11 月 14 日前后,Anthropic 把 Claude Opus 5.5 设成 Pro、Max、Ultra、Team 全部付费计划的默认模型。公告里有一句比降价更要紧:Opus 5.5 始终自主推理,按任务和你选的 effort 档位自动调整深度,无需再明确指示"深入思考"。官方内部测试的说法是,去掉这类短语后响应启动更快、质量没有可衡量的下降——这是厂商口径,但意思不难懂:模型自己知道什么时候该多想。钛媒体知乎

价格也动了。Opus 5.5 的 API 是每百万 token 输入 4 美元、输出 20 美元,比上代 Opus 5 的 5 美元和 25 美元便宜,缓存读取 0.2 美元;官方称典型负载下总运行成本低 40%、输出快 30% 以上。钛媒体知乎
旧咒语现在的代价是双份的
Anthropic 技术团队成员 Lance Martin 在 AI Engineer 峰会上把话挑明:think step by step、“请仔细复核你的工作”、“保持最大限度的严谨与周全”、专门辟一块草稿区教模型打草稿——放到今天的前沿模型身上,全是反模式。知乎
代价有两层。明的一层是白烧 token,延迟变长、账单膨胀。暗的一层更麻烦:指令冲突。老模型指令遵循弱,提示词里两条规则打架,它糊里糊涂忽略一条还能跑;新模型对指令极其敏感,撞上矛盾规则会陷入逻辑纠结,输出质量直接掉。用他的原话说,那些曾给弱模型兜底的拐杖,如今成了绊倒强模型的绳索。知乎
Claude Code 官方文档说得更直白:think hard、think more 不是关键词,只会被当普通文字。真被识别的只有 ultrathink,而它自己都还没定论——文档说 Claude Code 只是往上下文加一句"多想想"、发给 API 的 effort 不变,10 月 26 日 2.1.311 的 changelog 却说交互式终端走 Anthropic API 时这一轮真按 xhigh 跑。两处对不上,以你手上的版本为准。知乎
顺带一句,Anthropic 每发布一个新模型,官方那份提示词指南都会跟着更新一遍。旧咒语失效不是个例,是新模型上线后的常态。小红书
档位值多少钱,官方图表给了读数
effort 五档:low、medium、high、xhigh、max。Opus 5.5、Sonnet 5.5、Haiku 5.5 默认都是 medium,而且 thinking 关不掉——想省钱只有一条路,把档位调低。知乎
Anthropic 官方 FrontierCode 图的横轴不是 token 单价,而是跑完一整道题的总花费。知乎
Opus 5.5:medium 30.1%/1.70 美元 → high 34.5%/2.42 → xhigh 43.4%/5.18 → max 45.5%/12.82
Fable 5.2:low 34.2%/2.10 → medium 37.6%/2.48 → high 45.3%/6.72 → xhigh 49.1%/14.19 → max 45.6%/44.70

对着看:Opus 5.5 从 medium 拉到 max,分数涨 15 个点,价钱翻 7.5 倍。而 Fable 5.2 开 high(45.3%/6.72 美元)就跟 Opus 5.5 拉满(45.5%/12.82 美元)几乎打平,花费约一半。SWE-bench Pro 上更明显,Opus 5.5 的 xhigh 比 high 只多约 1.4 分,花费是 2.5 倍。知乎知乎哔哩哔哩
所以 Lance Martin 给出的结论很反直觉:高阶模型配低思考力度,往往比中低阶模型死磕高力度更便宜、也更好。知乎
三句能照抄的
一,拿不准就 Opus 5.5 + medium,这也是 Claude Code 的默认组合。哔哩哔哩
二,结果不满意别先换模型,顺序是:让它能自己验证(测试、构建、调接口的脚本)→ 把 effort 升一档 → 最后才换上一级模型。哔哩哔哩
三,能自动判对错的批量活,全部先用 low 跑,只把没通过的用 high 重跑。同一组 SWE-bench Pro 题,这么跑通过率约 97%、每题 0.17 美元;全用 high 是 95.3%、0.29 美元。哔哩哔哩
两个坑,一个自查
坑一:`~/.claude/settings.json` 里的顶层 `effortLevel` 是老格式,只对 Opus 5 及更早模型有效,Opus 5.5 会直接忽略、按 medium 跑。你以为开着 high,其实一直是 medium。在会话里执行一次 `/effort high` 重新保存就行;写在项目 `.claude/settings.json` 里的顶层 `effortLevel` 对所有模型有效。知乎
坑二:配置文件里的 `effortLevel` 只接受 low、medium、high、xhigh,不接受 max。`/effort max` 只管当前会话,想长期 max 得设环境变量 `CLAUDE_CODE_EFFORT_LEVEL=max`。知乎

自查:Claude Code 内置了 prompt-audit。`checkup prompt-audit` 查本地配置和 Skills,`claude api prompt-audit` 扫调用 API 的业务代码库,会自动标出提示词反模式。知乎
别把一张图当真理
档位已经是行业通用旋钮。Gemini 4 Hydrogen 有 low 到 xhigh 四档、默认 high。MiniMax M3.1-Flash 五档、省略时默认 max。钛媒体知乎
但上面那些分数和花费,基本都是厂商自测和官方图表的口径,厂商的评测结论替代不了你自己的业务验证。钛媒体
而且不同评测的甜区差得很远:WANDR 上 Fable 5.2 开 medium 就追平 Opus 5.5 的 max,成本约四成;HLE 上 low 就追平,花费不到十分之一;到硬件类的 BenchCAD 才需要高档拉开差距。知乎
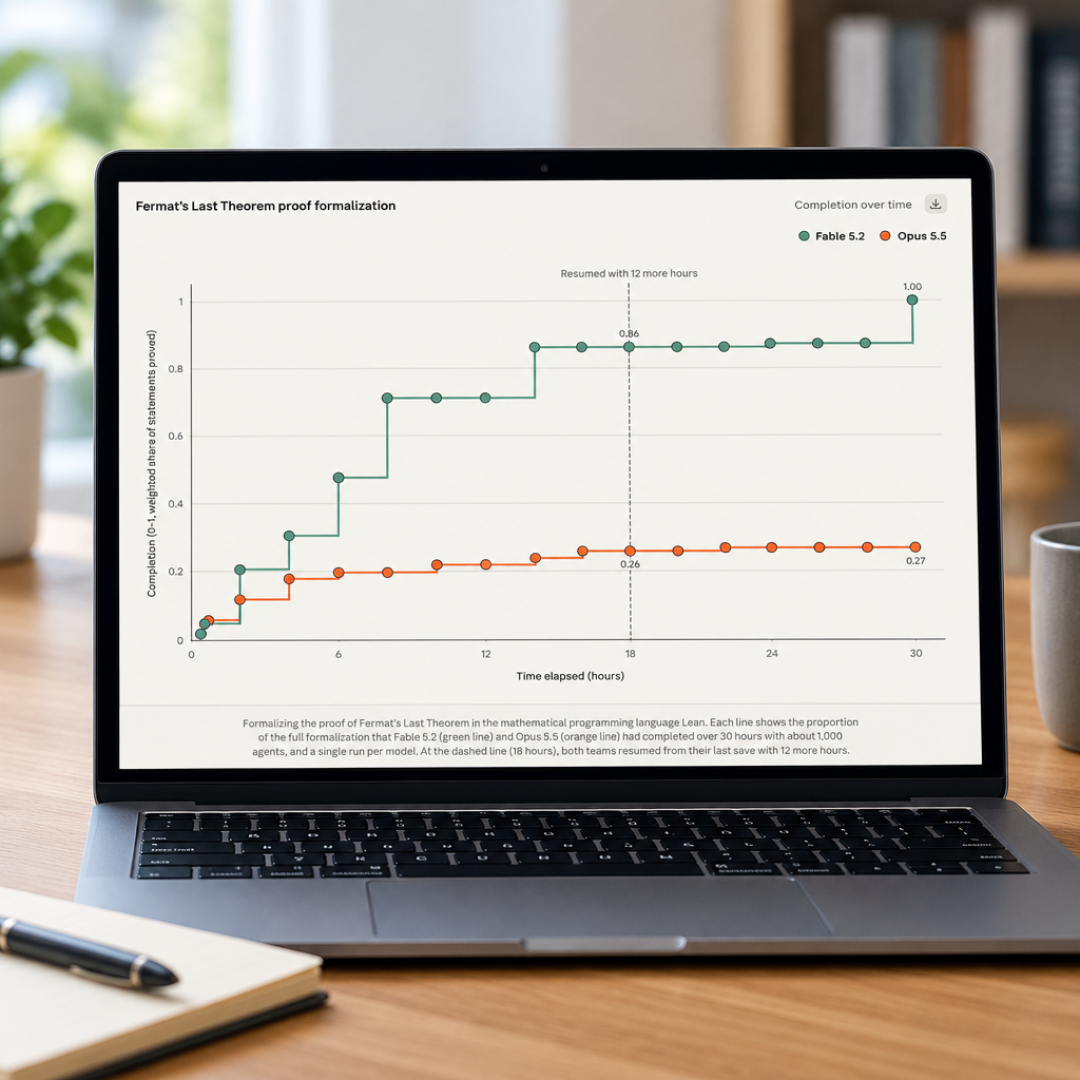
所以结论只能说到这儿:咒语确实该清了,档位确实比单价更值得算。至于哪一档适合你,拿自己的任务开两个会话各跑一遍,看 `/usage` 报的用量再定。哔哩哔哩