



 深耕汽车兴趣领域




24
31
世界首颗!我国自主研发的AX100芯片成功流片
2026-11-16 21:29:12
0点赞
0收藏
0评论
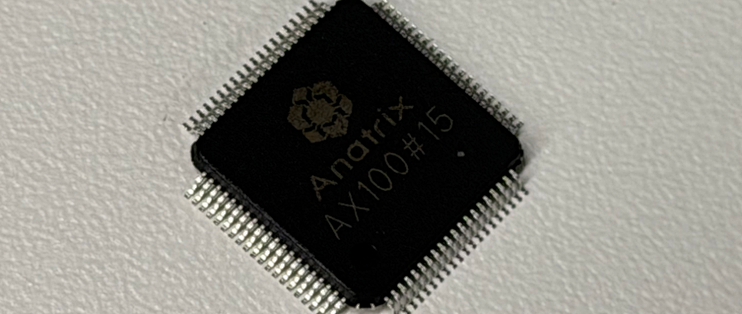
据科技日报消息,11月15日,模拟计算芯片公司安纳智芯自主研发的AX100芯片已于10月完成流片,成为世界首颗全集成一步求解矩阵方程的模拟计算芯片。
测试结果显示,AX100单次矩阵方程求解时间小于100纳秒,单次计算功耗约80毫瓦,结果符合理论仿真和设计预期。
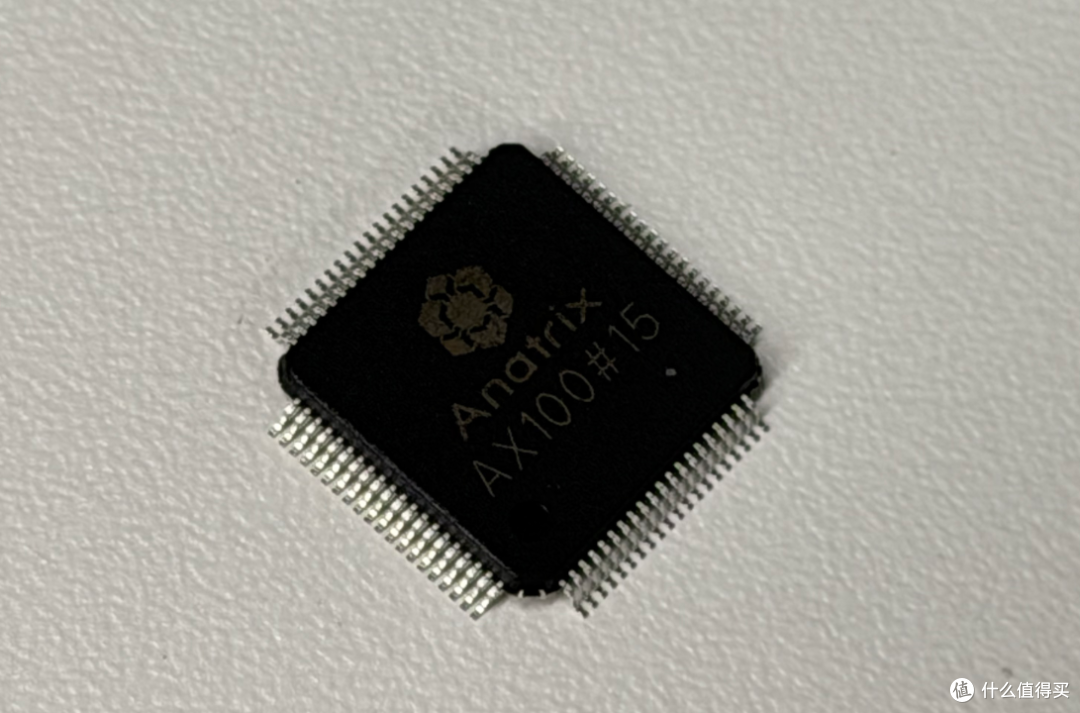
AX100芯片的核心思路,是把矩阵方程直接映射成电路。
这类电路依托欧姆定律和基尔霍夫定律,阻变器件承担权重和网络连接,负反馈结构帮助电路收敛到稳定状态。数字芯片求解矩阵方程时,需要把计算拆成大量乘加和多轮迭代,矩阵规模扩大后,计算量会快速上升。
以512阶矩阵方程为例,数字方案大约需要5亿次乘加,耗时可能达到数十至上百微秒。模拟计算则利用电路的物理规律并行工作,电路达到自平衡后一次读出结果,不需要像传统数字方案那样反复迭代。
不过,模拟计算并不是新概念,它长期受困于精度低、规模扩展难和可靠性不足。
传统模拟计算误差多在百分之一量级,进入矩阵求逆后,小误差还会被后续步骤放大,因此过去很难进入通用计算体系。
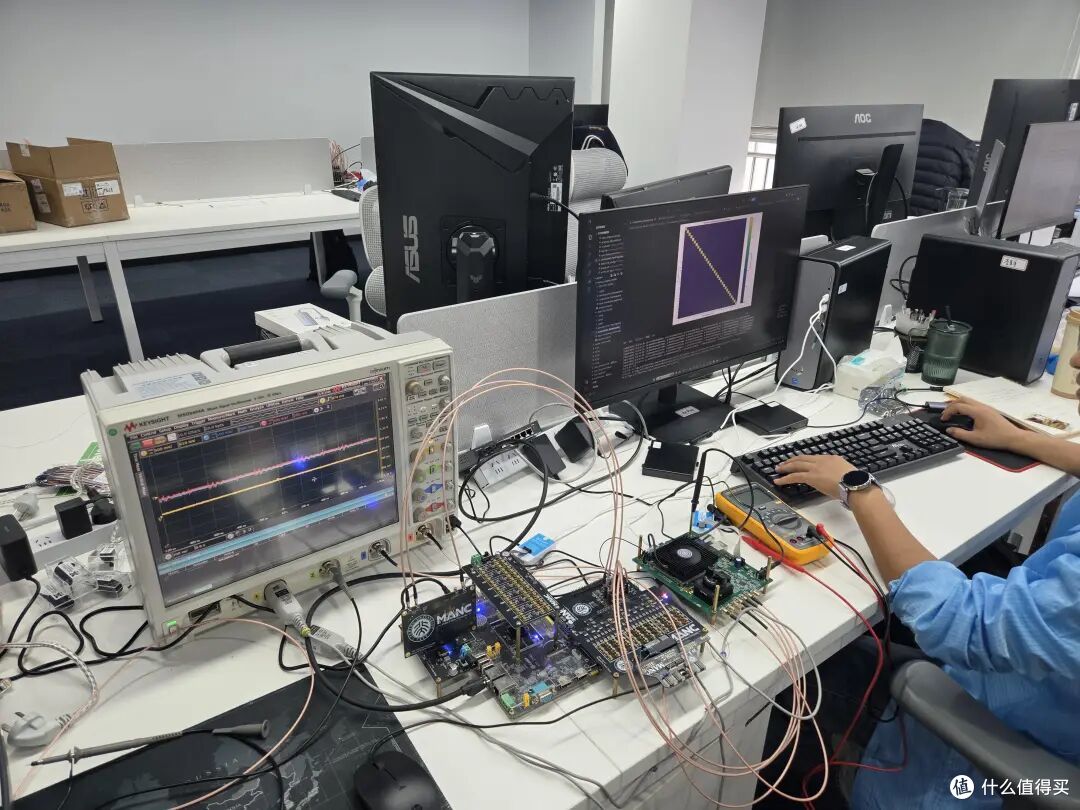
北京大学孙仲团队2025年10月在《自然・电子学》发表研究,基于阻变存储器芯片实现高精度、可扩展的模拟矩阵方程求解,把传统模拟计算精度提升5个数量级,并实现24位定点精度,10次迭代后的相对误差可低至10的负7次方量级。
论文中的阻变存储器阵列采用40纳米CMOS工艺平台制造,而AX100目前只披露采用成熟工艺,具体制程节点尚未公开。
安纳智芯已经在三类任务中验证AX100:
①大模型训练方面,团队在293万参数的Autoencoder模型和272万参数的Transformer模型上使用二阶优化方案,训练更新消耗分别减少92%和56%。
②具身智能方面,运动控制与规划端到端算法提速150%至500%,三维重建和SLAM核心算法提速200%至500%。
③无线通信方面,针对128乘128规模的信道格拉姆矩阵,AX100相比现有数字ASIC和GPU,等效吞吐提升20至207倍,等效能效提升27.6至61.3倍。
从技术路线看,AX100不是要完全替代GPU,而是面向矩阵方程这类高频、低延迟、低功耗需求提供专用加速能力。
安纳智芯成立于2025年11月,2026年6月披露完成数亿元融资,资本关注也集中在这条新算力路线,它不依赖最先进制程,这一点有助于降低制造环节约束,但成熟工艺并不等于产品已经量产成功。
后续还要看正式数据手册、客户实测、良率、可靠性和系统集成表现。只有这些数据经过更多客户和真实场景验证,模拟计算芯片才可能从实验室突破走向规模化商用。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~