先给结论:"小语种支持更好"不是国产模型被东南亚、非洲用户选中的原因——这个因果关系恰好是反的。 低资源语言处理至今是所有大模型的共同短板,斯坦福大学研究发现,当要求大语言模型处理斯瓦希里语、菲律宾语等低资源语言时,准确率比处理英语时低30%~50%。 真正在这些地区被反复使用的,是另一样东西:开源权重。当地团队把开源底座下载回去,用自己的语料微调,才"长出"了小语种能力——能力是微调的结果,不是选择国产模型的原因。知乎
而且需要说清楚:目前并没有可核验的分地区数据能证明"东南亚、非洲用户偏爱国产模型"这一前提本身。广泛流传的说法——东南亚的政府项目用千问做底座、非洲的开发者拿 DeepSeek 搭应用——出自自媒体对开源生态的概括性描述,属于态度信号,不是统计证据。微博
被证实的是全球开源供给格局,不是区域偏爱
有硬数据支撑的是更大范围的图景。据每日经济新闻 11 月 9 日基于 OpenRouter 的测算,11 月 2 日至 8 日当周,中国大模型周调用量为 116.18 万亿 Token,已连续 28 周超过美国。 全球调用量排名前五的模型中,有四款来自中国团队。Mozilla 的报告则显示,中国开放权重模型在 OpenRouter 上的 token 份额从 2024 年底的不足 2%,升至 2026 年 4 月的超过 45%。 追踪开源生态的 ATOM 项目统计,2023 年末以来的两年里,全球新增开源衍生模型中约七成基于 Qwen,Llama 的占比则从四成多跌到一成。知乎知乎知乎
最接近"区域偏爱"的可靠案例来自政府层面:2025 年 11 月底,新加坡国家人工智能计划在其服务整个东南亚的旗舰模型中放弃了美国开源体系,转用中国企业的开源架构。 但这类案例里,公开报道强调的理由是技术路线自主和成本,而不是小语种能力。微博
麻省理工的研究同期还发现,中国团队开源模型的下载量占比上升至 17%,首次超过美国同行。 这里的统计对象是全球下载量而非区域偏好,两者口径不同。微博
小语种恰恰是国产模型不占优的领域
机器翻译领域的通行划分是:英语、中文等拥有庞大平行语料的语言是"高资源语言",东南亚、中东、非洲的许多语言属于低资源语言,训练数据稀缺导致通用模型在处理这些语言时依赖有限词汇映射,出现语义断裂。 斯坦福研究还指出,模型在低资源语言任务上容易生成刻板印象化的表述,把地域想象成"非洲村庄等于茅草屋"。知乎
国产阵营对小语种的态度也是"补齐"而非"擅长"。B 站 9 月底开源了基于 Qwen3.5 的 Index-Translate 翻译模型家族,覆盖 150 种语言。微博
但官方技术报告自己写明,低资源语言和组合约束仍然更难。微博
海外厂商同样没有缺位:Google 推出的开源翻译模型 TranslateGemma 宣称覆盖 550 种语言。 单论"说小语种说得好",中国模型并没有可核验的领先证据。微博
那东南亚、非洲的用户到底在选什么
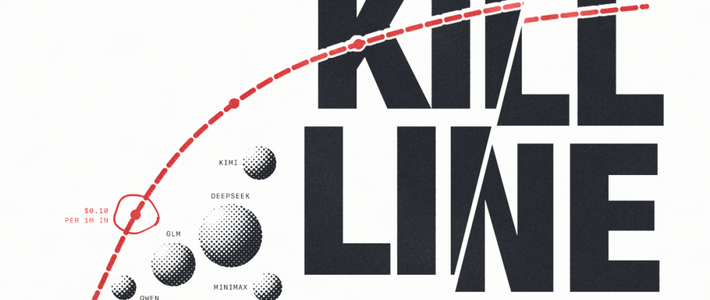
第一个原因是供给的稀缺性。Anthropic 不做开放权重,OpenAI 六年来只在去年发过一次 gpt-oss,曾被寄予厚望的法国 Mistral 渐渐掉出第一梯队,Meta 也把重心转向闭源。 持续供应前沿规模开源模型的目前主要只剩中国团队,Qwen、DeepSeek、GLM、MiniMax 各尺寸密集更新。对既没有顶级算力、又买不起闭源高价 API 的地区开发者,可选项事实上收窄到了这几家。知乎
第二个原因是"够用 × 极便宜"。独立评测机构 Artificial Analysis 把单次任务成本列为独立指标后,差距很直观:跑同一任务,Claude Opus 约 1.78 美元,MiniMax M3 只要 0.18 美元。知乎
这不是小众偏好:Airbnb 的 CEO 公开讲过,公司大量用中国开源模型跑客服 Agent。 a16z 合伙人对《经济学人》透露,带着开源模型架构来路演的美国 AI 初创企业中,约八成用的是中国基座。 更要紧的是确定性:权重在自己手里,能私有部署、能换托管商,不必担心供应商涨价限流——这恰恰是政府项目和数据敏感的本地企业最在意的。知乎知乎
第三个原因才和小语种有关,但方向是"可微调"而非"原生支持"。开放权重意味着当地团队能拿泰语、越南语、斯瓦希里语语料做自己的微调,闭源 API 给不了这条路。它的另一面是贴牌滥用:巴西里约市政府 IT 公司发布的"自研"模型 Rio 3.5 被验出根本不是新训的,六成权重来自另一家国产开源模型 Nex-N2-Pro,四成来自 Qwen。 印度机构 169Pi 在排灯节发布的"主权模型" Alpie Seed,模型卡承认底座就是 Qwen3.5-9B,靠配置文件里三句提示词冒充自研,随即被开发者扒出。 连造假都首选中国开源底座,侧面说明了它在全球开发者工具箱里的默认地位——但这些团队想要的,本来就是可以贴牌、可以改造的原料。知乎知乎
边界:领先的是用量,未必是利润
还须注意口径。OpenRouter 统计的是第三方聚合平台上的开发者和企业 API 调用,偏编程与 Agent 场景,不能代表全球终端用户,更切不出东南亚、非洲的区域分布。格局本身也在变化:10 月 8 日之后,性价比前沿一度被 Anthropic 和 OpenAI 接管。知乎
Mozilla 同一份报告也显示,2025 年 5 至 9 月,开放模型约占平台两成使用量,却只拿到约 4% 的模型层收入。 中国开源模型的护城河不在便宜——价格战对手跟得起——而在开放权重生态的规模与迭代速度。知乎
要不要相信"东南亚、非洲偏爱"这个说法,后续可以盯三类信号:Hugging Face 或分析机构发布的分地区下载/调用统计、东南亚与非洲政府 AI 项目的底座选型公告、当地语言模型发布时披露的基座来源。在这三类数据出现之前,"小语种支持更好"更适合作为观察清单上的待验证项,而不是结论。