今天(9月15日)上午开始,知乎、微博和B站的炼丹圈基本被同一条消息刷屏:北京中关村学院的7名博士生,用一个暑假从零训练出一个7B大模型ZGCM-1,然后把各阶段训练数据和配方、模型权重、训练代码、中间checkpoint、训练日志全部开放出来。量子位发了获授权长文,知乎当天就有了对应的讨论问题,B站晚上已经出现"大厂要几百人,他们怎么做到的"的解读视频。微博知乎哔哩哔哩
热闹归热闹,真正打算自己开炉的人,第一反应应该不是喊牛,而是盘账:这份报告和开源仓库里,哪些数字是可以搬进自己实验室的,哪些是看看就好的。我把量子位的授权报道、GitHub仓库和arXiv技术报告(2609.13356)拆开对了一遍,账给你算清楚。
一、这次"全开源",值钱的东西不是权重
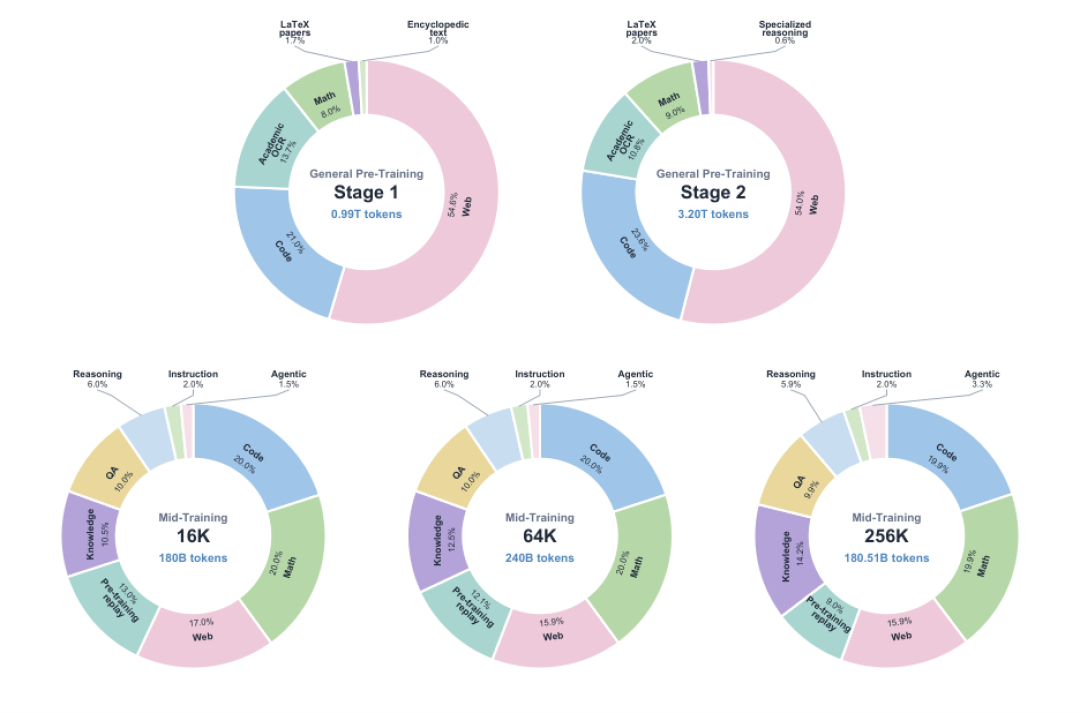
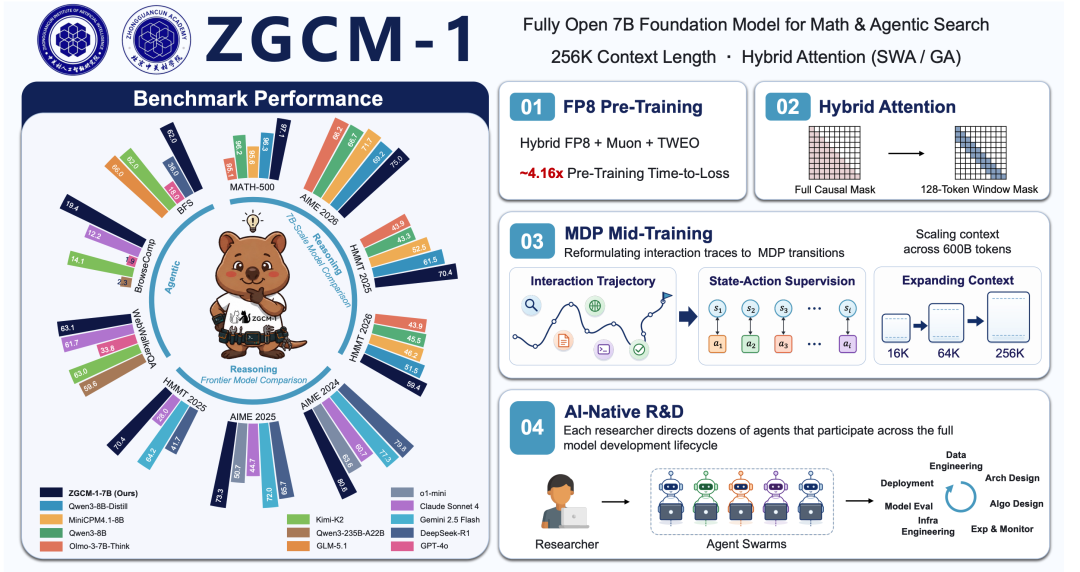
开源一个7B权重,2026年已经不稀奇了。这次真正稀缺的是三样:各阶段数据配方、中间checkpoint、完整训练日志。 先看这份开源账本里到底有多少货:一个7.39B参数的稠密模型,预训练吃掉约4.19T tokens,中训练再灌约600B把上下文从16K一级级推到256K;GitHub仓库按阶段拆成data-process、pretrain、midtrain、sft、rl五个目录,每个目录带自己的配置和运行文档。报告里最直观的是一张数据配方总览:五个圆环,Stage 1约0.99T、Stage 2约3.20T,中训练按16K/64K/256K分三段,每段标了token量,Web、Code、Math、学术语料的占比一目了然——这就是"我们进行了数据清洗"这句话落到工程上的真实形状。arXivGitHub
以前你读大厂技术报告,最常见的困惑就是:配方写了,但"做完一轮清洗到底是什么感觉"没人告诉你。这次中间checkpoint和日志一起放出来,等于让圈外人第一次有机会追踪"能力是怎么一步步长出来的"。B站已经有人泼冷水:“开源≠开代码”,上万卡训练的大模型开源时省掉的东西多了去了。但7B这个体量、全链路留档,确实是目前个人研究者能拿到的最完整的一份训练样本。哔哩哔哩
二、最该抄走的一课:loss曲线会骗人
报告里有一个事故值得所有炼丹人背下来:一次训练中loss正常下降,模型能力却明显退步。曲线什么也没告诉他们,最后一路往下查,问题追到底层的数据分片和shuffle环节——实际送进训练的数据比例发生了波动,模型吃进去的,并不是他们以为的那份配方。知乎
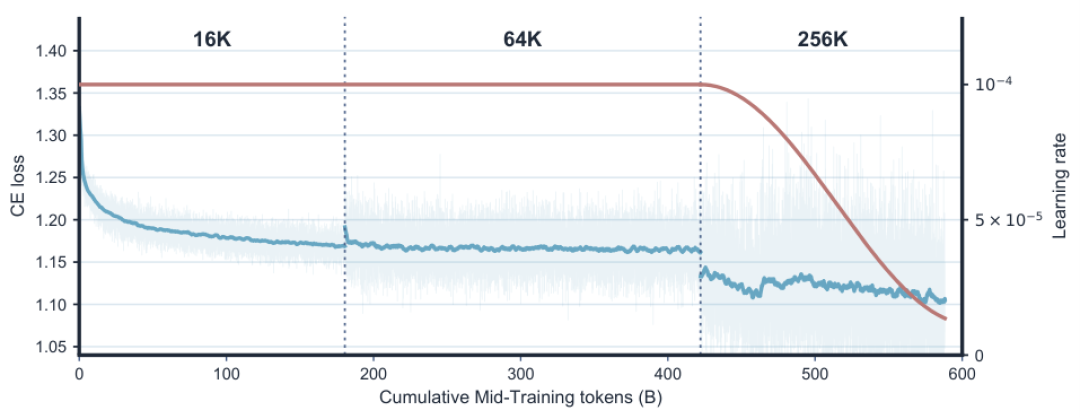
团队的补救动作,才是这次开源里最实用的工程资产:不再只盯loss,改为更密集地保存中间checkpoint,并搭了一套ACE原子能力评测体系——把能力拆成18类、183项,用2503个探针检查,一轮内部诊断大约两三分钟。改一处,哪里变好、哪里退步、下一步查数据还是查方法,都有依据。这和最近圈里讨论的"内科指标"是同一个方向:loss是体温计,但体温正常不等于没生病。如果你的实验室现在还在用"loss降了=训练健康"做判断,这套探针思路是这份报告里性价比最高的可抄项。知乎
三、三笔效率账,数字很硬,但要看清前提
报告给出的可量化收益主要三条:
预训练效率约4.2倍:在16K预训练达到相同loss,相比标准BF16/AdamW基线效率提升约4.2倍(总览图上标的-4.16x time-to-loss就是这一项)。配方是Muon优化器+FP8低精度,再配合延迟缩放与TWEO抑制极端激活值来稳住低精度训练。知乎
长上下文吞吐约3.94倍,KV Cache降到约1/6:32层里27层带门控的滑窗注意力、5层全局注意力,局部窗口只有128 token,上下文从16K逐级扩到64K、256K。他们做这个是被需求逼的——长推理、搜索、多轮工具调用会不断堆上下文,7B的"脑子"装不下,就得换更省的装法。GitHub
SFT三条反直觉结论:更严格的质量筛选让样本减少约44.9%,整体评测反而提升(注意,不是每项能力同步受益);长思维链数据比例过高,会损害指令遵循;Agent数据不能脱离通用能力单独训练。
这三笔账都标了自己的基线和口径,这是它比一般论文可信的地方。但也正因为标了口径,你要清楚:4.2倍是对BF16/AdamW的相对值,不是对当下所有调优后配置的绝对碾压。别人拿去就能复现同样的倍数,报告没承诺这件事——它承诺的是日志和checkpoint放在那,谁都可以来对账。
四、“7个人+几百个Agent”:别被这个叙事忽悠,也别低估它
数据、算法、训练、集群、评测,每一环在大厂都是一个专项团队。7个人的解法是给自己组了一支几百个Agent的队伍:分做数据、跑实验、做评测的子团队,搞了个类似论坛的任务发布与汇报系统,再用自研ZGent平台把讨论、决策、debug经验沉淀成共享上下文和可复用Skill。知乎
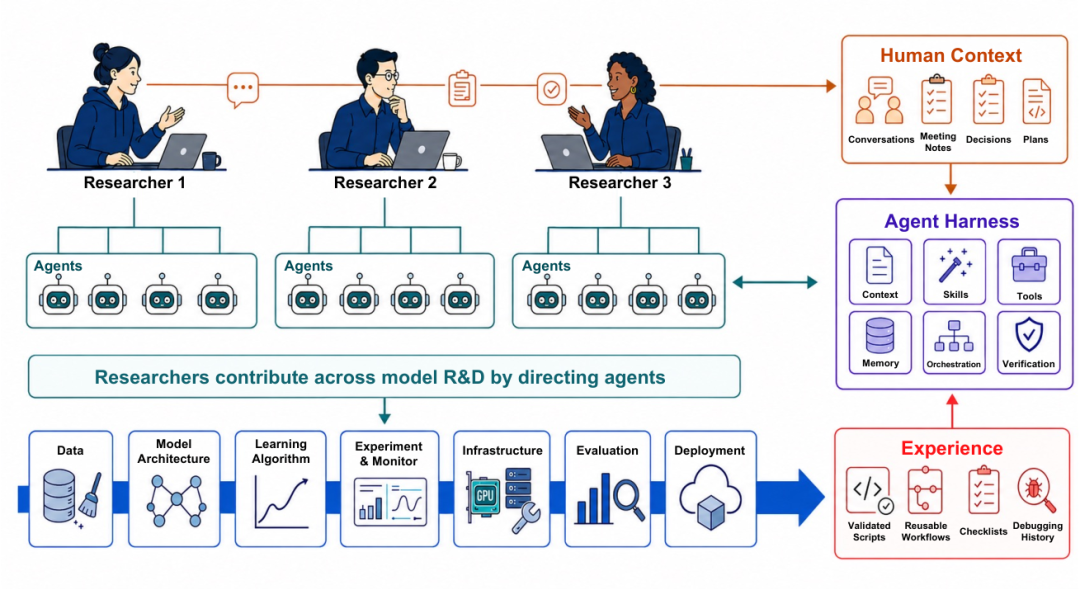
但团队没有把"AI能替我干活"吹满。他们把研发过程拆成11类任务,按L1到L5自主性框架逐项评级:实验监控、部署这类执行环节到了L4(给定目标和约束,Agent能独立规划、执行、按反馈调整);模型架构和学习算法设计仍在L2(帮人实现已有方案、跑预设实验)。研究什么、关键设计怎么选,还是人。 所以"7个人"这个标题要翻译成工程语言:是7个会调度Agent、并且自己写了一套Agent协作平台的人。别的实验室直接照搬"7人产能"不现实,但"人负责目标、约束和关键判断,Agent负责持续推进和自查"这套分工,是现在就能开始练的。另外提醒一句:算力部分只说了"老师先给了一些、跑通小模型全流程后拿到更多资源",卡数和成本都没公开——别拿这个案例去和任何人算"暑假XX块钱训7B"的账,没这个数。知乎
五、评测口径,原文的用词分寸要看懂
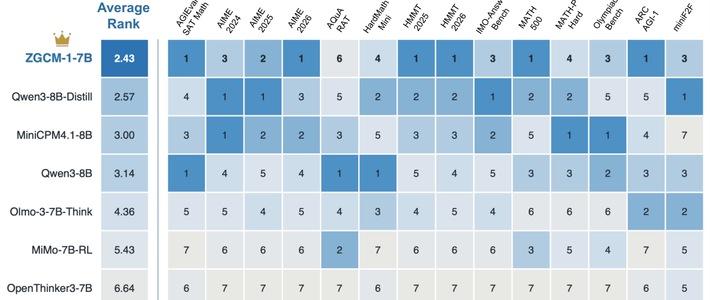
官方表述是两层:多项通用评测中,ZGCM-1与Qwen3-8B等同规模模型"表现相近";部分数学推理和搜索评测中,能与Qwen3-235B-A22B、GLM-5.1等更大规模的模型"比较"。14项推理评测在同规模中处于领先,部分搜索和工具调用任务看到了小模型的潜力。 翻成具体数字:MATH-500拿到97.13%,AIME 2026有75.00%,HMMT 2025为70.42%,七款7B-8B对比模型里14项基准平均排名2.43居首;搜索侧WebWalkerQA 63.09%、GAIA文本线42.52%、BrowseComp 19.43%。但注意,AIME 2024他们只拿80.62,输给DeepSeek-R1-Qwen3-8B和MiniCPM4.1-8B的83.33——“平均第一"不等于"项项第一”。这一切仍是团队自报口径(256K SFT checkpoint、thinking模式、pass@1均值),目前没有第三方复测。更值得留意的是后续:他们已经开始尝试400B、500B规模的模型。7B攒下的方法在大规模上还剩多少可用,几百个Agent能接住多少新工作,这才是这份报告真正的续集,也是值得收藏跟进的原因。知乎GitHub
六、谁该现在就去读技术报告
准备复现或正在跑小模型预训练的人:直接进仓库看中间checkpoint和训练日志的目录,重点核对数据配比波动那次事故前后的记录,这比结论部分值钱。
实验室负责人/导师:看他们的资源获取路径——先用一个暑假把全流程在小模型上跑通、用可见结果换更大投入,这个"滚雪球"剧本比任何预算申请PPT都有说服力。
只想看热闹的人:记住两句话就够了——loss会骗人,所以要探针;"7个人"的背后是一个人手的Agent集群和一套没公开的算力账单。
一个暑假能训出什么,2026年的答案已经改写了一次。下一次改写的,大概率就藏在这份开源日志被别人翻来覆去复现的过程里。