一边是开源工具给出的口径:“12GB显卡+64GB内存+普通固态,就能把DeepSeekV4.1Flash这样的前沿大模型完整跑在你家里,数据一个字节都不出本机”。另一边是B站拆解视频的评论区,一条14个赞的留言只有一句话——“4090从没没有这么憋屈过”。哔哩哔哩哔哩哔哩
这两条都是真的。而它们之间的距离,恰好就是你这双11要不要为"本地跑大模型"掏钱的全部答案。
这一周,本地AI圈打了一场军备竞赛
先把时间线捋直,这轮波动的源头是开源项目Strata(github.com/Niko1221/Strata):
9月底它在微博刚被推荐时,卖点还是"专为Qwen3.8-Flash-Next开发的,针对模型做了深度优化";10月2日,小红书一条"神项目Strata来袭!12G显卡轻松跑125B体量Qwen3.8 Flash Next!速度96t/s!"的帖子,攒下了7909个赞、14159个收藏。小红书
10月20日,0.2.0加上了图形界面和中文界面(Windows新装默认占用C盘且不能改路径,这条写在发布说明里),官方写着内存与显存合计最低约27.6GB。微博
10月25日,“18 小时,三个版本”。0.2.3给Strix Halo迷你主机提速19%、Intel Arc显卡正式入列;0.2.3.1修了一个把安装程序读崩的字符表bug;0.2.4干的事最大——让12GB显卡跑起DeepSeek-V4.1-Flash。紧接着0.2.4.1、0.2.4.2两天连补,0.2.5又把DeepSeek带进了桌面应用,可以从模型列表直接选、直接下载,截至发稿Release列表已经排到了Strata 0.2.6。这个9月底才被微博博主"安利"的项目,GitHub星标已经攒到近3.3万。哔哩哔哩知乎
同一天,llama.cpp也合并了PR #29887:一套"动态专家缓存"机制,把125B MoE模型在24GB显卡上的生成速度从9.7t/s拉到37.2t/s,接近4倍。这个视频评论区高赞第一条很扎心:"llama.cpp还是慢了一步,被已经技术成熟的strata打爆了。"另一条则是:“这不就是strata吗?问题不大都是开源。”哔哩哔哩
一句话总结这周的变化:MoE大模型"内存+SSD分层存放专家权重"这条路,从一个独立作者的炫技,变成了两大主流引擎同时下场的赛道。它的卖点也彻底变了一个——不再是"我的显卡能不能跑",而是"我的整机配不配跑"。
第一本账:显存是门票,内存才是门票钱
Strata的8项工程手段,说穿了就三招:内存当显存、跳过没用到的层、让小模型帮忙猜(B站拆解视频章节原话)。这套分层调度的代价,教程写得诚实——有人晒出的"8GB显存入门配置"里,显卡确实是"显卡:GTX 1060 6GB / RX 580 8GB(¥250-350)"的洋垃圾级,但另一行小字是:内存才是大头。知乎
社区实测把这层窗户纸捅破了。评论区一条9赞的留言问得直接:“为什么都在强调12G显存可以跑,却闭口不提32G起步的内存使用量。现在系统内存超过32G的很少吧,还有考虑系统和其他后台软件保留,那就是48G起步了,这成本反而比显卡高太多了”。哔哩哔哩
而内存大小对速度的影响,有现成的对照样本:
同一位用户,5090DV2跑iq3_xxs量化:32GB内存时65t/s,加到48GB直接130t/s——内存翻倍,速度翻倍。哔哩哔哩
16GB显存+64GB内存,跑125B平均80t/s;
不到3000元的整套X99洋垃圾(3060 12G+DDR3 128G)能跑iq3_s版本,能装,但没人报它的速度。
结论:这类方案的甜点不是"有张12G卡就行",而是"12G卡+64G内存+NVMe"。显卡你大概率已经有了,真正要补的是内存——而DDR5行情什么样,双11前每个关注硬件的人都心里有数:有晒单帖显示,长鑫颗粒的二手内存套条当年买入均价170,如今闲鱼挂价550+。知乎
第二本账:SSD第一次变成了"耗材"
763B的模型文件是239GB。过去本地跑模型,SSD只负责"装一次";分层调度方案下,SSD负责"每步都读"。
一位5060Ti 16G+96GB内存的用户晒出了完整工况:生成速度约10t/s,“期间硬盘1.5-2.5G/s读取,跑半小时就是几个T的读取,妥妥的硬盘杀手”。这条留言只有5个赞,但它可能是整场热潮里最被低估的成本项:按这个读盘强度,每天挂机8小时,一块消费级TLC盘的寿命要按年倒数,而不是按10年。哔哩哔哩
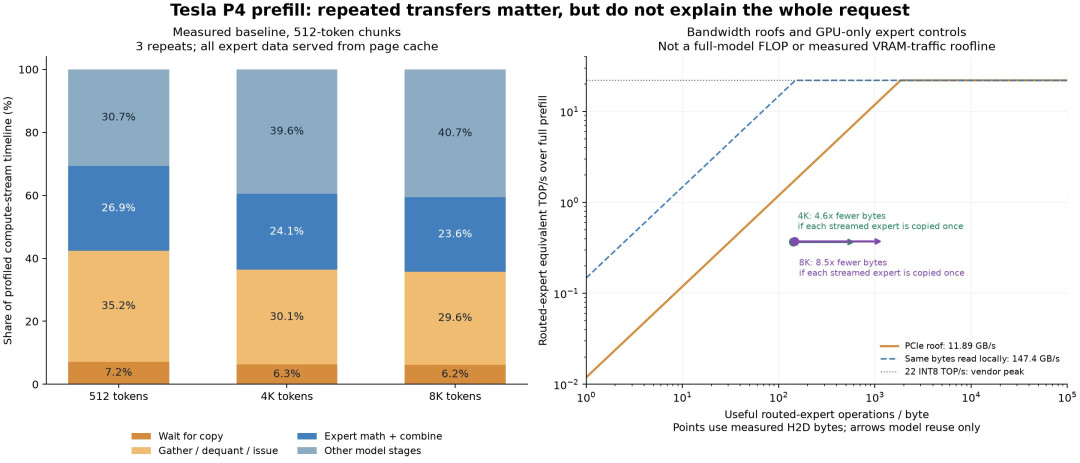
所以买盘逻辑也变了:这类玩法需要的不是"能装下239GB",而是一块不怕读、最好还是独立NVMe通道的盘。主板M.2槽位够不够、盘走哪条PCIe通道,从"装机细节"变成了"能不能跑"的一部分。llama.cpp那个4倍提速的更新里同样专门讲了PCIe插槽的影响,以及锁页内存带来的1.55倍增益——两家引擎不约而同,都把瓶颈从算力挪到了数据搬运上。官方仓库的预填充roofline实验把这事画得很直白:一块接在PCIe Gen3通道上的计算卡,链路封顶约11.9GB/s,而本地读表能跑到约147GB/s——专家权重从主机到显卡这一路,卡住的从来不是读,是搬。哔哩哔哩
第三本账:速度数字要拆开看,宣传值没有说谎,但也不是你的值
把社区数据摆成一张表,反常识的地方就出来了:
官方/传播口径:12G显存,96t/s;
同配置社区复测:“12GB显存,项目方说能跑到90tokens/秒,有人实测说是30多”。微博
7900XTX 24G+128G内存跑V4.1-Flash:实测13–14.5tok/s,“居然能用”。哔哩哔哩
llama.cpp的4倍:只适用于24GB显卡、且是生成阶段,“为什么部分 8G / 12G 显卡用户开启后速度反而暴跌”。哔哩哔哩
Mac端125B极限实测:7.9和89t/s同框出现,跑大模型速度差10倍,“买错直接成大冤种”。哔哩哔哩
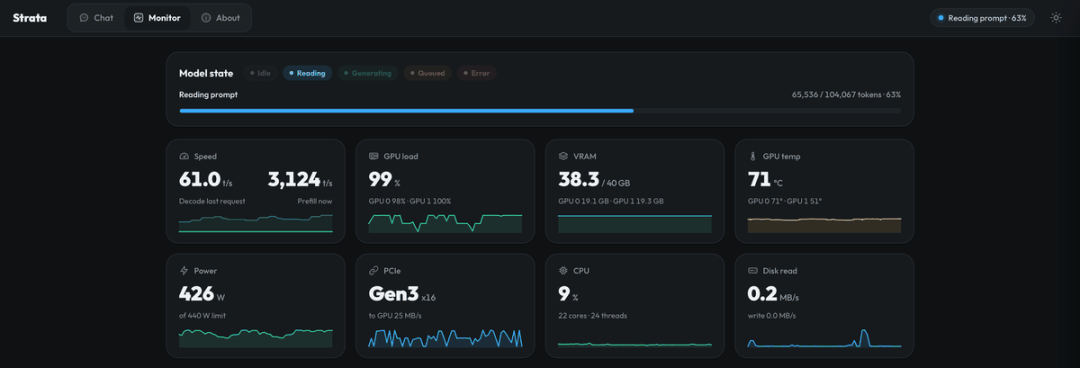
还有一个最反直觉的:Strata官方Release里,“真机速度:为什么 RTX 3060 反而比 5070 快”。因为瓶颈根本不在GPU算力,而在内存容量、内存带宽和盘速——显卡在这套体系里只是"计算的那一小块"。同一份官方社区benchmark(双3080 20G、UD-Q4_K_XL、512K上下文池)里,读取6.5万token的预填充阶段能冲到3124t/s,而真正吐字的生成读数只有60t/s出头——一条屏上两个数字,量的是完全不同的东西。哔哩哔哩
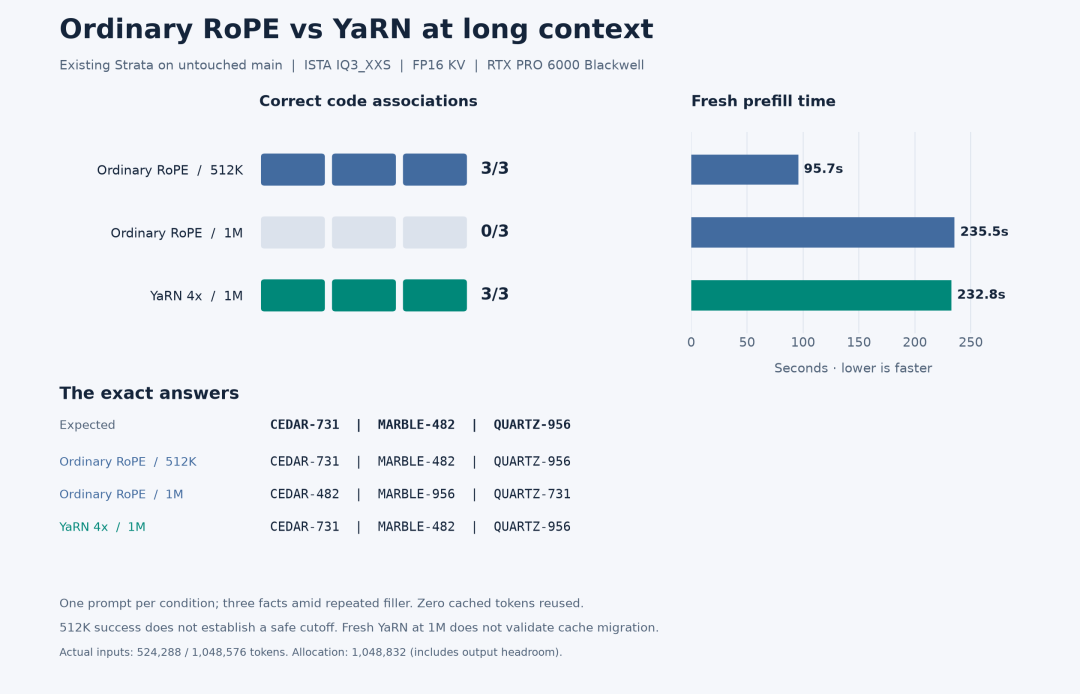
这些数字不矛盾,矛盾的是把它们当成同一个数。它们分别是:不同量化档位、不同内存配置、不同prompt长度下的产物——长上下文场景下引擎行为会变,官方仓库里就专门挂过一张"普通RoPE对比YaRN长上下文"的实验图,结论还带着免责脚注。"96t/s"是真的,"10t/s"也是真的,区别只在于你的机器恰好落在哪个格子里。
更值得玩味的是官方的态度:Strata媒体包里白纸黑字提醒转发者,这些界面截图"do not establish a current default model or universal performance"——宣传图上的数字,连项目作者自己都不让你当真。GitHub
对号入座:你的机器在哪个格子
按社区已验证的配置,可以把"要不要入坑763B/125B"拆成三类人:
只有12-16GB显存、内存≤32GB:别动。装得下也跑不快,先把内存这一关的钱算清楚再说,125B起步体验大概率是"打字机"。
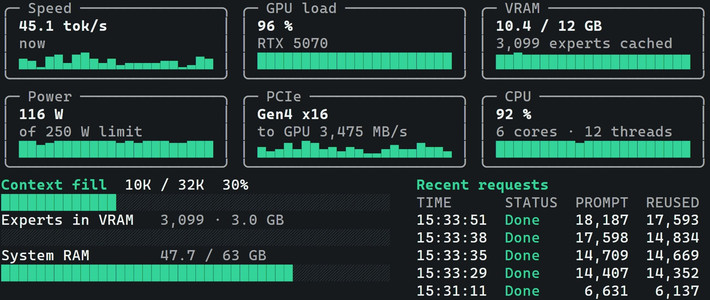
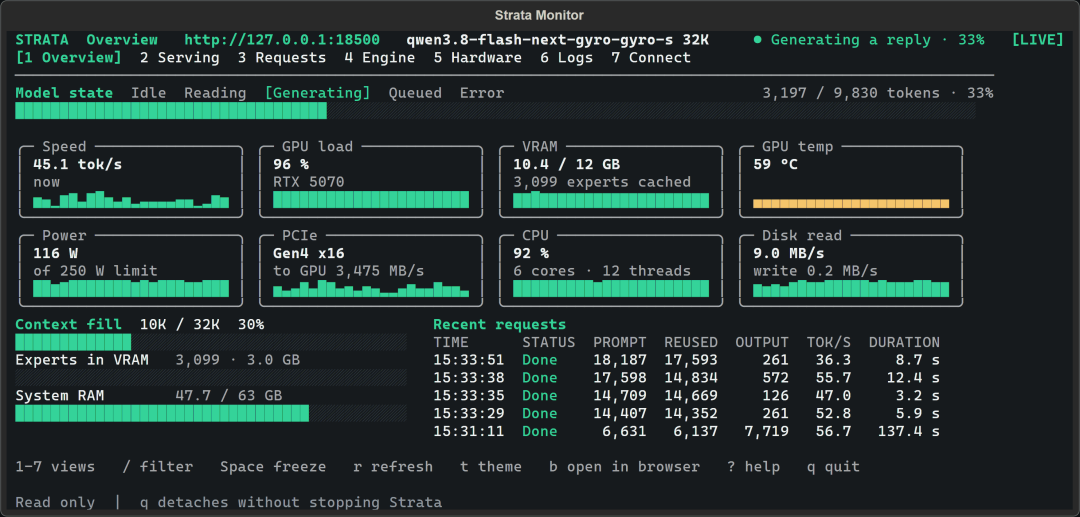
12GB显存+64GB内存+NVMe:主力甜点区。125B级量化有80t/s级社区样本可对表;763B能跑但按13-15t/s预期——低于人眼阅读舒适速度,适合"放着当后台任务",不适合聊天。官方文档的Monitor示例正是这一档:RTX 5070跑着,显存吃到10.4/12GB、内存挂到47.7/63GB、PCIe Gen4每秒搬运3.4GB——显卡没喊累,内存和总线先满了。
24GB+显存、128GB内存、独立高速NVMe:763B的现实门槛。AMD 7900XTX和Strix Halo阵营样本最多(后者官方还给了+19%),但注意:按官方媒体包口径,DeepSeek-V4.1-Flash目前在应用和终端里正式支持的是RTX 30、40、50系加Radeon AI PRO R9700(Linux),你手里的消费级A卡走的是社区验证路径;而且质量基准还没人系统测完,"能跑"和"好用"是两件事。GitHub
双11的动作建议很具体:这次不该为"跑V4.1-Flash"买显卡,该检查的是内存槽和M.2通道。想低成本试错的,X99+DDR3 128G的洋垃圾方案有社区实装样本;想一步到位的,先等下面四个信号。
顺带避坑:教程区正在混进"李鬼"
这波热潮的伴生品,是网盘教程和"一键部署"的混战。B站10月25日一条109赞、3524播放的视频标题就是开炮,质问本地部署deepseekv4.1是不是在用api+DSH就当是本地部署了吧?有博主靠转发网盘链接卖"本地部署教程",实际给你接的是云端API;也有"基于开源项目Stratav0.2.2,专门针对国内用户体验做了一款桌面软件——「玩客笔记Strata增强版v1.0.0」"这类脱离上游仓库分发的增强包,来路无法校验。哔哩哔哩哔哩哔哩
判断真假本地部署,不需要技术背景,四个动作就够:
看下载:模型文件是不是以GB为单位落在你自己的盘里;
拔网线:断网后还能不能出字;
看任务管理器:内存占用是否长期挂着几十GB;
看读盘:跑长文本时NVMe指示灯/磁盘曲线是否持续高位。
四条里有一条过不了,你买的就是API中转,不是本地部署。至于"模型来路"这件事,前阵子"下载的27B根本不是官网那个"的翻车已经给所有人上过一课。
下单前,等这四个信号
0.2.5/0.2.6复测:桌面应用已正式接入DeepSeek、Release列表已排到0.2.6,但这两个版本还没有可复现的社区速度表,别按宣传值做预算;
763B质量基准:V4.1-Flash-1017本地版的第三方评测还没铺开,速度账算完,质量账要等有人算;
传闻中的DeepSeek家用模型:评论区已经在转述"报道说DS晚点会出一个家用机能跑的模型吗???"——目前仅是转述,没有任何官方信源,如果真发,现在为763B加内存加买盘的逻辑会直接改写。哔哩哔哩
内存/SSD的双11实际价:DDR5和SSD的涨价行情还在——知乎上"SSD涨价行情或将持续到2030年"的说法已有专门的讨论问题,行情不回头,"等等党"这套方案里最贵的那两样就永远不打折。知乎
热闹是引擎的,账单是自己的。这一轮"MoE下放"大战真正改变的,是本地AI的成本结构:显卡从门槛变成了配角,内存、盘和通道费才是新的入场券。把这三本账算平,再决定要不要把那条"大肥鱼"抱回家。