这两天刷 AI 资讯的朋友,应该已经被一个叫 Jev 的模型刷屏了:原贴 3700 多万浏览,X 和 Hacker News 全是讨论,知乎相关问题几十万人在看。火的方式还挺抽象——这模型不会聊天、不写代码,你问它"选 A 还是选 B",它就回你一个选项加一个概率,一个字都不多说。
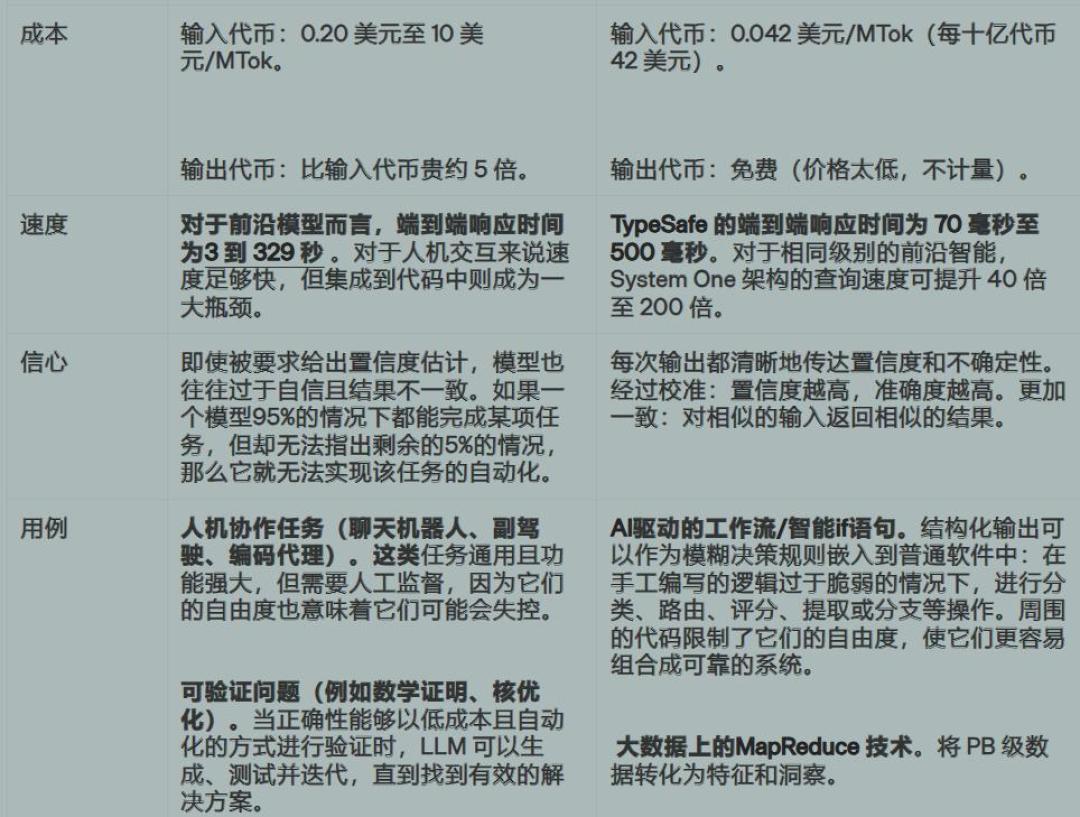
9 月 15 日,前 OpenAI 研究员 Diogo Almeida(参与过 RLHF、InstructGPT)的创业公司 TypeSafe AI 结束两年潜行,放出了首个"System One 模型"Jev——名字取自提出杰文斯悖论的那位经济学家。思路一句话:砍掉文本生成,只做判断。官方口径是端到端响应 70~500 毫秒,比前沿模型快 20~200 倍、便宜 40~400 倍,输出 token 永久免费,输入每百万 token 只要 0.042 美元。量子位
各家的 Flash 模型确实被打了:Vercel 说这是自家 AI Gateway 历史上被采用最快的模型,开放 24 小时内 13% 的付费团队接入,速度是 GPT-5.6 发布那次的 2 倍;Cloudflare、LangChain、Langfuse 全跟进了。 有人算了笔账:一万次日决策,Jev 一个月 120 美元,同样准确率下用前沿模型要 35000 美元。还有更极端的实测——40 秒分析 724 条广告、做了 8724 次判断。知乎华尔街见闻
但对咱们这些搞本地推理的人来说,这周真正有意思的不是 Jev 本身,而是它闭源:权重不给你,接口在别人服务器上。于是熟悉的剧本又来了——发布不到 48 小时,GitHub 上炸出 14 个对标项目,从 0.5B 到 9B 全都塞进了本地。 今天就把这波"决策模型平替"捋清楚:谁能装、怎么装、装完能干什么、以及哪些坑必须提前知道。知乎
先说清楚 Jev 是个什么东西,别跟聊天模型搞混
Jev 官方给的能力就三种:Choice(从选项里挑)、Score(打分)、Noul(是非判断)。你可以把它理解成一个带概率的"语义逻辑门":输入一段非结构化文本加一组限定答案类型的问题,输出判断结果和置信度,剩下的交给代码接着跑。
传统大模型做分类,哪怕最后只需要输出一个"A",也要逐 token 把答案"写"出来,还经常给你附赠一段"希望这有帮助";Jev 直接出结果,同一份输入里的多个独立问题还能并行处理。训练方法叫 RLCD(用于校准决策的强化学习),优化目标是让输出的概率匹配真实发生频率——标 0.2 的事,真实发生率就约等于 20%。 这一点对自动化很关键:有了可信的概率,你才能设阈值,比如 0.9 以上自动执行、以下转人工。量子位
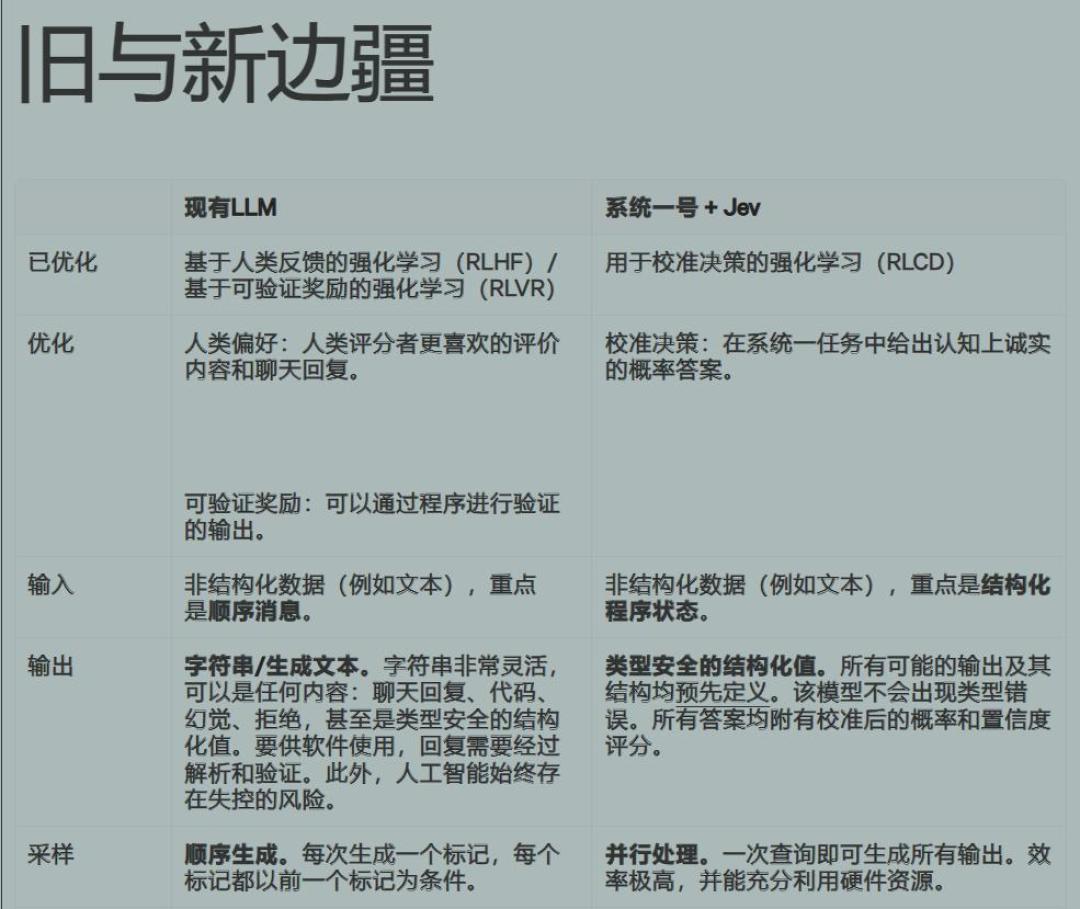
"零幻觉"的宣传要打个折扣:给它 A、B、C 三个选项,它确实不会编出一个 D,但正确答案是 A 时它照样可能选成 B。 类型正确,事实不一定正确。量子位
本地平替已经卷出三档,从 5 分钱到一张老显卡
这波开源复现里,目前值得记住三个名字:
第一档,Kev(0.5B)。Vercel VP Jared Palmer 在 Jev 发布后两小时就用 Qwen 搓出来的版本:可训练参数只有 9.3M(基座的 1.9%),在一台普通 M5 MacBook 上训练 1 小时 45 分钟跑完,耗电 0.06 度、电费不到 5 分钱。 改个 base_url 就能无缝替换官方 SDK,作者自己拿它当裁判下国际象棋。定位就是极客玩具和验证思路用。小红书
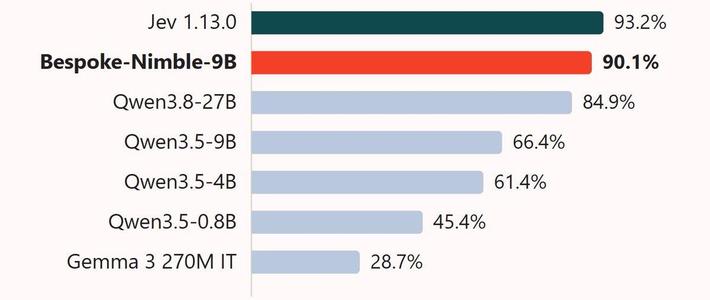
第二档,Nimble(9B)。Bespoke Labs 基于 Qwen3.5-9B 做的 LoRA 微调,Apache 2.0,权重和训练配方全开源。训练思路挺妙,叫"找茬式微调":构造两份几乎一样的材料,只改一个关键事实,答案随之翻转,逼模型抓住真正影响判断的信息。成绩上,基座 Qwen3.5-9B 与参考标签一致率 66.36%,Nimble 拉到 90.12%,超过了三倍大的 27B 模型,离闭源的 Jev(93.21%)只差 3 个点。量子位
第三档,Laya。完全对标 Jev 的独立开源实现:Apache 2.0、权重挂在 Hugging Face、三个 checkpoint、PyPI 一条命令安装。非自回归架构,一次前向出全部答案。本地实测一次前向 11~13 毫秒,模型两个多 G。 还有人把它移植到了 Apple MLX 框架——M2 Pro 实测只占 1G 内存、每秒 60 次决策,拿来跑贪吃蛇的实时方向判断都不卡。知乎小红书
顺便说,国产这边 APUS 也放了首批跨平台复现,主打秒级决策。 Browser-Use 的 jev-ultrafast 项目把 Jev 装进浏览器 Agent 当判断层,开源 3 天拿下 7.1K star。知乎大模型爱好者社区
这才是本地推理圈子该兴奋的点:硬件门槛第一次低到可以忽略
过去两年聊本地部署,永远绕不开"你显存多大"。跑 27B 要 24G 起步,跑量化版也得琢磨半天,本站之前算过的那些硬件账,本质上都是拿钱换显存。
决策模型把这个逻辑掀了。Laya 两个多 G、laya-mlx 占 1G 内存,9B 的 Nimble 量化后一张 16G 卡或者大内存 Mac 也就够了——注意,是"也就够了"而不是"刚刚够用",因为这种模型每次只做一次前向、出十几个 token 当量的结果,显存带宽和生成速度的焦虑全都不存在。评论区有句话说得准:这类模型最大的瓶颈是网络延迟,装本地之后连这个都没了。
所以这周如果你看到"为跑决策模型升级硬件"的说法,基本可以判定是在带节奏。你手里任何一台近五年的电脑,大概率都能跑其中某一档。
但先泼盆冷水:实测下来,它"识别"很行,"判断"不行
有博主把 Laya 装到本地,拿三个真实场景较真,结果很值得看:
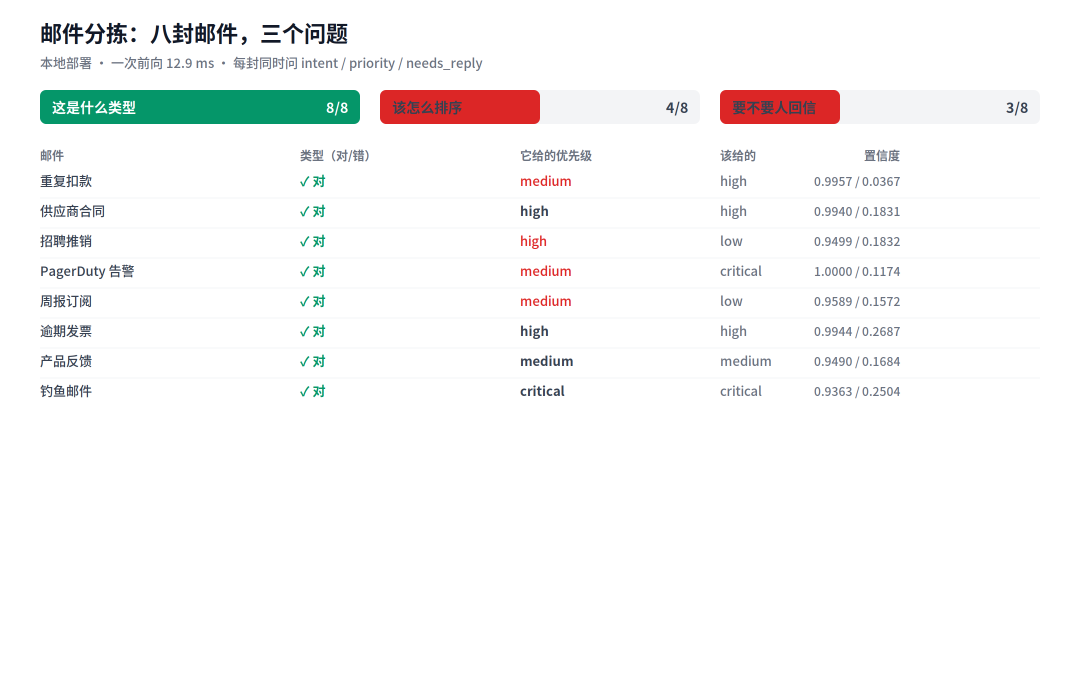
收件箱分拣:八封邮件类型全部分对,一个不错。 但"该怎么排优先级"答得很糟——四档优先级八封只对四封,什么都往 medium 塞,连"p99 延迟 4.2 秒、错误率 2.1%、三个区域受影响"这种生产事故都只给 medium,置信度低到 0.117(它自己也没底)。"要不要人写回信"八封只对三封,招聘推销它也说该回。知乎
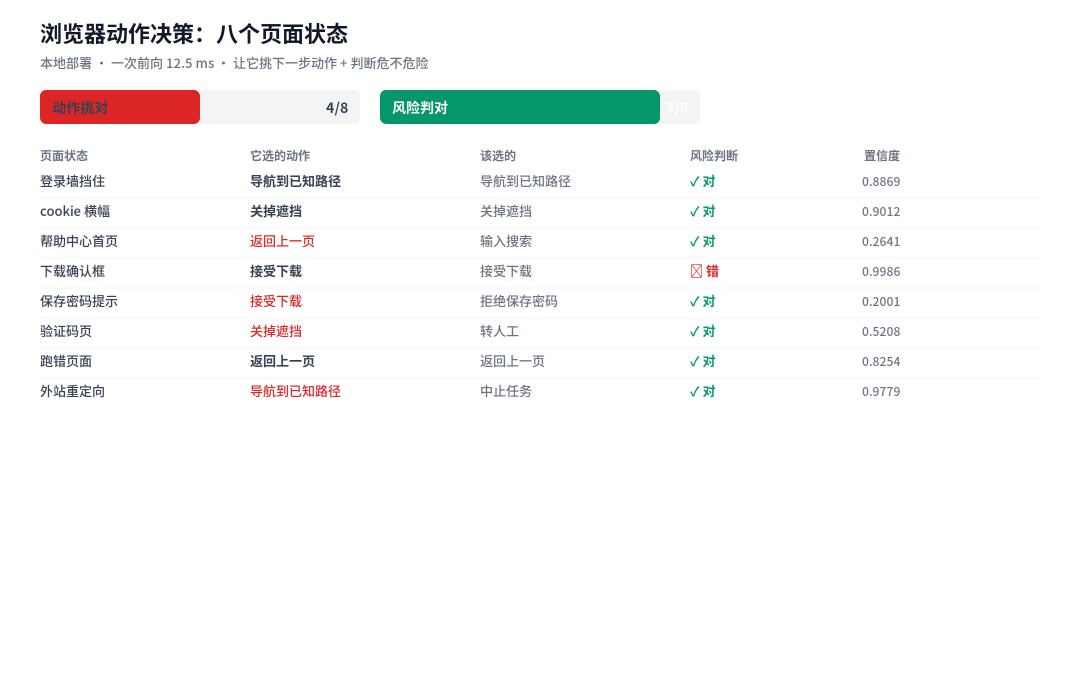
浏览器动作决策:八个页面状态,动作只挑对四个。最离谱的是把"第三方跟踪域名跳转"判成"直接导航到已知路径",置信度 0.978——非常确信地把用户往站外送;把验证码页面判成"关掉遮挡横幅",Agent 真照做就卡死。知乎
客服路由:六句话对四个,但错的两个都是把人 close_chat——"这周第三次宕机了,我要退款"这句,它给了 0.727 的置信度关掉会话。把要退款的人请出去,这在客服场景是严重事故。知乎
规律很清晰:"这是什么"它很行(类型识别 8/8、风险判断 7/8),"这有多重要、该怎么办"它不行。识别有客观特征可依,判断要靠权衡。所以别被"90% 一致率"迷惑——那个数字测的是分类,不是决策。
还有一个反常识的事实:下棋测试里 Jev 输给了 GLM 5.3——Jev 每步 0.3 秒、不到 0.0001 美元,GLM 5.3 每步 5.8 秒、约 0.008 美元,最后是慢的那个 29 步将死了快的。 下得快,未必想得深。量子位
三个坑,装之前想清楚
坑一:把它当聊天模型的平替。它不是来抢饭碗的,是来分工的——聊天模型是笔杆子,决策模型是分拣员。你当然可以逼笔杆子去分信,但他会一边分一边给你写感想,你还得付稿费。正确的用法是:Agent 里的决策节点交给它,生成节点留给大模型。
坑二:不设概率阈值直接自动执行。它给的概率是校准过的,这正是让你设阈值用的:0.9 以上自动归档、以下进待看;高危动作(关会话、跳外链、执行命令)宁可多一步人工确认。上面那个 0.727 的置信度,就是该被阈值拦下来的典型。
坑三:接实时链路不管冷启动。本地部署后热请求 11~13 毫秒,但冷启动第一条会到 400 毫秒左右(要现场重建路由)。挂进实时链路要么加预热、要么让模型常驻内存,两件事都是一行配置的事,但忘了做,你看到的延迟数字会很难看。
最后给个结论:什么人该跟,什么人不用动
该跟的:手里有 Agent 工作流、或者每天要处理大量打标/分拣/过滤任务的。工单第一道分拣、命令安全闸门、批量内容打标、大数据集前置过滤——这几个场景是实测验证过真能用的,成本几乎是零。选型上,干活选 Nimble(9B,效果最接近 Jev)或 Laya(部署最省事),Kev 拿来玩和理解原理。
不用动的:如果你本地跑模型就是为了聊天、写文案、读文档,这波跟你没关系,你的 27B 小钢炮继续用就好。别因为刷屏焦虑——Jev 的火不是因为它更强,是因为它提醒了所有人:Agent 里那些"选择"节点,一直在用最贵的工具干最便宜的活。
继续观察的信号有三个:Jev 的技术报告还没发,开源复现质量会继续变;Bespoke 和社区都在迭代,两三个月内大概率出现明显更强的开源决策模型;以及大厂联名呼吁放缓迭代、抬高订阅门槛的背景下,"输出永久免费"这个定价策略本身就是冲着订阅制去的——本地推理的价值叙事,这周又被抬了一手。
这周最值得带走的判断不是某个模型,而是一个问题:你手头的活里,有多少其实不需要模型"说话"?把这笔账算清楚,比买任何新硬件都值钱。