

11月的AMD有点忙:16日刚宣布完成82亿美元的WorldLabs交割,17日又官宣拿下加拿大AI推理芯片公司Taalas——一家团队只有24人的小厂。前一笔瓜大,后一笔安静,但对关心"AI算力到底多贵"的人来说,后者可能更值钱。知乎36氪微博
一芯只认一个模型
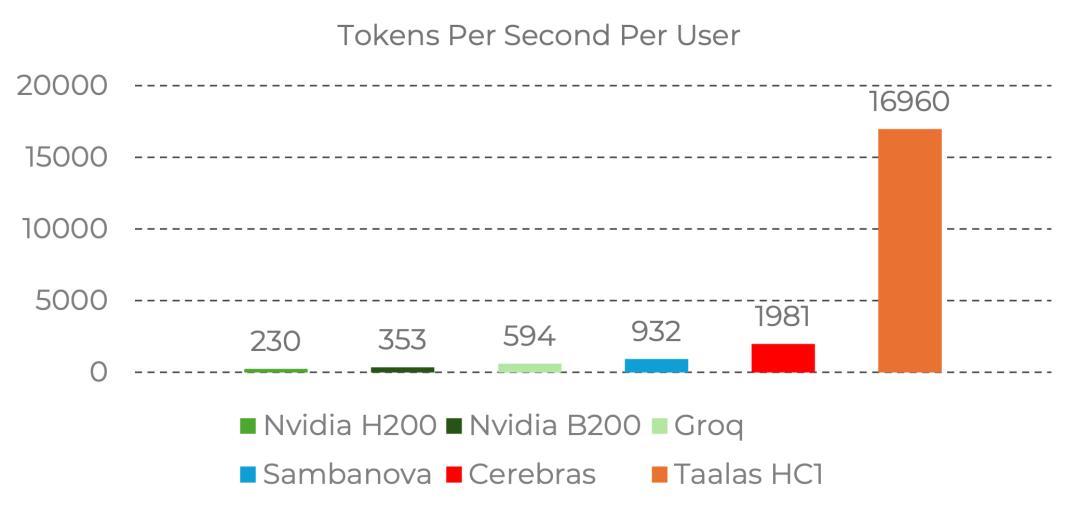
Taalas的玩法相当激进。GPU靠从显存反复读权重来算,它干脆把模型直接烧进芯片电路——权重固化在掩膜ROM结构里,单个晶体管存4位数据、就地完成乘法。拳头产品HC1是一块PCIe加速卡,里面"焊死"的是Meta的Llama 3.1 8B。按公司自己的披露:单用户每秒1.7万个token,约为英伟达H200的74倍、B200的48倍;每百万token成本0.75美分,而GPU方案普遍要20到49美分。36氪知乎微博
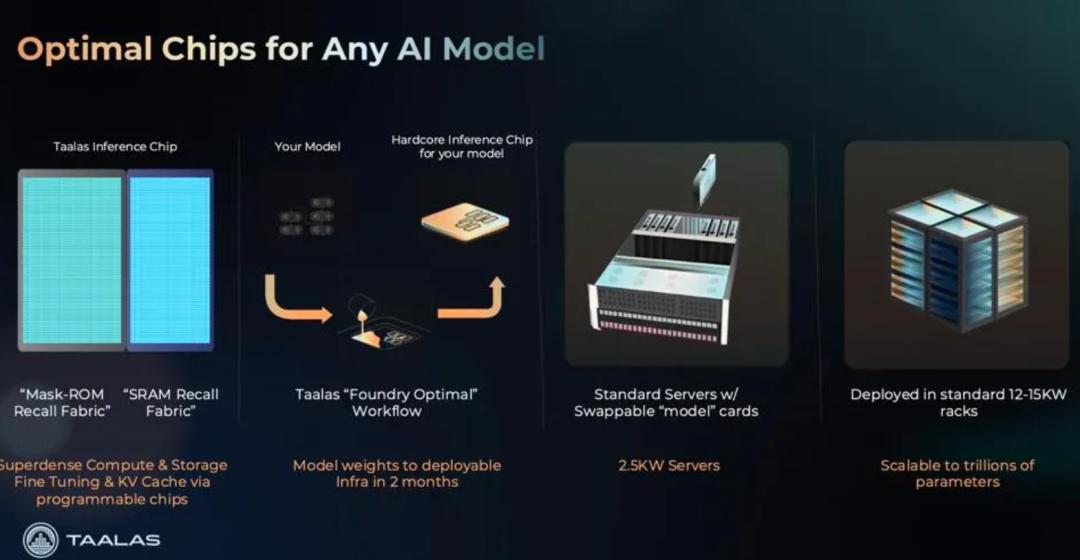
快从哪来:内存墙直接没了
传统GPU做推理,大头不是算不过来,是数据搬不过来。把权重存算一体"焊"进芯片后,不用HBM、不用CUDA式调优,普通服务器插上就跑;单机架功耗12到15千瓦,GPU机架通常120到600千瓦,它还能风冷,液冷改造费都省了。Uber的CTO今年甚至抱怨年初几个月就烧光了全年AI预算——这就是专用推理芯片想吃的市场。36氪
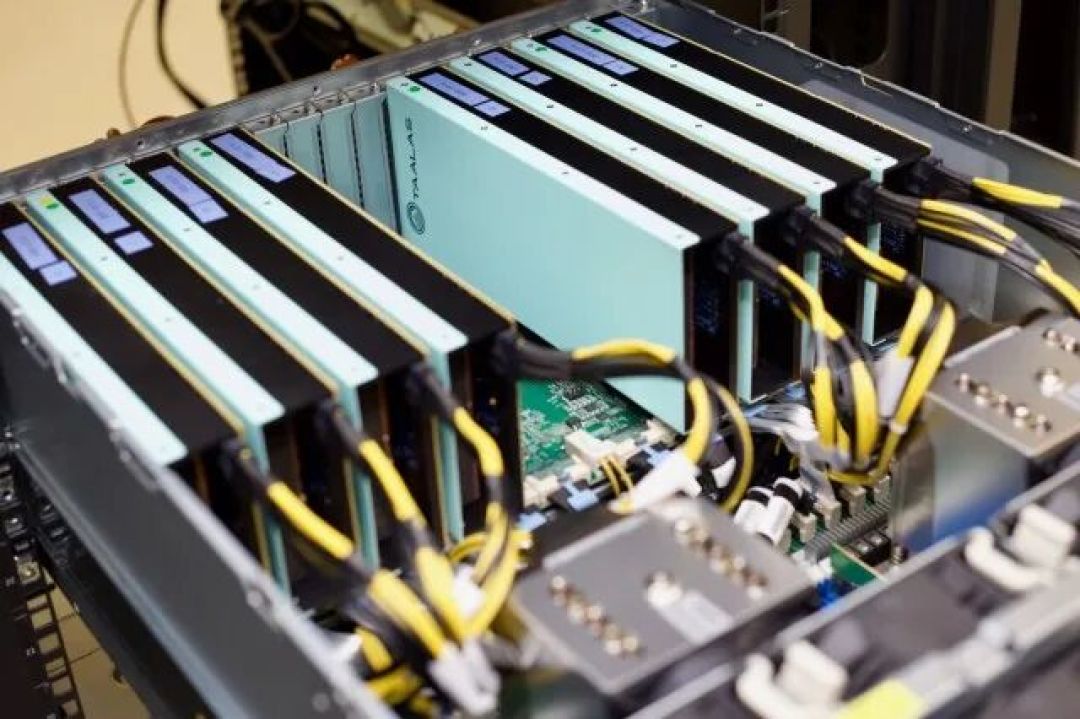
这不是AMD一家的冷门判断。Cerebras把Llama 3.1 8B的商业推理做到近2000 TPS,只认Transformer架构的Etched累计融资11亿美元,英伟达自己也在新平台Vera Rubin里引入Groq来分担解码环节的活。推理这件事,正在从"通用GPU顺路干的活"变成各家单独摆一张牌桌的战场。36氪
代价:模型换代,芯片跟着换代
评论区被问得最多的一题:模型一年好几版,只认一个模型的芯片,模型淘汰了怎么办?Taalas的答案是"从模型到芯片60天"的重做周期,外加保留LoRA微调的口子。但社区并不全买账——"CPU→GPU→ASIC,这不就是矿机的老路线?"模型一过气,卡进二手市场。反方评论也值得看:追新不是所有场景的刚需,停车识别、工单问答这类活儿,老模型够用就够用,降价后反而是划算资产。这路线最后像矿机还是像工业设备,就看行业把模型当快消品还是耐用品。而且这条路线目前只在8B小模型上验证过,宣传里的DeepSeek R1数据还是模拟值,通用性天花板明摆着。微博36氪哔哩哔哩知乎
AMD的算盘:自己人回家了
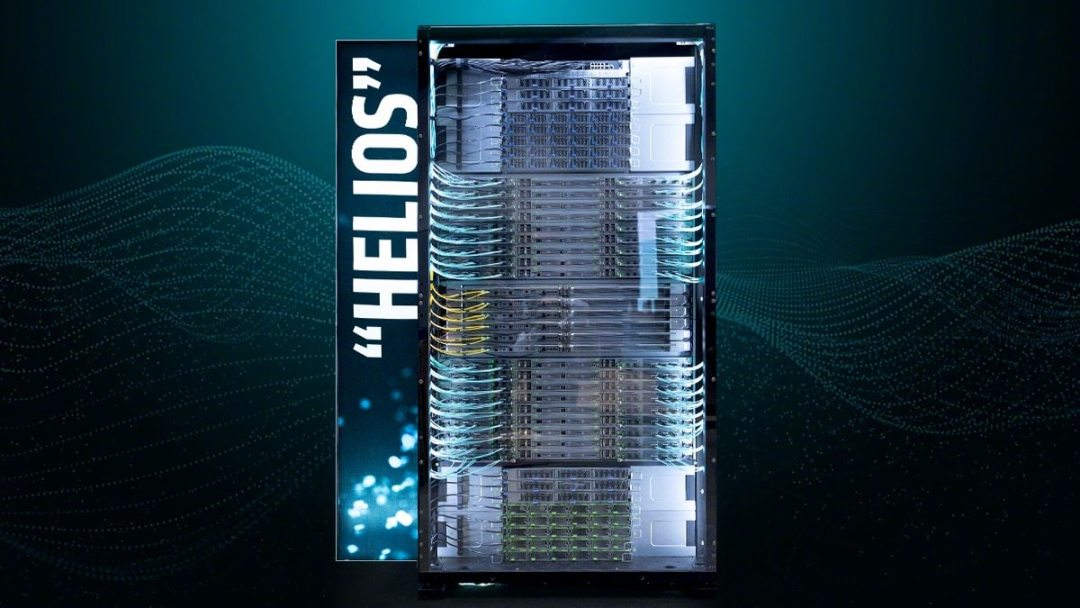
Taalas的CEO Ljubisa Bajic是个AMD老员工:2006年随ATI收购并入AMD,做过CPU-GPU融合芯片架构师,中间去英伟达待过一年,离职后创办Tenstorrent,2023年又拉出Taalas。这次被收购,等于二度回AMD。AMD计划把它整合进加速器路线图,围绕Instinct GPU、EPYC、ROCm和Helios机架做系统级方案。这个月的两笔交易,一笔买"大脑"(空间智能),一笔买"膝跳反射"(推理速度),把GPU之外的生态位全补上。知乎36氪
和你钱包里的9070 XT:暂时没关系
这是数据中心推理卡,不冲着消费级来,游戏党可以把心放肚子里。对普通人的真实影响在下游。专用路线要是跑通,API调用价格、本地部署成本都可能被打下来。至于"家用AI加速卡"?先等Taalas烧录下一个主流模型、看看它60天重做的成色再说。跑本地开源模型的人,倒是可以去Taalas的演示站chatjimmy.ai瞄一眼,那是这块卡给你未来账单打的样。微博
当前文章无评论,是时候发表评论了