这半年装机圈唯一的共识是"内存还在涨",但评论区里悄悄长出了一批新用户:配机器不为打《影之刃零》,为的是本地跑大模型。而这拨人最容易栽的,是一个数字:24G的显存,未必装得下24G的模型。
第一笔账:显存不是仓库,是柜台。
B站UP主"九物AI生产力"算过一笔账:24G卡跑32B模型,8K上下文占用21.9G站得住,换32K上下文要27.9G,直接爆显存——差额全在KV缓存上,另外还有约1.5G的框架开销。所以"我卡24G就能跑24G的模型"是第一个误区,上下文长度才是决定生死的那个变量。哔哩哔哩
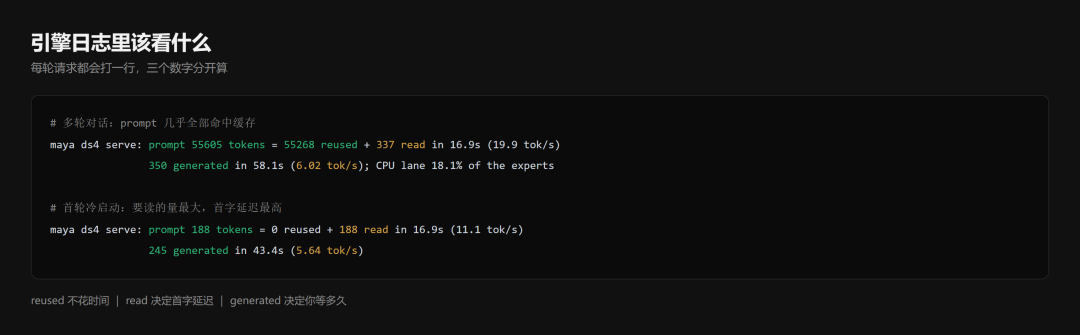
第二笔账:真正卡脖子的不是显卡,是内存。
知乎用户郑世录用5060 Ti 16G+64G内存的机器实测跑176B模型:MoE每次只激活一小部分专家,16G显存够用;真正的大头是80GB级的权重文件。他的经验公式:64G内存、128K上下文、留6G给系统,能跑的模型控制在80G以内。他实测加载84.3G的模型后只剩4.4G余量,开几个浏览器标签就开始换页,生成速度从40 token/s掉到个位数。mmap能救你"装得下",救不了"跑得快"。知乎
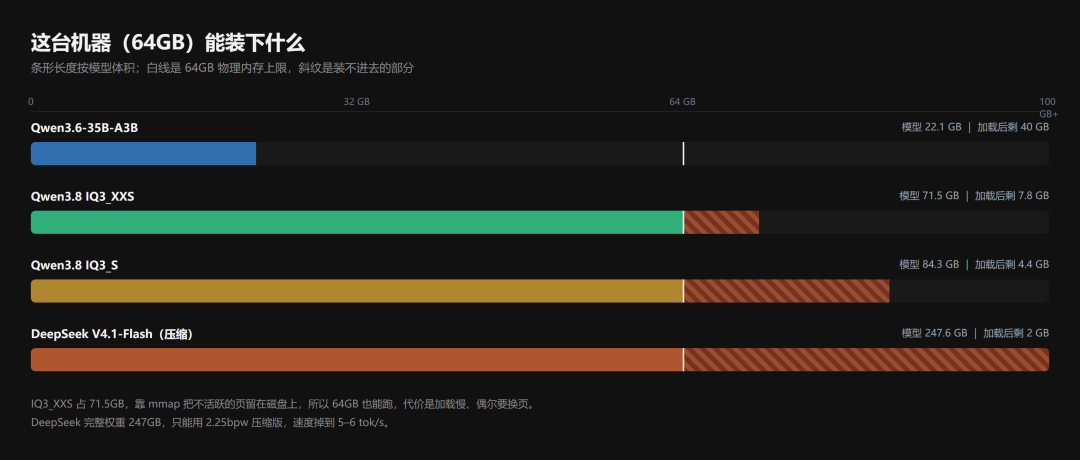
第三笔账:内存涨5倍之后,"便宜"和"快"不再是同一条路。
同样是九物AI生产力的测算:二手24G显存整机1.5万出头,每token/s速度成本355块,全场最快;一体机2.4万有116G可用显存,每GB显存只要207块,容量最省;全新旗舰整机6.96万,每GB显存2175块,两项指标全垫底。要速度蹲二手,要容量走一体机,全新高端是为信仰买单的。哔哩哔哩
那什么人适合折腾?日常有长文档要处理、在意数据不出本地、真有活给机器干的。劝退清单同样值钱:只想闲聊的,云端API更划算;想省钱的,劝退视频标题写得直白——要省钱,别本地部署,折腾的乐趣不算钱。知乎哔哩哔哩
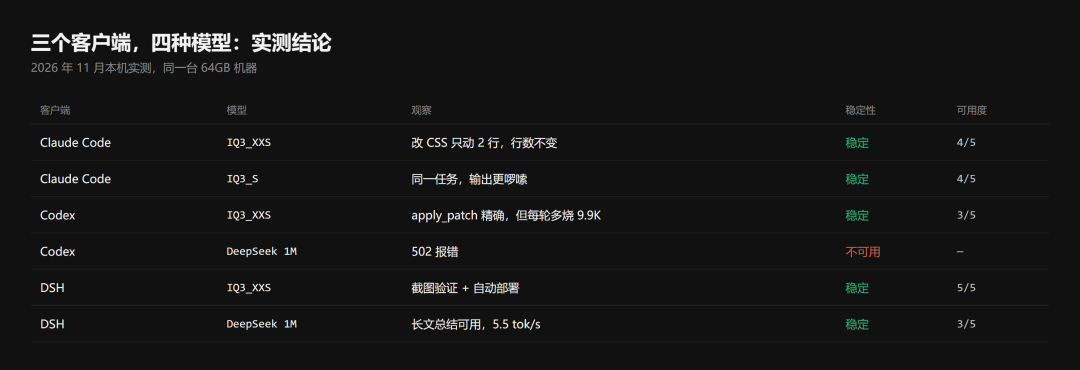
一句话收尾:跑模型的机器不是贵一点的游戏机,而是一道全新的预算题——先看你要多长的上下文、要多大的权重文件,再看你的钱包。