














 深耕数码兴趣领域




21
19
显卡显存不够大?是内存不够——12G老卡配64G内存直接跑125B模型
2026-11-15 10:22:19
0点赞
0收藏
0评论
上周六下午,表弟小磊扛着他那台吃灰快两年的游戏主机来我这儿,说想出二手回点血。机器是台老板子配一张 RTX 3060 12G,电源还是我三年前帮他挑的。我掀开机箱侧板——好家伙,一颗固定螺丝早丢了,侧板拿扎带吊着,风扇转起来带股轴承异响,跟蚊子哼似的。小磊说这破玩意儿谁要啊,3060 现在满大街都是,挂闲鱼怕是没人理。
 图片
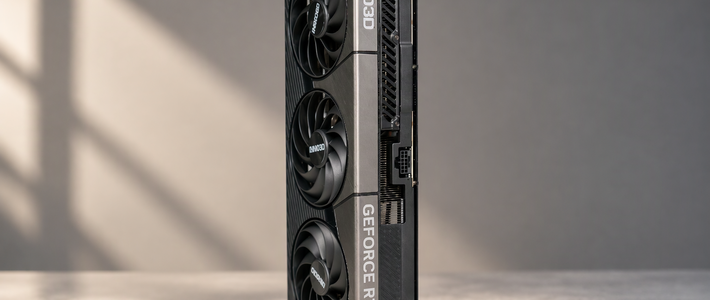
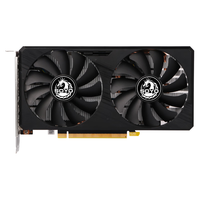
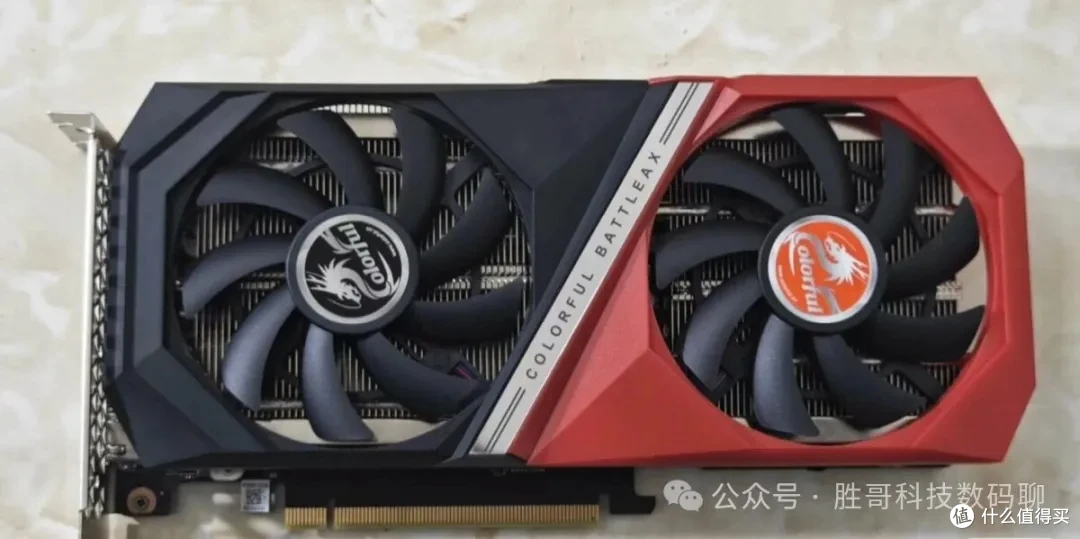
七彩虹战斧系列 RTX3060 12G
我没接话,插上显示器,给他装了个叫 Strata 的开源推理引擎,等加载完,浏览器里跳出一行字:本地跑起来了,1250 亿参数的大模型。小磊凑近看,屏幕上那个叫 Qwen3.8-Flash-Next 的模型正一个字一个字往外蹦,显卡占用 96%,显存眼看要吃满 12G,内存啃了快 48G。他愣了半天,问了句:这破卡也能跑这么大个模型?我说是啊,而且你一分钱不用花。那杯他带来的普洱早凉透了,搁在机箱上,谁也没想起来喝。
 图片
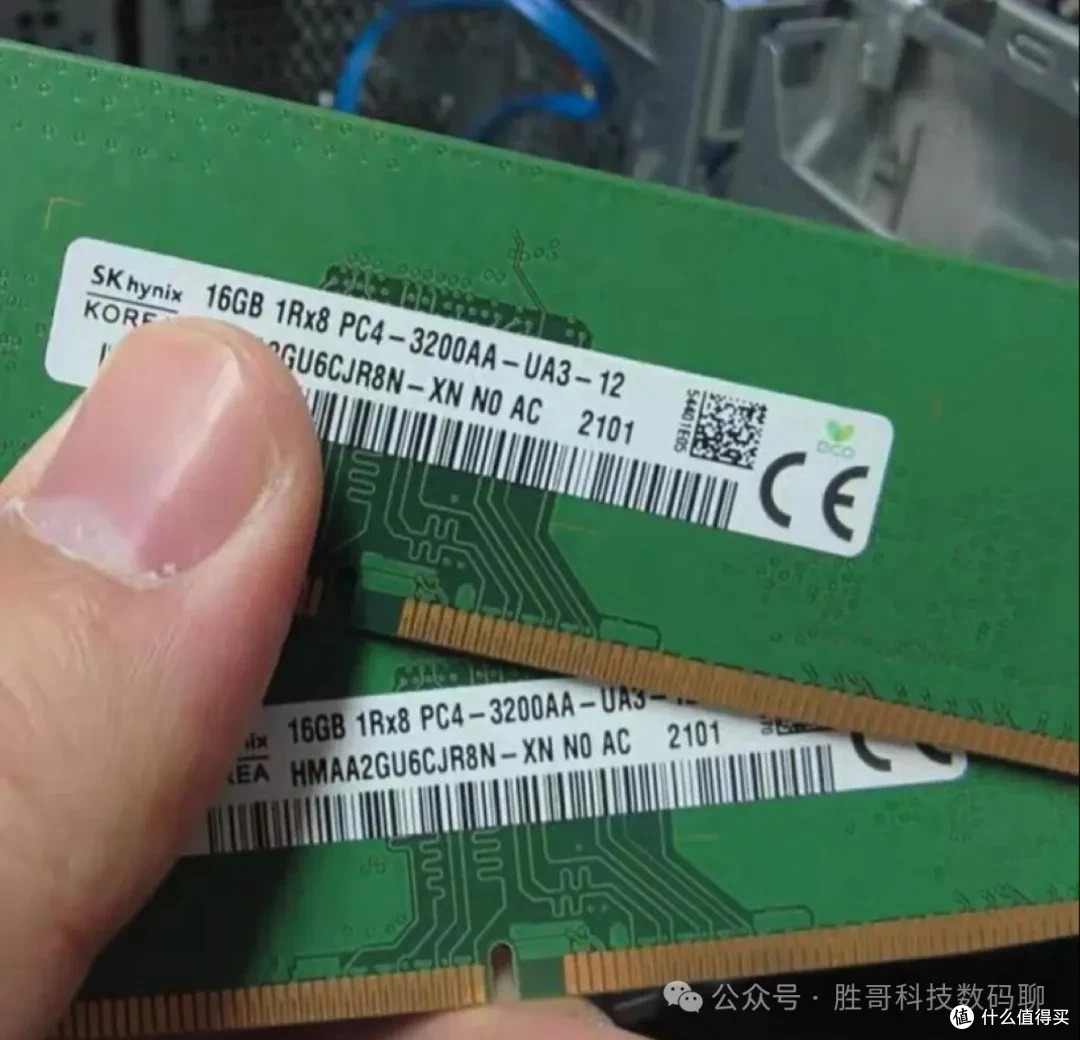
SK hynix DDR4-3200 16G 单条
这事要是放一年前,听着像吹牛。1250 亿参数的模型,那是数据中心 A100、H100 才配聊的东西,普通人摸都摸不着。现在倒好,一张家里吃灰的游戏卡,加个免费开源引擎,就让它老老实实在你桌面上吐字了。我让小磊自己敲了句「帮我写段 Python 排序」,两三秒出结果,他才信这是真跑本地、没走任何云接口。
Strata 这套玩意儿,拆开看不复杂,它吃准了现在大模型一个脾气:MoE 混合专家架构。Qwen3.8-Flash-Next 这模型,肚子里塞了 24576 个专家,可你每蹦一个字,真正干活的就那么约 10 个。剩下两万多个,纯围观。Strata 干的活儿,就是把「围观群众」和「干活专家」分开伺候:
① 最常用的几千个专家,塞进显卡那 12G 显存里(实测能常驻约 4000 个,占总专家一小撮);
② 全部 24576 个专家,铺进系统内存,哪个 token 要用到显存里没有的专家,CPU 当场补算;
③ 一张约 29G 的查表,扔到 SSD 上,用到冷门专家时按表翻,不占内存也不占显存;
④ 再叠一层投机解码:小模型先猜几个字,大模型一次性验证,速度又能提 1.6 到 1.8 倍。
所以你看到的「RTX 3060 12G 跑 1250 亿」,本质是显存只装最热的一小撮,内存扛全部,硬盘托底。显存不够?没事,它本来就没打算全塞进去。
 图片
这里有个捡漏党最爱听的结论:卡你脖子的不是显存,是内存。 我翻了 Strata 自己的档位表,不同量化尺寸要的内存放这儿:
① Coder 版(IQ1_M),加载约 29.6G → 32G 内存就能玩,代码强、别的弱;
② Q2_0,加载约 37.6G → 48G 内存进门槛;
③ IQ2_XS,加载约 39.2G → 48G 内存,官方推荐的默认档;
④ IQ3_S,加载约 54.8G → 64G 内存,效果最好,跟满血版测评几乎对齐。
看见没?一张 RTX 3060 12G 配 64G 内存,五个档全解锁;反过来一张 24G 显卡要是只插 32G 内存,大头档位反而进不去。我那台顶配 Mac 256G 内存当然闭着眼跑,但重点不是它——是你家那台 3060 12G 老卡,加根内存条就能站起来。
数字给到实处。项目作者自测,3060 12G 跑这个 125B 模型,写故事 53 token/秒、写代码 62;换成更沉的 DeepSeek V4.1 Flash 那套(257G 权重),同一张卡掉到 9 到 11 token/秒,提示词读取 155。有玩家拿 3060 配 64G 内存、128K 上下文,实跑 33 token/秒。
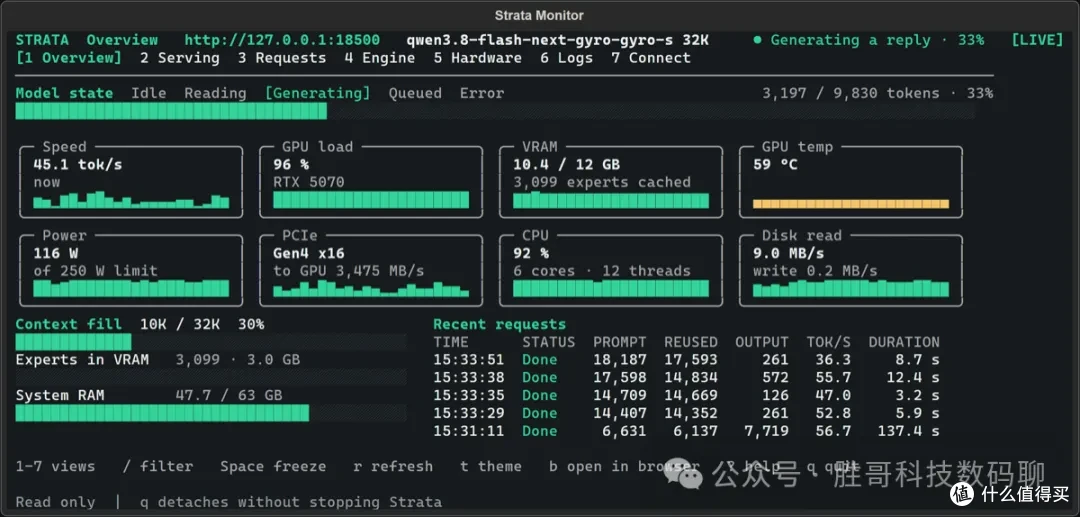
再对比着看:作者在 RTX 5070(12G)上跑 Q2_0 约 94、IQ3_S 约 53,提示词读取 1600 到 2650,24G 的 3090 预估 100 到 140。可官方那张 DeepSeek 套件的实测表里,3060 配 46G 内存跑 9 到 11,反倒把 5070 配 64G 的 4 到 6 甩在后面。官方没解释,道理不难想——12G 卡每蹦一个字,大部分时间都在等硬盘和 CPU,不是等显卡算力。上图 3 就是作者那台 5070 的监控:显存 10.4/12G、常驻 3099 个专家、45 token/秒上下、系统内存 47.7/63G,拿来做参照。硬盘记得留 80G 给模型本体。
坑我也得给你摆明白,别光看标题乐:
① 首次加载会冻机几分钟,它要往内存灌 35 到 55G,别以为死机了;
② 默认串行处理请求,一个人问完下一个才接,多开别指望;
③ 冷启动第一个字能等快一分钟,热起来 0.17 秒一个,体验两重天;
④ Coder 版中文偏弱,写代码猛、聊天一般;
⑤ AMD 卡的图像输入只在 Linux 下可用;
⑥ 最大的量化档从 SSD 流式读,速度会掉到 7 到 8.5 token/秒,别被峰值数字忽悠。
想自己上手也简单:Strata 出了 Windows 和 Linux 的一键安装包,装完本地起一个 OpenAI 兼容接口,连 MCP 服务器都带,笔记本独显都能玩,前提是显卡驱动别太老。你那台吃灰的老机器,真值得救一救。
小磊临了没卖那台机器,周末自己加根内存跑上了,连那股风扇异响都听着顺耳了。所以啊,显存决定你能不能跑,内存决定你能跑多大。下次谁跟你说「3060 12G 就是电子垃圾」,你把这篇甩过去——旧卡别急着出,捡回来装个引擎,比卖废铁值多了。
我是胜哥,一个爱折腾的老玩家。本地大模型这趟水还深,觉得有用,点个关注,咱们捡漏路上接着唠。





