搬家潮里,所有人都在问"去哪",没人问"搬出来的东西呢"
9月印象笔记从苹果App Store下架、会员价从98元档跳到498元之后,“象亲”(印象笔记老用户的自称)这半个月只忙三件事:骂涨价、找平替、导笔记。小红书上"同步挂了"“重装之后几百条笔记没了"的求助还在滚动更新,有用户直接问出了那句"是不是印象笔记的公司跑路了”。 一位从2014年用到现在、2019年乘活动囤了27年会员的重度用户,这次连给娃买个会员都下了决心不买了,她的原话是"涨价400%,太离谱了,用不起"。 而知乎"有么有印象笔记的平替产品?"的提问下面,回答一路写到了10月下旬。小红书小红书
但有个问题几乎没人问:笔记导出来了,然后呢?
大多数人把导出当"买保险"——家底拉出来,硬盘一放,心安理得继续搬家。知乎用户neowin用了14-15年印象笔记,试过OneNote和各种开源笔记后决定留下,但留了个清醒的习惯:每年续费前,都全量导出一次,备份到NAS和网盘。他的原话是,虽为一介平民,但它是我重要的数字资产之一。 是资产,就该算估值,而不只是清点库存。真把这笔账算出花来的,是头一位。知乎
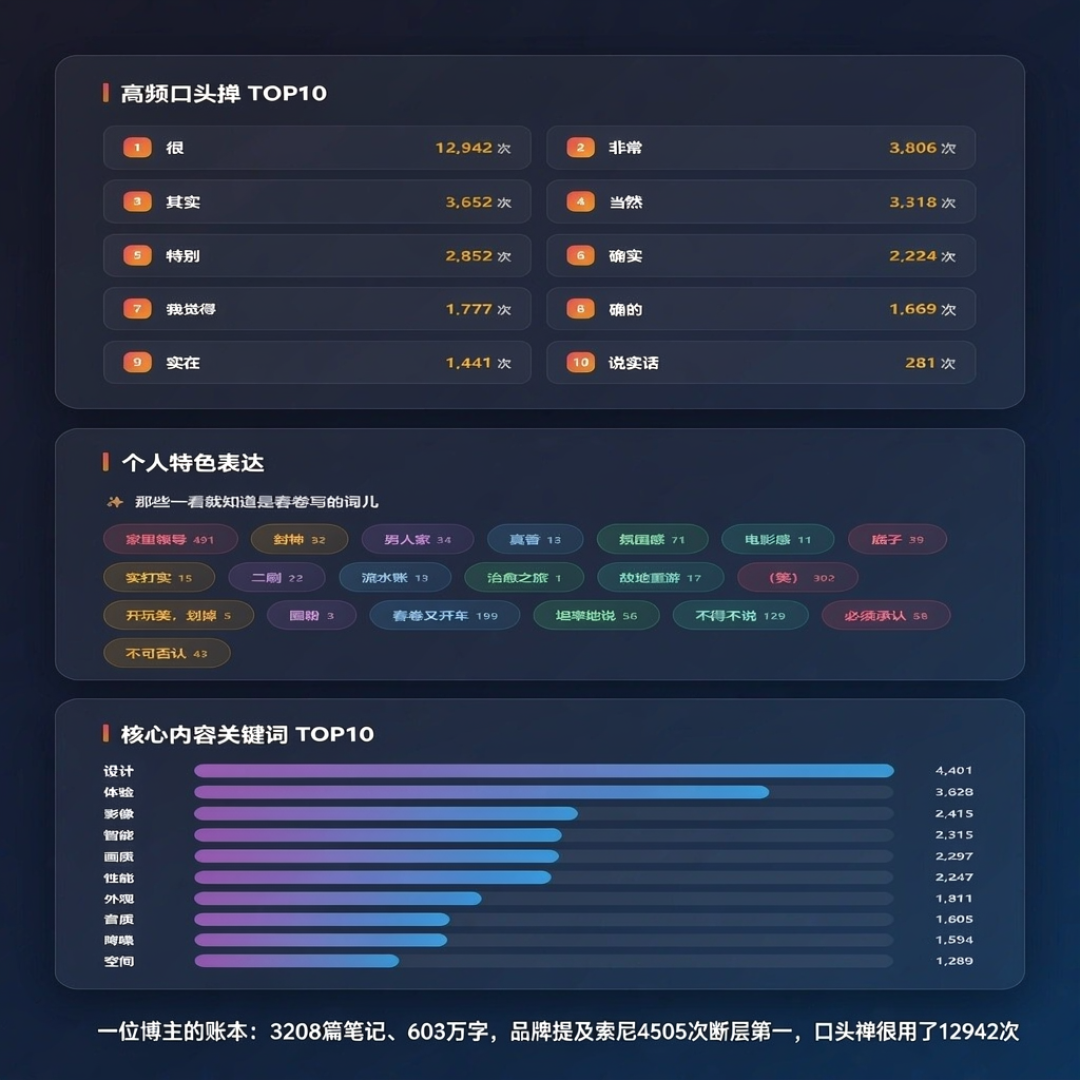
一个博主的账本:3208篇笔记、603万字
8月初,数码圈博主春卷把十多年存在印象笔记里的写作笔记全导了出来,直接丢给AI分析。 拿到的数据是这样的:微博
3208篇笔记,跨度从2013年10月到发帖当天,将近十三年;纯正文约603万字,平均每篇差不多1900字;
最高产的是2016年,一年366篇、超过一天一篇——那年他刚从老东家PChome独立出来创业,赶上新机发布会一个接一个的数码博客黄金期;
内容分布:数码影像654篇(约占五分之一)、科技观察283篇、音频HiFi 232篇、汽车试驾223篇、旅行游记129篇;
品牌提及:“索尼"出现4505次断层第一,比第二名"vivo”(3092次)多出近一半;"理想"2563次排第三——“进入手机摄影时代,蓝厂的被提及率陡然上升”;
口头禅:"很"用了12942次遥遥领先,“家里领导"出现491次,”(笑)"用了1200多次;"封神"32次、“真香"13次,他自嘲"用得倒是挺克制”。
他自己的总结特别到位,这十三年的写作轨迹,几乎就是一条消费电子的进化路线图。 这就是"家底"和"垃圾数据"的区别。对一个持续写作者来说,笔记不是剪藏的堆头,而是一份连续的第一人称语料:你的工具变迁、消费决策、语言习惯、兴趣转向,全在每篇1900字的平均值里。这份数据,全世界任何一个大模型都没有——只有你有。微博
账号"毛哥和江叔"的"江叔"走得更远。他把12000+条印象笔记、9300+条微博全文、约4000条今日头条收藏的元数据全部从云端扒回本地机器,以方便AI使用的格式保存。 加上本地原有的7800多天跨越5代记录格式的日志和1300+条Obsidian笔记,他管这套东西叫"外典-内志个性化信息联邦"。微博
他的用法是笔记软件本身做不到的:让AI提取他十多年来关注的心理学-认知科学-神经科学主题的演变轨迹,再和日志里的焦虑症记录、锻炼记录做交叉分析。 笔记应用回答的是"存在哪",AI语料库回答的是"这意味着什么"。微博
复活流水线分三段,每一段都有坑
普通象亲怎么把"导出了"变成"能用"?我整理了目前社区野生路线,分三段。
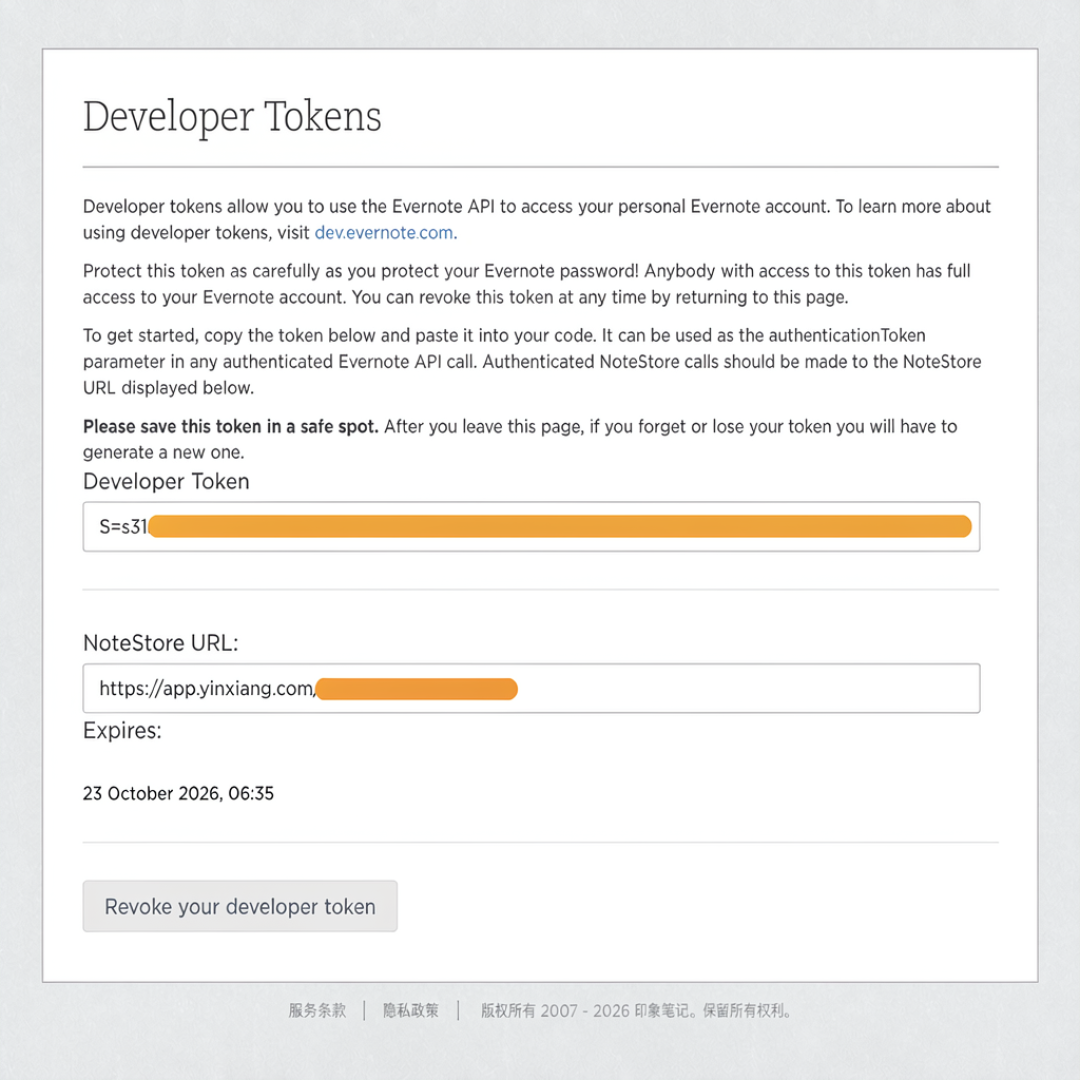
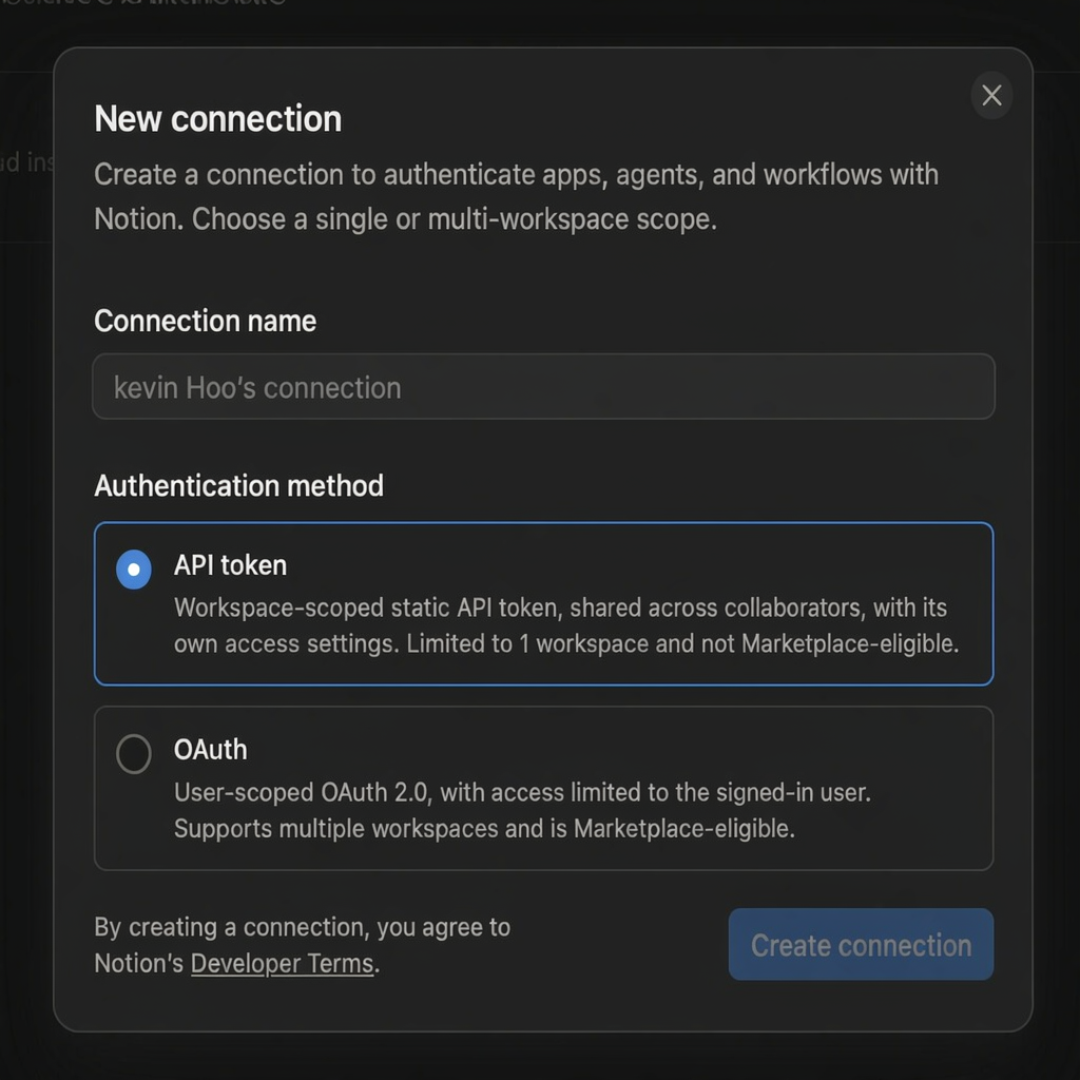
第一段:导得干净。 国内版导出格式是已知坑。小红书的kevin攒了1000多条笔记,早期想整体迁去Notion,发现国内版印象笔记现在导出只剩.note和.html,这俩Notion压根不认,一条条复制真的会手残。 他10月跑通的方案是直接把两边的API打通:印象笔记网页版账号设置里拿一串S=开头的开发者Token,Notion新建integration拿一串ntn_开头的密钥,一边读一边写,全程跑完1000多条,几乎全搬过去了。小红书
工具路线同理。B站UP主小廖演示过用开源项目evernote-backup为中国版开同步,先初始化中国版数据库(`init-db --backend china`),再一条命令同步所有笔记到本地数据库。 本地库建起来之后,转成Markdown导入Obsidian就是顺手的事,这条教程在同类视频里收藏过百。哔哩哔哩
但有个安全提醒必须原样转述:kevin给了两种玩法,"懒人版"是把三个Token发给常用AI助手让它自己跑,"稳妥版"是跑本地小工具,数据全程在自己电脑上,不过第三方,还支持断点续传,中途别断网、别合盖休眠。 开发者Token等于账户的最高权限,笔记里有证件照片、财务记录、医疗档案的,老老实实选本地路线。小红书
第二段:转得能动。 enex/note转成Markdown文件夹库:Obsidian本身就是一堆本地md文件,思源笔记支持全量Markdown导出,开源自托管项目也在接这单生意——最近讨论度高的EdgeEver,卖点就是找回经典印象笔记的三栏高效体验,同时具备完全开放的数据架构与原生AI Agent联动能力。 这一段解决"十年后还打得开",吃的是长期可读性,短期没有回报,别指望它立刻产生价值。微博
第三段:问得出口。 把转换后的语料放进可检索的知识库(本地RAG,或者直接喂给支持长文本的模型),开始问只有关你自己才能问的问题:
这十三年我买过哪些相机、每次写没写体验、态度变了几次?
“失眠”“疲劳”"体检"这几个词,是哪一年开始出现频率拐点的?
我收藏的文章里,哪一类我剪藏之后再也没打开过——对照剪藏和自写的比例,先删还是先留?
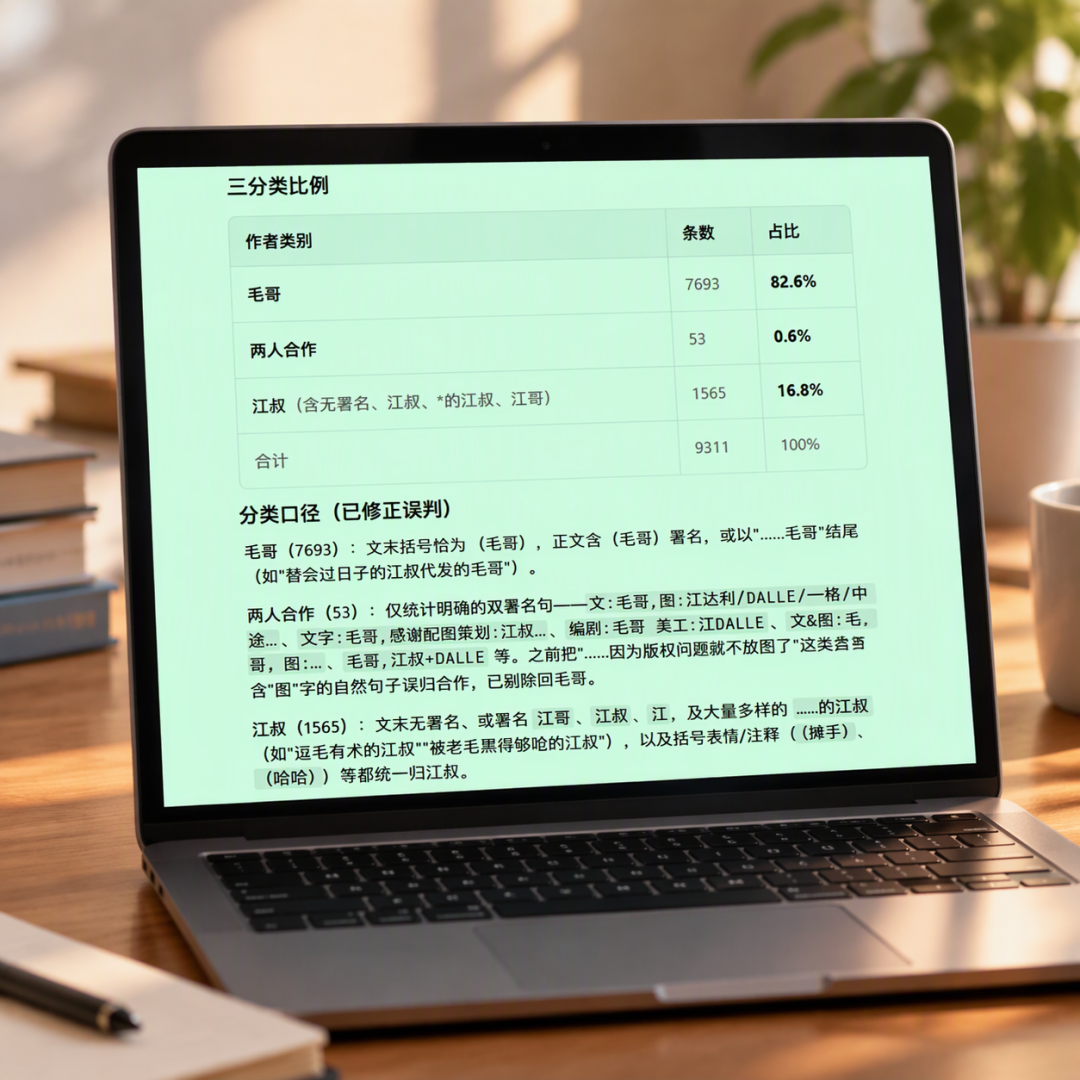
第三问正是复活的门槛所在:语料里别人写的东西占多大比例,决定了这件事值不值得做。
谁该做,谁别做
把社区样本摊开分层,这事不是人人有份:
重写作型:篇均字数高(春卷的1900字/篇是参照线)、长期连续更新。收益最大,值得专门花一个周末跑完三段流水线。
收藏型:笔记主体是剪藏文章。语料价值大打折扣——AI读出一堆是别人的观点,你的提问会得到别人的答案。这类用户的第一步不是喂AI,是"识别剪藏、修剪冗余"。
轻备忘型:几百条清单、密码提示、购物备忘。不值得折腾分析,把导出件归档好,学neowin养成"一年备份一次"的习惯,让它安静躺着就行。
还有一盆冷水值得泼。做了8年知识管理的尔东陈去年把印象笔记停了,以前的做法是建上百个分类、每周花时间整理,现在的判断是,AI一搜就有答案,这套老办法不值钱了;真正值钱的是你独有的经验、判断和决策过程,这些才是AI真正读懂你所需的语料。 他的新系统把整理环节全交给AI,自己的动作只剩下门槛最低的输入。翻译成象亲能用的标准:如果你的"复活"只是把笔记重新整理得漂漂亮亮,那不是资产觉醒,是把旧乱草搬进新院子。知乎
别让家底过期
印象笔记的会员合同是按年签的,语料是按十几年计的。下架、涨价、同步丢数据这一轮轮风波,真正砸实的是一个观念:笔记可以没有存放的地方,但不能没有在你手里、可读可问的格式。
导完笔记不是搬家结束。三件今天就能起步的事:
花十分钟做一次"语料体检":把你的导出目录丢给任何AI,数清楚笔记总量、年份跨度、自写比例——先知道自己是重写作型、收藏型还是轻备忘型,再决定投不投入;
值得做的,跑到第三段:问出一个"只有你才能问、答案只有你有"的问题,这是判断语料活没活的唯一标准;
不值得做的,也别删:归档、命名、存两份,等哪天想问再说。
接下来值得盯的信号:印象笔记官方会不会进一步收紧或放开批量导出与Token策略(导出格式残缺正是这轮矛盾的起点)、evernote-backup这类开源工具能否跟上国内版接口变动、以及EdgeEver们会不会把"接住印象笔记存量"做成标准功能。
家底已经搬出来了。下一步,让它开口说话。