先把文件"拆了包装"再喂AI:文档党砍掉一半token钱,但论文串段这事,转换救不了
这两周,小红书和知乎几乎同时在推一件事:别把 PDF 直接丢给 AI。
传播最广的一条笔记标题就叫《claude传PDF浪费70%Token》,7400 多赞、1.4 万收藏,作者给的办法是先转 Markdown 再喂。紧跟着《直接把PDF丢给AI,一半的token就浪费掉了》《别再把PDF直接丢给AI》一批同类帖在涨。一位诉讼律师说得更实在:新模型出来之后读文档确实强了,但几十页上百页的报告、合同、论文直接丢,周额度都不够用。小红书小红书
文档党的新共识似乎是"先转再喂"。但等一下——你浪费的是钱,AI 读错的是结构,这是两种病,一副药治不了两头。
病一:你付的钱,一半买的是"包装"
PDF 这个格式,生来是给人看和打印的:页眉页脚、页码、字体样式、版式标签,全都混在内容里。你丢给 AI 的时候,它把这些"包装"一起吞进去计费。知乎一位做教案 AI 化的老师给过一个直观对照:同一份教案,PDF 至少 1MB,转成 Markdown 只要 20KB,相差近 50 倍——文件大小不等于 token 数,但这个量级的差距方向是成立的。10 月 21 日刚发的一篇企业 Token 治理复盘说得更狠:AI 成本的大头往往不在输出,而在反复输入的上下文。知乎知乎
但先泼两盆冷水。第一,“70%”"省一半"都是社区自述数字,文档结构差异极大,有的省 70%,有的几乎不省,别把个案当定律。第二,转换不是免费的——工具要装、结果要抽查,低频用户为省这点钱折腾一天,不如不用。小红书
真正值得动手的是三类人:拿周额度订阅读长文档的(律师、研究僧)、一个文件反复喂不同模型的、批量处理几十上百页的。
病二:摘要"串戏",锅不在模型,在进模型前的那一步
论文党应该都见过这个场景:让 AI 总结一篇双栏排版的论文,摘要里上一句还在讲实验方法,下一句突然接上另一栏的结果讨论。知乎 10 月 17 日一篇专门拆这件事的文章给出的判断很扎心:先别让它"再仔细读一遍",值得检查的是文字进入分析环节前,按什么顺序排了。很多提取器把双栏 PDF 按行左右交错地抠出来,AI 拿到的原料本身方法就和讨论搅在一起——这时候你要求它"整理成通顺文章",只会得到一份更流畅的错误版本。知乎
跨页表格是另一个重灾区。上海 AI 实验室 MinerU 系这次更新专门点了这个问题:表格横跨两页时,上半截被解析成表格 A、下半截成了表格 B,表头直接丢了。一篇讲 RAG 检索优化的文章也说,换了 embedding、调了切片还是不行,根子往往在更前面的文档解析层。知乎知乎
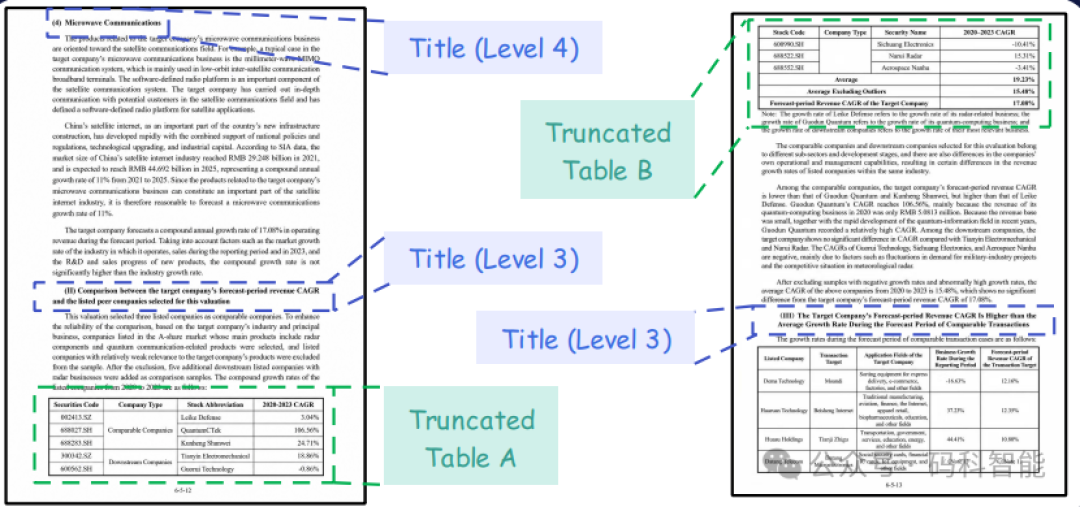
所以反常识的结论来了:"转成 Markdown"本身不自动治好串段。用基础文本提取器转出来的"干净"Markdown,顺序照样是错的;garbage in, garbage out,只是垃圾变轻了。
三种文件,三条路:先分病情,再选工具
你的文件 | 该怎么做 | 参考工具 |
|---|---|---|
文字型报告、公文、合同、Word | 转了再喂,省钱 | |
双栏论文、公式多、表格复杂、扫描件 | 要"版面级解析",不是简单转文字 | MinerU(上海 AI 实验室开源,版面级解析)、Marker 同类 |
图为主、依赖版面的(设计方案、白板照片、图表密集报告) | 别转,原样交给多模态模型 | 平台自带文档输入即可 |
最后这条,还是那篇《别再把PDF直接丢给AI》里最值钱的一句话:文字型 PDF 先转 Markdown;扫描件、复杂图表或依赖版面的,保留原 PDF 给多模态模型——关键不是一刀切,而是按任务选格式。转 Markdown 会把图表信息直接丢掉,省了 token,丢了内容,反而更亏。小红书
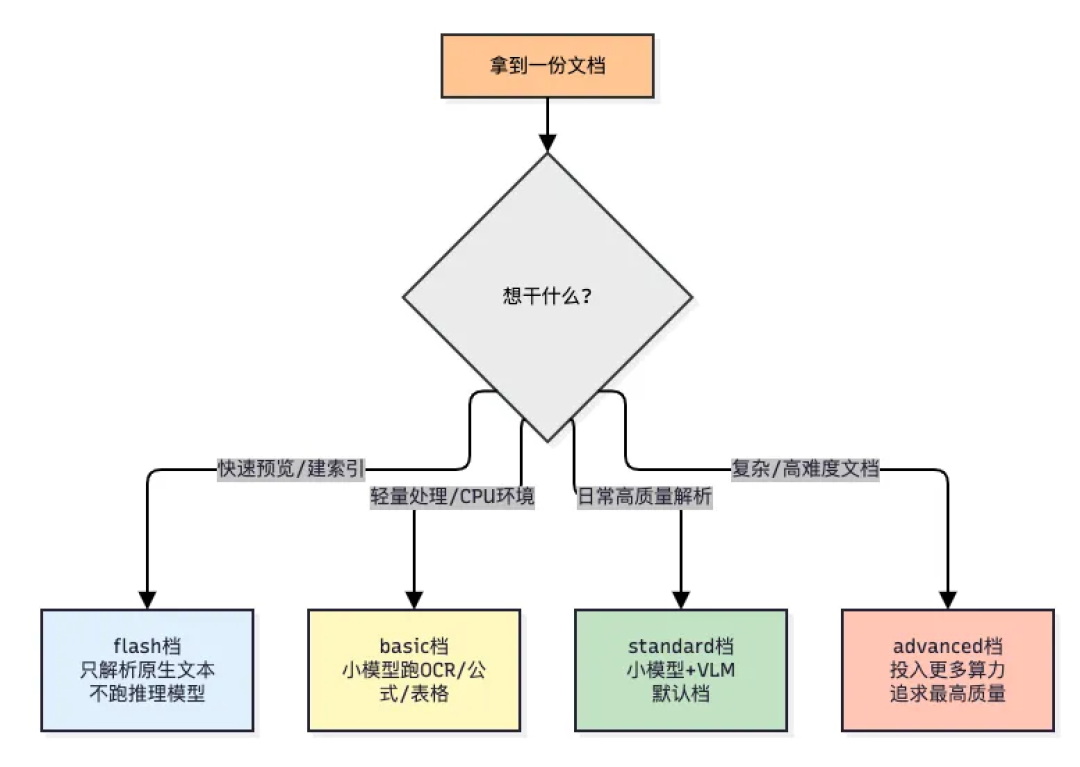
这条"版面级解析"的路也在加速:上海 AI Lab 的 MinerU 2.5 只有 1.2B 参数,靠"先看全局版面、再回原图局部精读"的两阶段解耦,在 OmniDocBench 上拿到了 90.67 分。如果你用的 Kimi、豆包、千问们的内置文档解析够用、额度也不紧张,不必自己折腾;DIY 转换是给高频、大批量、额度受限的人准备的。真决定自己动手,先按用途选解析深度,别无脑上最重的档。知乎
喂完之后:用三个问题验收,别用感觉
那篇双栏串段文章给了一份可以直接抄的验收清单,比"AI 说得对不对"这种玄学靠谱得多。知乎
每条重要结论,能不能回到明确的页码和原文区域?它写出了页码不算过,你要自己打开原页对照。
原文的限定条件还在不在?“在该样本内”“尚不能确定”"可能"这类词,不应该因为摘要变短就消失——消失了,结论强度就被 AI 偷偷拔高了。
看不清、接不上的地方,它有没有留空缺如实说?全篇流畅但没有一个"无法确定",往往说明它在替你猜。
三问过不了,回去修文件,别改提示词。
还有个老提醒顺带一句:敏感合同脱敏要的是"文件里真的没了",不是"人眼看着没了"——黑块盖住的 PDF,底层文字、批注和元数据都还在。这与喂之前转不转格式无关,是另一道闸。知乎
文档党今天可以做的一件事
别转发"70%"。挑你最近最常喂 AI 的那 10 页文件,走一遍:转 → 喂 → 三问验收。自己量一次 token 差和差错位置,你就知道你的文件属于哪种病、该走哪条路。这周 MinerU 2.5 论文刚挂上 ACL、"Markdown 是不是 AI 时代默认格式"还在吵,工具还会换,但"先验货再投喂"这个流程,值得固化进你的习惯里。