这两天GPU并行计算圈子里最值得停下来看的,不是某张卡又跑了多少分,而是两行代码。
10月19日,亚马逊推出 TorchNeuron;第二天(10月20日),圣何塞 PyTorch Conference 2026 上,谷歌宣布 TorchTPU 正式在 GitHub 开源(Apache 2.0)。一个把 PyTorch 应用往自家 Trainium 芯片上搬,一个把 PyTorch 原生带到 TPU 上。两朵云互为竞争对手,却在24小时里对准了同一个地方:英伟达经营了近20年的 CUDA 软件生态(深科技,知乎,2026-10-21)。深科技
对天天跟 kernel、显存、NCCL 打交道的人来说,这事的真正问题不是"英伟达股价",而是:我仓库里这套代码,离开 CUDA 到底要付多少钱? 这两周全网的文章、评论和官方文档来回打架,我把账拆开算给你看。
第一笔账:这两个仓库到底承诺了什么,又没承诺什么
TorchNeuron 的卖点是保留你熟悉的一切:模型 `.to(‘neuron’)` 一行迁移,eager、torch.compile 和自研 NKI 内核都支持,还配了 vLLM Neuron 推理插件。亚马逊官方口径:已有30多家早期客户(覆盖机器人、世界模型、语音AI),自研芯片业务年化营收超250亿美元(亚马逊官方博客/路透,2026-10-19,转引自知乎AI日报)。注意"年化营收超250亿"是亚马逊自称,不是审计数字。知乎
TorchTPU 的技术含金量更高一点,也容易被标题党讲歪。按36氪(新智元)9月的拆解,此前 vLLM 要跑 TPU,中间隔着一层叫 TorchAX 的"翻译墙",每个算子逐一翻译成 JAX 执行,分页注意力兼容问题修了一年多;TorchTPU 用 PyTorch 自带的 PrivateUse1 后端接口,让 TPU 直接成为原生 torch 设备——vLLM/SGLang 的调度器和 API 层核心代码直接复用,谷歌此前数百小时打磨的 Pallas 内核大部分"空降"进新环境,DDP、FSDP2 无缝运转。36氪
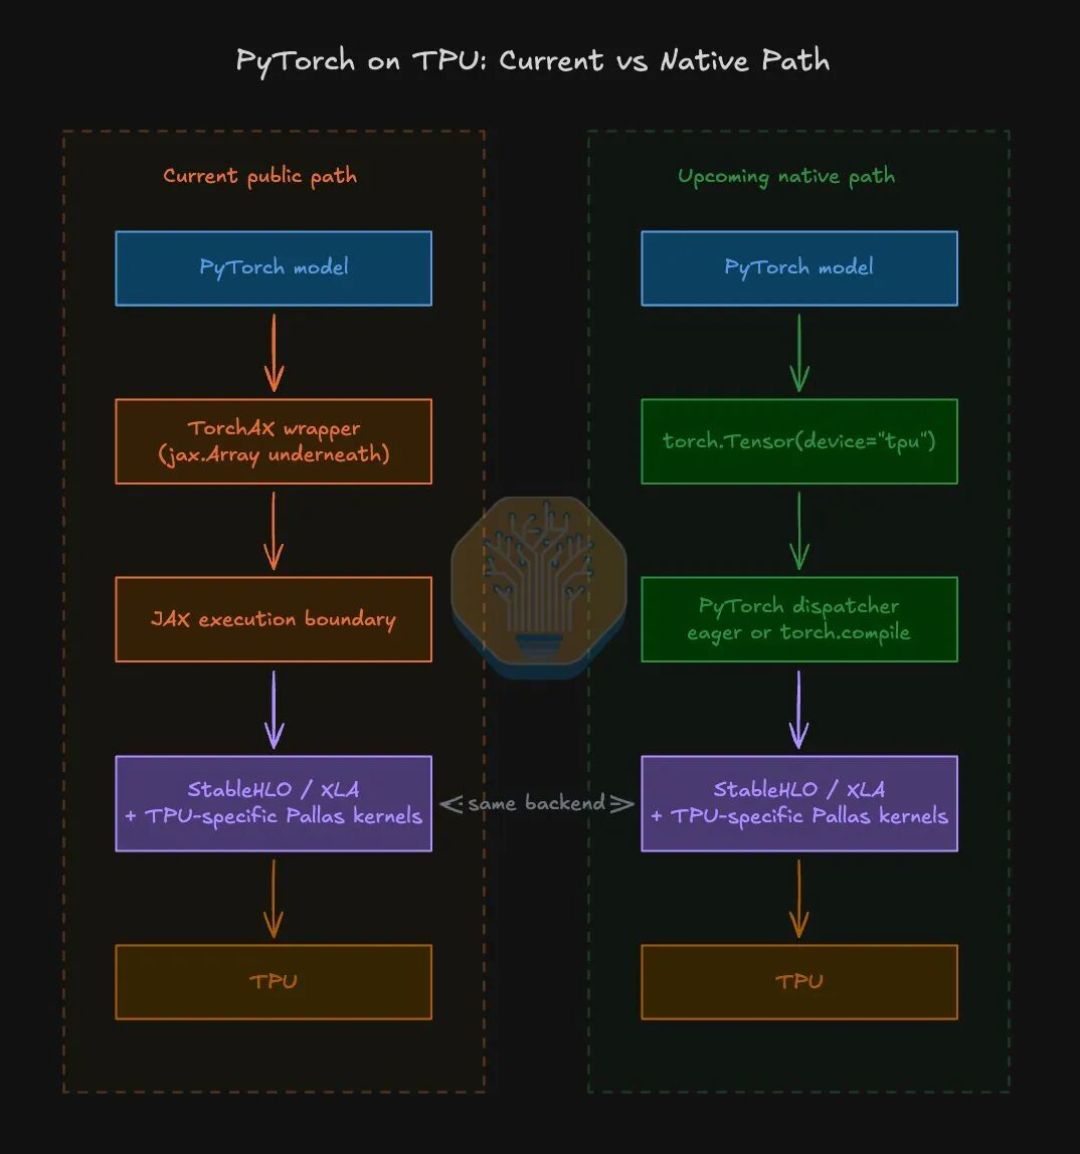
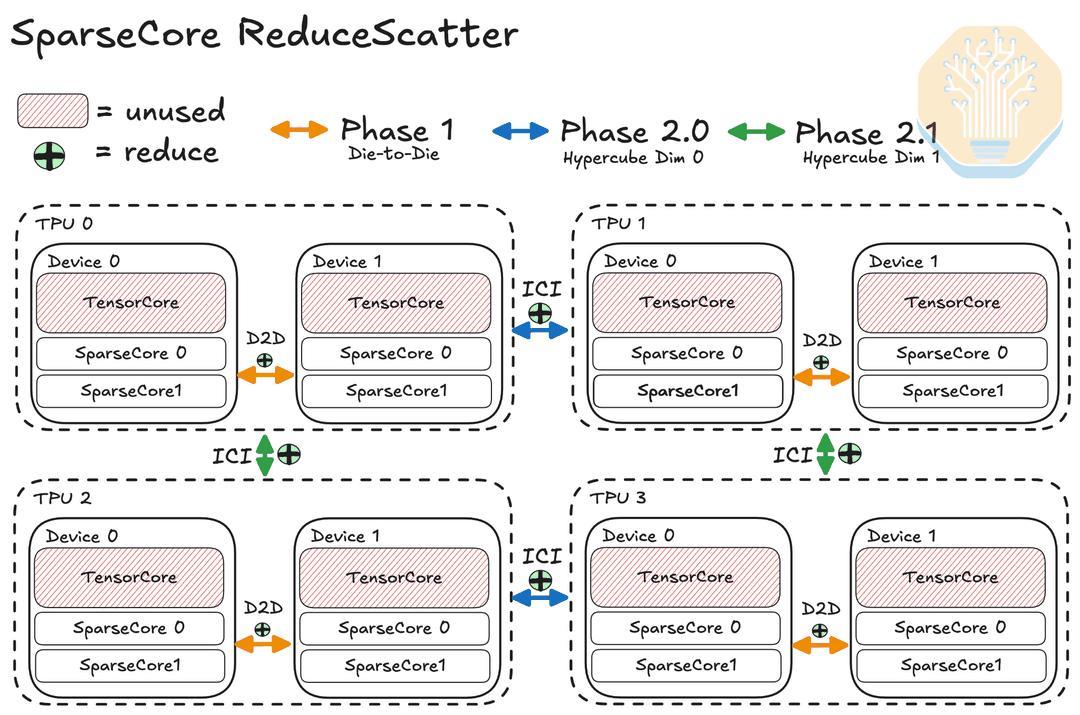
官方还拉出了豪华共建名单:Meta 的 PyTorch 团队共同开发(并推动其支持 LLM、广告、推荐负载),Hugging Face、vLLM、SGLang、TorchTitan、Ray 在列(深科技)。披露的性能口径是:TorchTitan 在 Ironwood TPU 上支持最高8192颗的大规模分布式训练,Qwen 3 8B 相关测试实现最高约52% MFU——但谷歌自己就写了免责声明:这是特定训练配置下的利用率,不等于"比 GPU 快52%"。跨这么多颗芯片还能跑起来,靠的是把 ReduceScatter、MoE 路由这类通信任务下放到每颗芯片附带的 4 个 SparseCore 上,让 TensorCore 专心算矩阵——这套"算的归算、搬的归搬"的调度,正是 TPU 敢报出高 MFU 的底层原因。深科技36氪
边界同样要念一遍官方原文级别的:TorchTPU 不意味着 CUDA 程序能直接在 TPU 上跑,涉及 CUDA 专用算子、自定义 kernel 和硬件特定优化的项目,仍然要适配和调优(深科技)。微博评论区正好吵的就是这个:有人说"改个配置就上TPU,这波真香",也有人泼冷水——“换芯片哪是改个配置的事,老代码跑惯了想挪窝真没那么容易”(微博,2026-10-21)。深科技微博
第二笔账:砍的不是算力,是"重写"那一行预算
CUDA 的护城河从来不是峰值 FLOPS。是 cuDNN、NCCL、TensorRT,是二十年攒下的算子库、调试工具和肌肉记忆。企业买非英伟达芯片的真实成本 = 硬件采购价 + 软件迁移 + 性能调优 + 系统维护 + 人员培训(深科技,2026-10-21)。前面四项加起来,常常比差价贵得多——这才是"芯片便宜但没人换"的原因。深科技
而性价比这一侧其实早就有数了。SemiAnalysis 今年9月发布的首份 Ironwood 第三方推理测算(同款开源模型、FP8 对 FP8、输入8k输出1k 的对等负载):每百万 token 成本 TPU 约 $0.181,B200 $0.222,B300 $0.276;每美元性能 TPU 最高领先 B200 约50%、对 B300 逼近96%(36氪/新智元,2026-09-10)。黄仁勋4月在 Dwarkesh 播客放话"TPU 与 Trainium 都不敢来跑分",五个月后是别人替谷歌把价标了出来。Anthropic 更是用行动投票:超过100万颗 TPU,约40万买断、60万租赁(36氪,2026-09-10)。36氪
也就是说:账本上"硬件更便宜"这一行早就写好了,缺的是"软件让你不改代码就能用"这一行。 TorchNeuron 和 TorchTPU 前后脚开源,砍的恰恰是这一行。竞争规则正在从"谁的芯片快"变成"谁能让人不改代码就换芯片"。
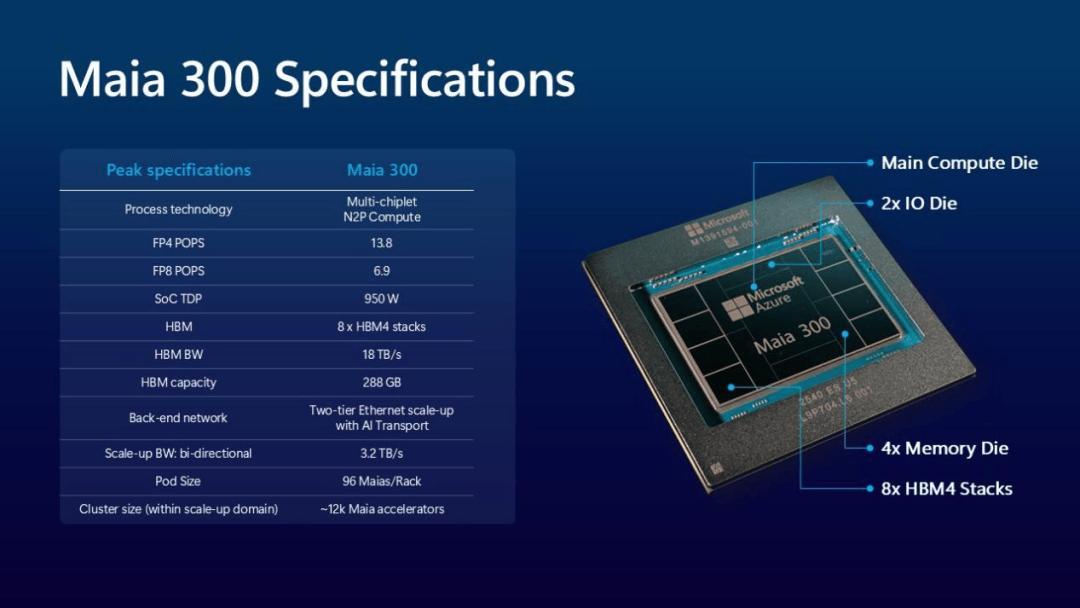
而且下注的不止这两家。10月12日,纳德拉官宣微软计划 2027 年大规模部署自研 Maia 300,用软件定义数据流架构专攻推理成本(36氪,2026-10-14)——云厂商一边继续买英伟达的卡,一边人手一份自研芯片的"保险单"。36氪
反证也得摆出来:36氪5月还转载过美国 AI 领袖砸场谷歌的言论——“选了谷歌,落后一年”,省了钱输了时间。生态墙被凿开一条缝,和被拆掉,中间隔着的可能是整个产品线。谷歌和亚马逊也都没放弃英伟达:大厂普遍自研芯片+NVIDIA GPU 混部,谷歌明确会继续在云上提供英伟达算力(深科技)。深科技
第三笔账:你现在该不该动?分四类人
手写 kernel / 性能优化党:你的手艺不但没贬值,反而更稀缺了——两家都在招懂硬件写内核的人(NKI、Pallas 就是证据)。你站的那半边墙还立着,慌什么。
上层 API 党(拿现成框架微调、vLLM 起推理服务):这是被"一行 .to()"命中的群体。可以开一个隔离的试验田,拿你自己的负载跑一遍 per-token 成本,别跑主线。
成本决策者:$0.181 vs $0.222 是第三方特定负载口径,52% MFU 是官方口径,都别直接抄进采购 PPT。端到端迁移人力成本这一列现在还没有公开数据。
学生 / 入门:先学并行模型和 CUDA 基础,它仍是通用货币;TPU 的 mesh、128-lane tile 这些概念,等你要用再说。
接下来盯这四个信号
亚马逊计划向 PyTorch 主项目贡献的"减少硬件特定依赖"代码,是否进入后续正式 release(深科技/亚马逊口径)——进了主分支,才是真拆墙。
vLLM/SGLang 在 TPU、Neuron 插件上的算子覆盖清单,与 CUDA 侧的差距是否逐月缩小。
是否出现第三方独立做的端到端迁移案例(含人力成本),而不是单模型跑分。
Meta 的双线动作:刚把 MI350X 调到与 B200 打平,又参与 TorchTPU 共建——最大买家持续多头下注,本身就是风向标。
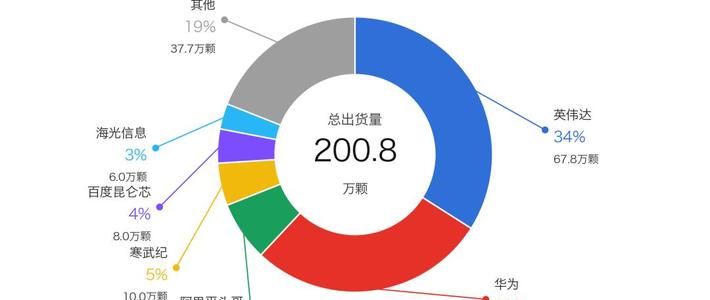
这套逻辑对国产算力同样是明牌。IDC 统计的 2026 上半年中国数据中心 AI 加速器出货量(总计200.8万颗)里,英伟达份额已收缩到34%,华为28%,阿里平头哥7%、寒武纪5%、百度昆仑芯4%、海光3%(36氪/字母榜,2026-10-14)。份额能抢到,编译器、算子库、PyTorch 适配接不接得住才是下一关——谷歌这次示范的"先把框架路铺平",就是标准答案。36氪
过去,是先选芯片、再学那套生态;这两周开始,变成先用 PyTorch 写、再按价格供给挑硬件。真正争夺的不是 GPU 订单,而是你明天早上打开 IDE 时,值不值得多试一行 `.to()`。护城河没塌,但收费口已经拆了两个——搬家税降到多少,看接下来两三年真实的迁移案例,而不是发布会。