DeepSeek 刚交卷,本地党直接分成两半。10 月 17 日,DeepSeek 官方把 V4.1-Flash 更新至 1017 版本,第三方榜单已把它抬到"国产第一、全球第 14"。消息炸开的同一晚,本地大模型圈被问得最多的不是它有多强,而是一个问题:我的卡能不能跑?知乎微博微博
先泼一盆冷水。官方推理引擎 deepinfer 在 10 月 20 日正式开源,连配套协议工具 deepseek-recipe 一起放出。但这东西不是给家庭用户准备的:它本来就是 DeepSeek 自家线上推理服务用的引擎,官方定位是给要运营推理后端的人用的。支持名单上写着英伟达 SM100 级 GPU 和华为昇腾 950 芯片。拆解者还补了一句,想跑它,“也需要SM100才能运行”。换句话说——数据中心的工具,家用机够不着。知乎知乎知乎36氪知乎
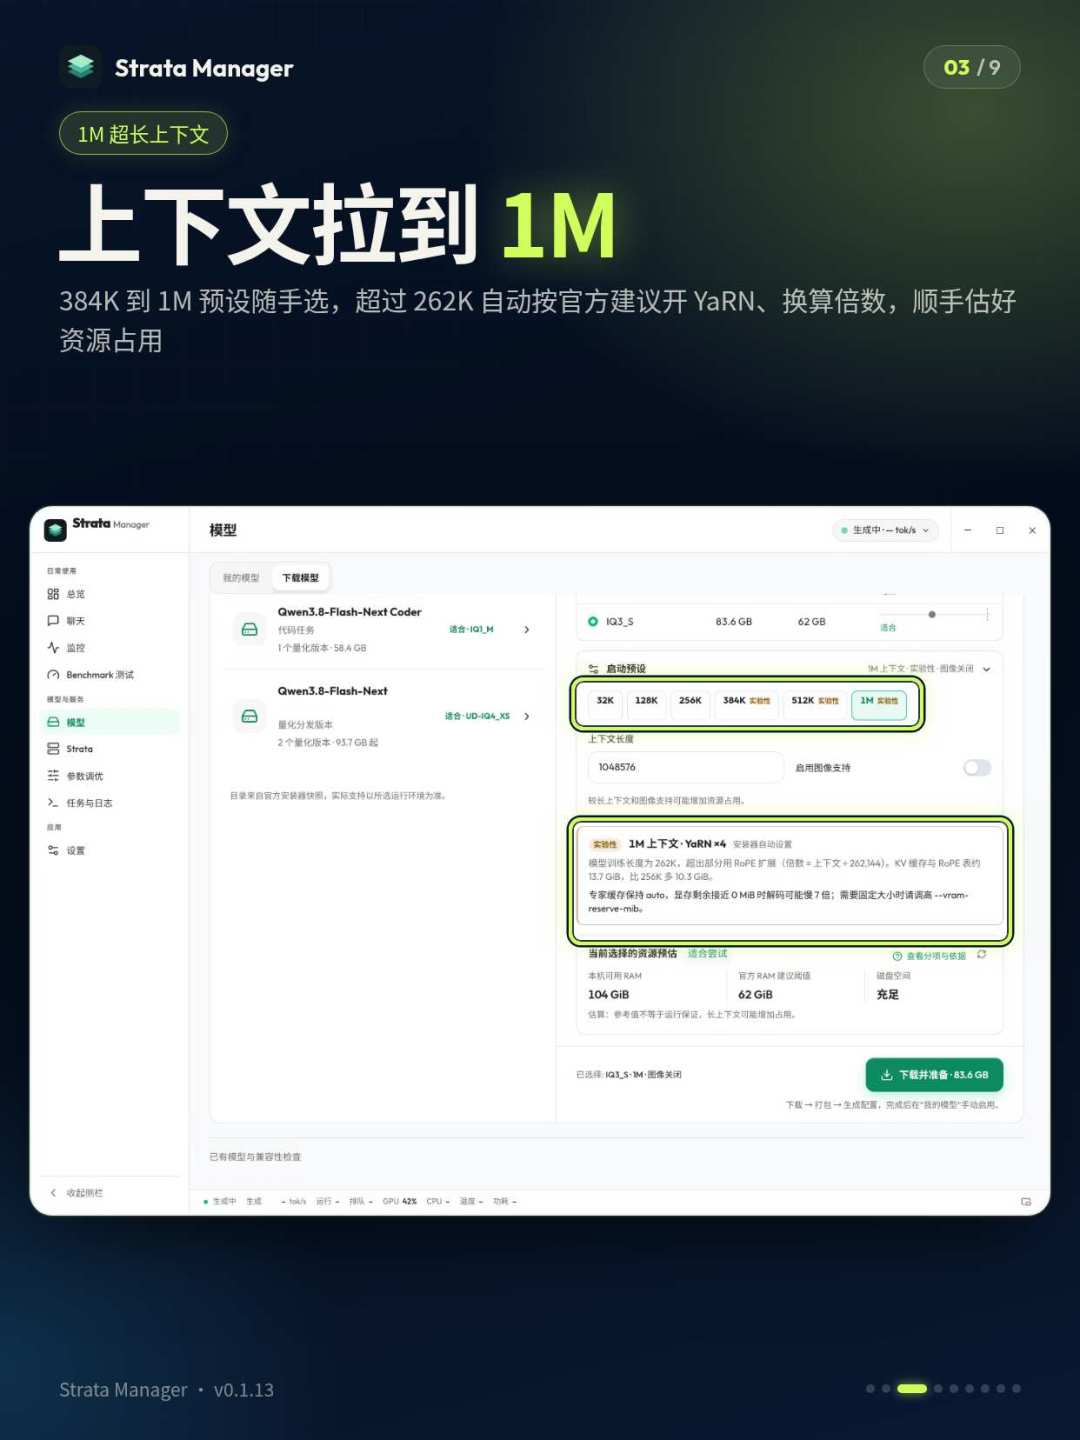
但社区等不了。有博主晒出量化者 Michael Helcig 发布的可在 Strata 里本地运行的 DeepSeek-V4.1-Flash-1017 量化版。小红书
帖子给出的参数相当激进:763B、384 个专家的 MoE,压到约 2 bit 之后宣称 12GB 显卡就能跑。划重点:这是量化者自报的成绩单,IQ2_XXS 版基准均值 93.54、恢复率 100%,真不真得自己验。小红书
速度这块,有人给了硬数据。一位 UP 主花 18 天收集到 141 份 Strata 实测报告、覆盖 45 种显卡。哔哩哔哩
结论相当反直觉:内存总量几乎不决定速度,相关系数只有 0.13;显存才是硬门槛,16GB 升 24GB 是最大的一道坎,速度从 56.8 跳到 98.3 tok/s;双卡只是 1.2~1.8 倍的"救援",第三张卡收益接近零。哔哩哔哩
入门配置照这张表看:GTX1060 6G 约 15~18 tok/s,RX580 8G 约 18~23,RTX3060 12G 约 30,RX7800XT 16G 约 38~44。圈内共识是 40 tok/s 算可用、60 算流畅。至于那个 763B 量化版,发帖人的原话是"现在非顶级配置玩家跑出来的速度很慢,大概只有10t/s以内的速度"。社区的下一个目标,是在 RTX5070 加 64GB 内存上磨出 30~35 tok/s。知乎小红书
第二个战场是算账。有 UP 主把 P100/P40/V100 三张二手特斯拉卡插上计量插座、用同一道 Agent 任务跟官方 API 逐笔对账,甩出"比 API 便宜 17 倍"的标题。哔哩哔哩
但评论区最高赞当场拆台:“量化版api要折价的,哪能这么比”。评论区反而暴露了本地党真正的位置:纠结的已经不是"能不能跑",是"跑多快、值不值"。哔哩哔哩
所以谁该装?
只想尝最新模型的,再等等——首日量化版只有自报成绩,入门卡速度惨烈,代际时差是本地部署的宿命。
冲着隐私、无审查、不限流量来的,现在就能玩——本地从来不是只为省钱。
双 11 准备装机的,别问店员"能不能跑"——只看显存档位,16G 和 24G 是两个世界,内存加再多也救不了显存。
本地大模型的玩法,正在从"能不能拿到门票",变成"拿着门票能跑多远"。