最近知乎上流传的本地大模型用户现状是这样的:“但瞅一眼自己的破烂电脑——显存 8G,内存 32G,硬盘还剩半个 T——也只能作罢,默默点个赞,然后关掉页面”。很长一段时间里,显存就是本地部署的铁律——多大的坑跑多大的模型。但2026年10月,局面变了:12G的游戏显卡能本地跑1250亿参数的大模型,还能直接挂给Claude Code、Codex这类编程智能体干活,知乎、B站两边同时刷屏。知乎哔哩哔哩知乎
 Strata本地跑千亿大模型
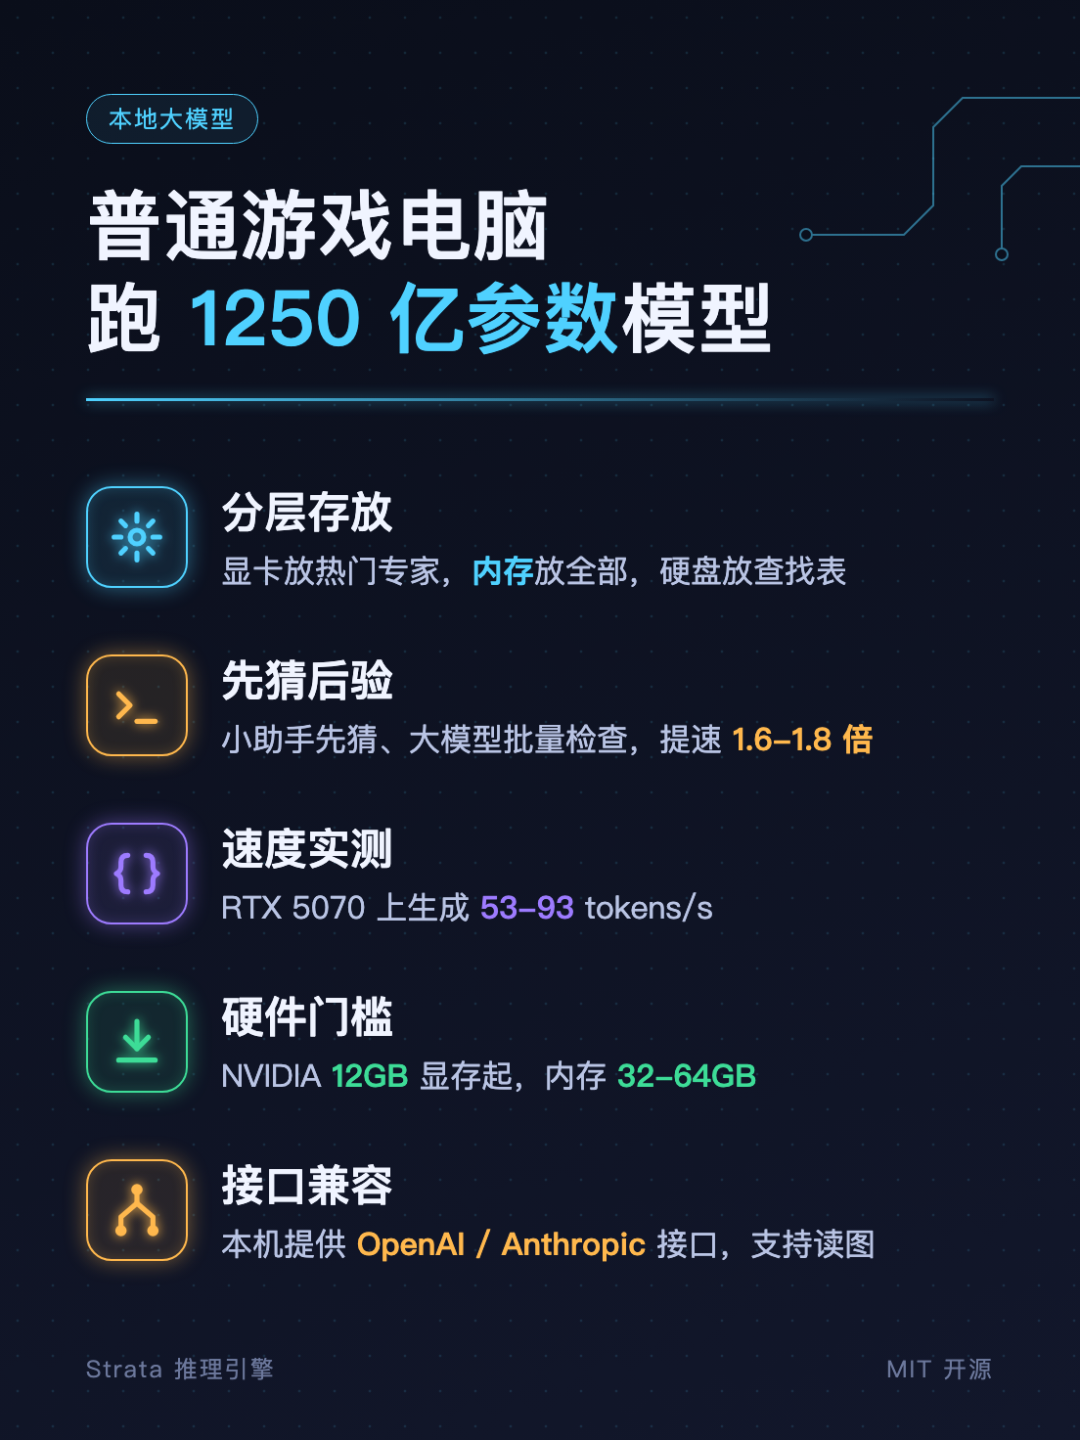
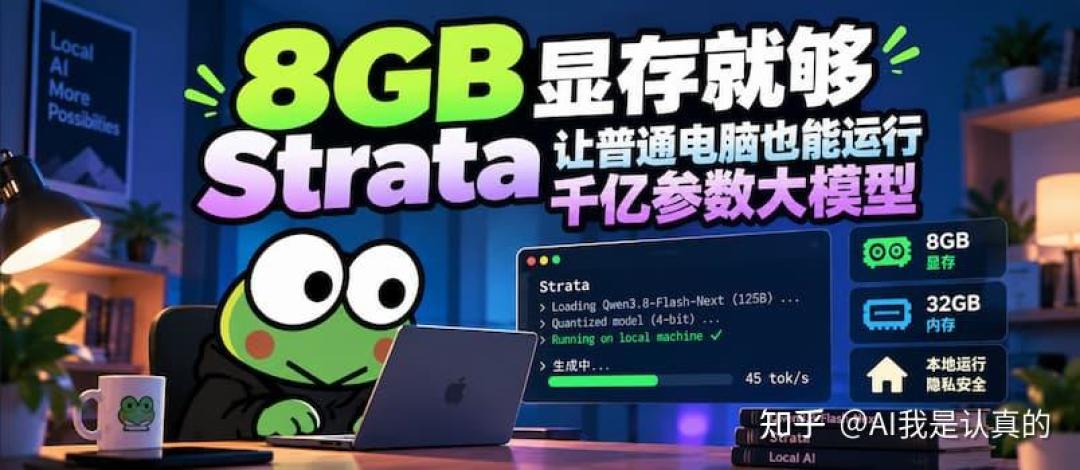
Strata是干嘛的? 原理一句话:把模型拆开分层放——一部分进内存、一部分压到SSD,显存需求直接从几百GB降到8GB。这个MIT开源的项目,10月内在GitHub冲到了约2.6万stars。知乎知乎
 Strata三层存放与实测速度
速度才是卖点。 B站那条21.9万播放的实测视频,12G显卡跑Qwen3.8-Flash-Next峰值到了93 tokens/s。更接地气的是“50元二手CPU E5-2666v3+GTX 1060 6GB+16GB内存”这套垃圾佬配置,实测生成速度能到19-21 tok/s,不是最快,但够用了。哔哩哔哩知乎
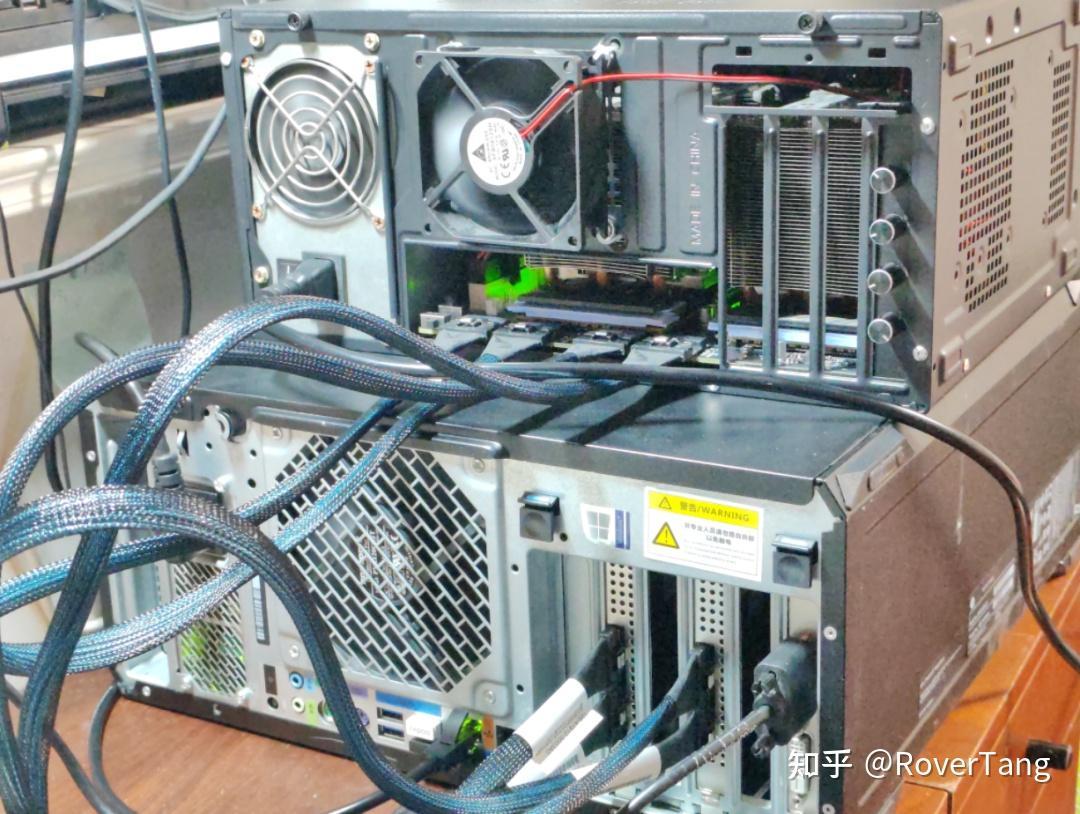 二手服务器平台也能跑千亿模型
先别急着冲,这次门槛搬家了:从显存搬到这三条线。
内存是主线。 项目视频评论区的高赞提醒:“内存又要推高了,这个项目友好64G内存,至少也得48G,32G又尴尬了”。哔哩哔哩
SSD是刚需。 “注意:不要使用机械硬盘,太慢,慢死”。知乎
A卡换条路。 教程作者指了路:“N卡的都在跑Strata,AMD试试gufo”。
量化有折损。 千亿体验建立在激进量化之上,有用户直接开麦:“量化到Q4以下,质量都是严重塌陷,循环断流非常常见,实际没有用处”。指望它平替云端满血模型干硬核活的,会失望。
算的还是那笔账。 这边是“只需要电费,完全不需要任何API费用,并且不限量”的爽感。那边是老玩家的判断:“消费级本地部署大模型进入了一个新的阶段,虽然还是很贵,但真的达到了可用线”。Strata的意义,是让低预算玩家第一次够到了这条线。知乎
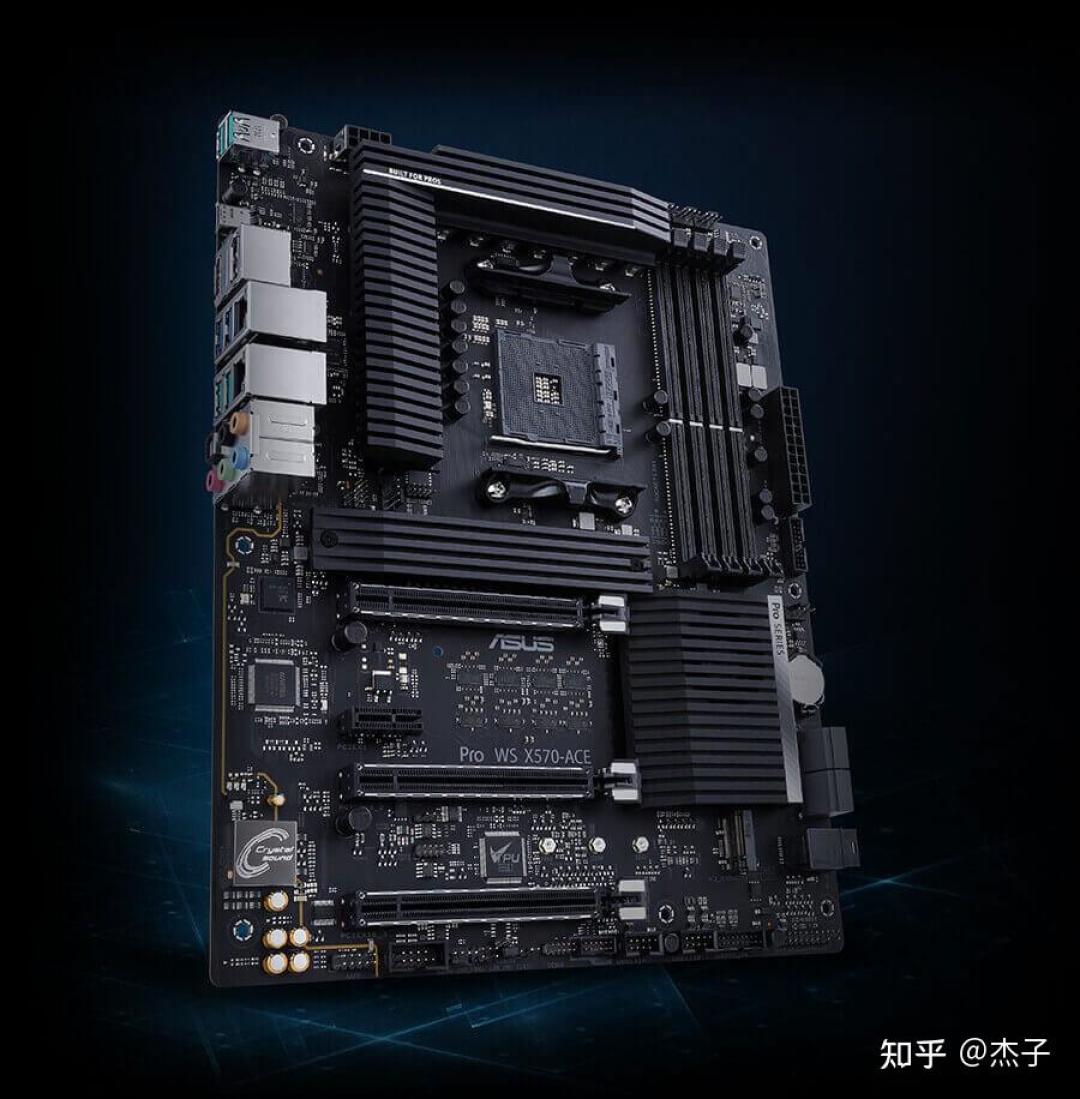 大内存主板成了新门票
结论直给:旧电脑配48-64GB内存、SSD有富余,想要一个7×24在线、数据不出门的本地干活模型——可以冲,硬件可能还是几百块淘的二手;只有32GB内存、或者指望它干硬核活——省钱,继续订阅。
本地AI这件事,被掀翻的从来不是显存,是你冲进去之前的预期管理。