这周「本地部署AI」圈最热闹的,不是哪个新模型开源,而是一场围绕退订的集体实验:把 Claude Code、Codex 这些月费编程 agent 接到自己电脑上的 Ollama、LM Studio,教程标题一个比一个狠——「成本直降99%」「永久免费」「不需要 API KEY」「零 Token、数据不出域」。B站那条《保姆级教程:3步搞定 Claude Code、Codex 接入 LM Studio 本地模型》播放 7935,评论区 54 条;吴恩达 8 月那门《AI Coding Workflows: From Cloud to Local》搬运版播放 6447,连课程大纲都在讲「小模型干粗活,成本速度隐私全权衡」。哔哩哔哩哔哩哔哩
但点开这些教程的评论区,画风完全是另一个故事。我把知乎、B站、微博这几天的实测文、问答和上百条评论翻了一遍,发现翻车姿势高度雷同,而且几乎都能归到同一个机制上。这篇把账算清:本地模型接编程 agent,到底哪笔账算得过来,哪笔算不过来。
评论区的实验结果:一半人在报错,另一半人已经回去了
先看现场。B站那条 7935 播放的接入教程,评论区高频内容是这样的:
「为什么在 LM Studio 里面聊天,上下文开 4096 就行,回复也有 20 token/s,但是接到 Codex 里速度就巨慢,而且打 2 个字就超上下文了」
「LM Studio 里问答速度很快,『你好』2 秒就回复了。但是在 Claude 和 Codex 就得 5、6 分钟左右,Processing prompt 会先花 5 分钟跑满 100%,然后才开始分析我输入的『你好』」
「用的 qwen3.5-9b,在 LM Studio 中能正常使用,但在 Claude 中报错」,附一屏 Jinja 模板异常
「折腾了大半天,算了还是用 deepseek 吧,价格能接受[笑哭]」,楼主回复:「我已经重新用 api 了…[喜极而泣]」
另一条 2758 播放的《LM Studio 本地部署 Qwen3.8-27B 用 Claude Code 编程体验》,评论区同样热闹:「我 5060ti 16g 跑这个……上下文动不动就爆了」「m1max 64g 开 128k 上下文,3 token」。最扎心的是条 6 赞评论:「5090dv2,开 mtp 50 多 token/s,一天跑满 400 万左右,感觉意义不大,目前买了 ds 和 kimi」——顶配硬件、模型跑起来了、速度也够,结论却是回去买订阅。哔哩哔哩
注意,这些人不是不会装。教程跟着走、连接测试通过、模型正常加载——然后在真实 agent 工作流里集体撞墙。这说明问题不在手,在账本身。
第一笔账:上下文账——agent 不是聊天框,每句话都带「开机税」
「LM Studio 里聊天挺好用,一进 agent 就崩」,这是所有翻车报告里最普遍、也最反直觉的一条。原因其实不神秘:你在聊天框里发的是一句话,agent 替你发的是一整个包裹。哔哩哔哩
Claude Code、Codex 这类工具,每次请求都会在你的消息之外自动附上系统提示词、全部工具定义、项目规则文件(AGENTS.md / CLAUDE.md)、会话历史,装了多少 Skills 还会把 Skills 元数据全量注入。B站 9 月 22 日一条 999 播放的实测视频给了个量化数字:用开源工具 skill-context-doctor 体检,开局只说一句「你好」,隐形注入的上下文能吃掉 31K token;瘦身后降到 3K-6K,释放 90%。知乎那篇《AI 编程助手的账单为什么越用越贵》拆 9 天 117.8 元账单,也拆出同一个结论:花钱大头是每次调用新读进去的输入(占 60.1%),「上下文长的杀伤力主要来自它产生的新鲜输入」。哔哩哔哩知乎
这笔税对云端订阅用户是隐形的(包月嘛),对本地用户是三连击:
窗口直接爆。本地模型你一般只敢开 4K-8K 上下文(开大了显存翻倍),31K 的开机税进来,「打 2 个字就超上下文」就是字面意思。
预填(prefill)慢。云端集群处理几万 token 的 prompt 眨眼就完,你的单卡要实打实算几分钟——这就是「一句你好,Processing prompt 跑满 5 分钟」的来源。聊天框 2 秒回复、agent 里 5 分钟起步,差的不是模型,是每次请求前面那几万 token。
并发再翻倍。评论区有人点破:「因为 Claude Code 会并发请求,上下文得翻倍,或者再翻倍」。agent 干活时不止一条请求在飞,主 agent 之外还可能拉起子任务,每条都带全量开机税。
所以第一笔账的结论很硬:决定本地编程体验的不是「模型多少 B」,而是「你的硬件消化开机税的速度」。 这也是为什么视频作者给出的硬件基准线比想象中高——Qwen3.8-27B 接 Claude Code,「建议 NVFP4 精度部署在 5090 32GB VRAM 及以上;4090 24GB VRAM 部署 Q4_M 量化的 Int4 模型,上下文会不太够长」。16G 卡不是不能接,是接了之后每一步都在和上下文搏斗。哔哩哔哩

第二笔账:兼容账——通了不等于能用,报错清单比教程长
教程演示的「3 步搞定」,是从工具作者的机器上走通的。评论区的报错清单则长这样:
500/400 模板错误:Qwen 系模型自带聊天模板里有一段「System message must be at the beginning」的检查,而 agent 发的请求系统消息不在开头,于是 LM Studio 里聊天正常、Claude Code 一连就 500。解法是手动打开模型目录里的 jinja 模板,把那段检查整段删掉——这一步几乎没有教程会写在标题里。知乎
接口协议错位:Codex 走 /responses 端点,LM Studio 只认 /chat/completions,中间靠 CC Switch 转换时 wire_api 配置改不动,报 `tools.9.type invalid_string`。
采样器报错:「Failed to initialize samplers: failed to parse grammar」,而且「有些模型是 500,有些是 400」,换个模型换一种死法。
多模态静默失效:「LM Studio 内可以读图,但是在 agent 里面就不能读取图片了」——不报错,就是瞎。

单看每一条都有解,但叠起来就是那位老哥的「折腾了大半天」。这里要算的其实是时间账:如果你的时薪高于 50 块,一个周末的排障成本已经够付好几个月 DeepSeek 的 API 费用。评论区那两句「还是用 deepseek 吧,价格能接受」「我已经重新用 api 了[喜极而泣]」,就是时间账算完之后的自然结果。哔哩哔哩
第三笔账:钱账——两头人群都省不到,中间地带才存在
支持本地化的文章这周也不少,话术是「订阅费直接归零」「Token 收割术,本地化才是终极解药」。但把几组真实数字摆到一起,会发现「省钱」这个动机在两头都不成立:知乎
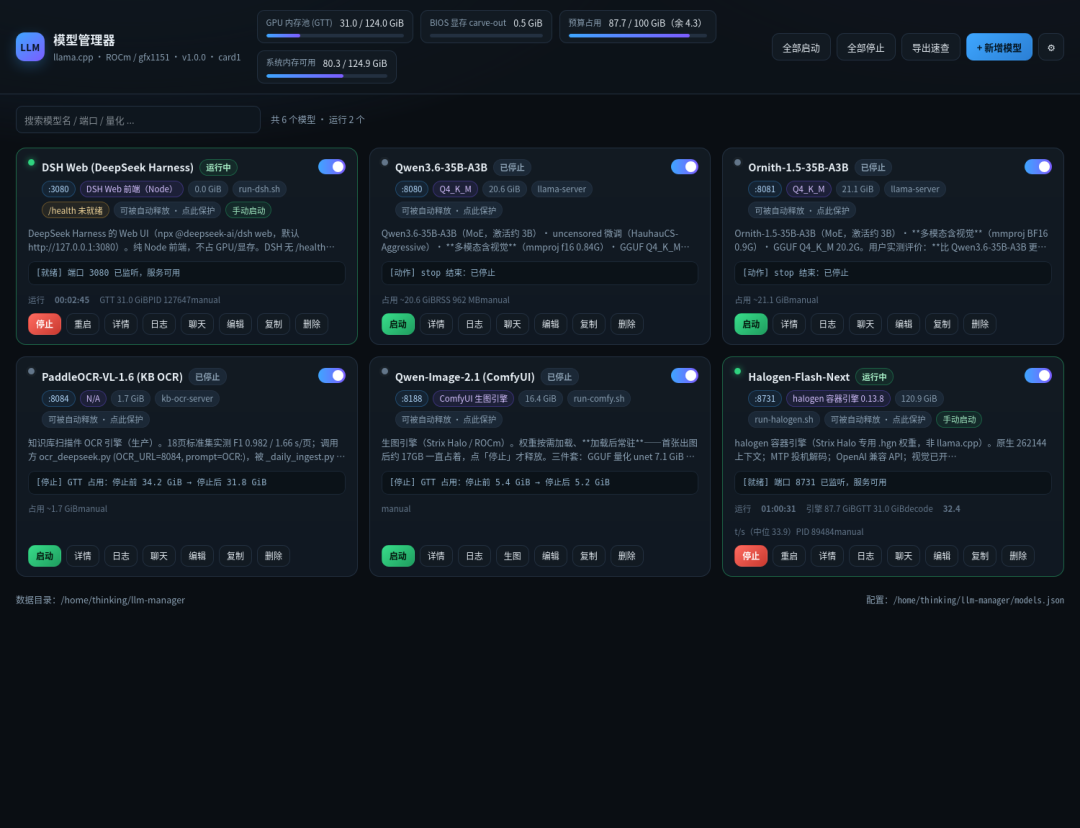
轻用户这头:知乎一位用 Strix Halo(128G 统一内存迷你主机)同时管 5 个模型的作者,在 71 万浏览的实测帖里算了笔账——他过去一年的 API 花费不到 200 元,「按这个数,这台机器要 100 年才回得了本」。他的原话值得抄下来:「如果只为省钱,别买。省钱是副产品,可控才是目的」。知乎
重用户那头:就是上面那位 5090dv2 老哥,一天跑满 400 万 token,最后还是买了 ds 和 kimi 的订阅。原因在账单结构里:知乎那篇拆账文算过,DeepSeek flash 空闲时段输入 1 元/百万 token、缓存读取 0.02 元、周末和夜间全程半价——重度 agent 用户一天几亿 token 的消耗里,九成以上走的是便宜 50 倍的缓存和低至 1 元的输入。云端 API 已经把「量大」这个本地部署最大的卖点,用价格战打掉了。 至于订阅制那头,Codex Plus $20/月、Pro $200/月(周额度实测约 20 亿 token),重度用户算下来单价比 API 还低。知乎知乎
真正存在省钱空间的只有中间地带:用量稳定在中轻度、且机器已经买了的人。电费确实便宜——Strix Halo 实测真实推理功耗 93-100W,按 0.39 元/度的居民电价,满速跑一小时不到 4 分钱级别。但注意前提:卡是现成的。为了退订 $20 去买一张 5090,这笔账怎么都算不平。
第四笔账:质量账——「够用派」和「玩具派」都只对了一半
评论区 9 月还在吵的一个问题:本地 27B 干活到底行不行?两派声音都很硬:
够用派:「大范围重构和改代码肯定有差距,但是小范围执行和改 BUG 和大模型质量基本没啥区别」
玩具派:「27B 改 bug 也完全碰瓷不了主流大参数在线模型,玩具水平,干活用这个那就是跟自己过不去了」
知乎 9 月 24 日一篇按任务类型逐项实测的文章,基本把这场架劝停了——两派说的根本不是同一类活:
任务 | 本地 7B 级表现 | 结论 |
|---|---|---|
行内补全 | 1.5B 模型几百毫秒响应 | 够用,甚至是强项 |
写测试 | 模糊指令下基本要重写;把边界、断言、组织形式写细就能用 | 看你会不会提要求 |
解释代码(单文件) | 答得不错 | 够用 |
跨文件问答 | 「开始编了——给出听起来合理但实际不存在的答案」 | 不够 |
跨文件重构 | 「改了三个文件之后,忘了第一个文件里的改动」 | 别指望 |
海外还有一条对照实测(24GB MacBook 跑免费本地模型 vs $200/月的 Claude Code):15 个任务过了 14 个——但那是拆碎的、单文件粒度的任务。换句话说:本地模型的能力边界不是「能不能编程」,而是「一次要看多少文件」。 玩具派骂的场景和够用派夸的场景,中间隔着一条叫「跨文件推理」的线。哔哩哔哩知乎
所以,谁该退订转本地?
把四笔账合起来,决策其实很清晰:
值得转的两种人:
代码不能出门的:客户代码、内部算法、合规要求明确的场景。这时候本地模型的替代品不是云端,是「什么都不用」。那篇实测文说得实在:「能用上七成能力,比完全靠手写强」。知乎
高频补全型用户:每天大量写样板代码、要行内补全的。配个 1.5B-7B 小模型专职补全(temperature 调到 0.2,稳定性改善最明显),响应几百毫秒,这部分体验真不输云端。
不值得转的三种人:
主力活是跨文件重构、大型 codebase 分析的——本地模型在这块是实打实不行,配了也白配。
只为省 $20 月费、手里没有 32G 级显卡的——先过不了上下文和 prefill 两关,再搭上排障时间,省的钱不够买回来的血压。
一个月用不了几次的——API 按量付费那点钱,远低于折腾环境的时间成本。
大多数人的正确答案是混着来:补全和样板代码走本地,重构和排查走云端,敏感项目无条件本地——现在主流工具都支持自定义 Provider,切换成本很低。另外两个立刻能做的动作:① 不管本地还是云端,先用 skill-context-doctor 这类工具把 Skills 注入瘦下来,31K 的开机税降到 3K,短窗口本地模型才有活路,云端账单也直接变薄;② 接本地模型时上下文开 8K-16K 就好,从 4K 拉到 32K 显存占用能翻倍,编程场景没必要。哔哩哔哩
最后补一个容易忽略的坑:「本地部署」不等于「数据不出本机」。知乎问答里有人提醒,agent 挂了 MCP 工具,哪怕模型是本地的,数据照样可能发出去;也有工具模型能指本地、代码索引却在云端跑——等于白搭。真要私有化,得确认整条链路(模型、索引、遥测)都在本地,Ollama 也别随手监听 0.0.0.0 把服务暴露到局域网。知乎
值得继续盯的信号:Pi / PI-Desktop 这类开源轻量 agent 生态的成熟速度(对本地模型的适配比 CC 更松)、Qwen4 开源后 27B 档的编程能力变化、以及各家 agent 会不会把「开机税」降下来——那才是本地编程真正的解放日。知乎










校验提示文案
校验提示文案