这几天把知乎、B站、微博上GPU并行计算的讨论刷了一遍,有个感受很强烈:写kernel这件事的"唯一正确答案",正在从这代人的经验里被抽走。
9月24日,NVIDIA英伟达中国官方账号发了一篇《介绍 CUDA Rust:用于编写 GPU 内核的两条轨道》,第一次把话说得很白:GPU内核编程从此分两条轨道——SIMT(你指明每个线程干什么,然后发射几千个线程)和 Tile(你说出每块数据干什么,Tile IR 编译器决定剩下的事)。CUDA C++、CUDA Python、Rust,三种语言都只是"轨道上的车",真正的新变量是模型之争。知乎
紧接着的一周里,中文社区像约好了一样集中开吵:9月22日一篇《CUDA与Triton编程模型对比:线程级的自由,块级的契约》被反复转发;同一天知乎问题"CUDA和Triton哪个好用"冒出新的高赞回答;9月21日"triton是否会冲击cuda生态"下面出现了那句被引用最多的话——“冲击肯定有,但说干掉CUDA还早,关键看Triton翻谁的牌子”。 再到9月25日,一篇《AI Infra面试25题(CUDA篇):从归约到FlashAttention》又把"归约、coalescing、shared memory"这些老词拉回视野。知乎知乎专栏
一个官方定调、一轮社区混战、一份面试题单,凑在了一周内。对正在学CUDA、靠kernel吃饭或者准备靠kernel找工作的人来说,这不是瓜,是路标。这篇就把三本账算给你看。

第一本账:省下的到底是代码行数,还是你的硬件知识?
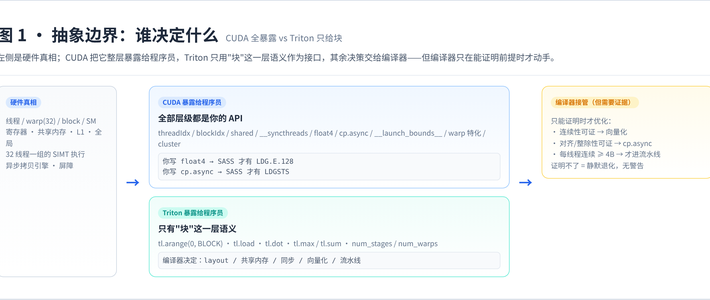
先拆一个传播最广的误读。Arthur那篇对比文里给了一组很抓眼球的数字:同一个fp16 GEMM,CUDA版53行,Triton版20行。 很多人顺手就总结成"Triton代码短、更先进"。知乎专栏
但原文真正值得抄在笔记本上的是后半句:“真正决定性能差异的不是行数,而是谁在替你决定对齐、向量宽度、共享内存布局和流水线级数。” 这就是"线程级的自由、块级的契约"的意思——CUDA把Grid/Block/Warp、bank conflict、合并访存这些硬件细节全部摊在你面前,性能和坑都归你;Triton/cuTile这类块级DSL把这些收进编译器,你交出控制权,换来一个"编译器保证能跑好"的契约。知乎专栏

冯Jungle梳理cuTile执行模型时说得更结构:CUDA的执行模型是Grid-Block-Thread三层,而cuTile kernel面向的是block-scope——每个kernel由"块"来执行,块内怎么分线程、怎么喂Tensor Core,是Tile IR编译器的私事。 NVIDIA官方那篇甚至演示了一个反直觉的细节:Tile轨道下"块是单个逻辑线程,所以没有线程可以去竞争",经典的输出缓冲区读写别名错误,一个被借用检查器拦下(E0502),一个在类型系统里直接不存在(E0382)——两条轨道都在修同一类bug,只是修在不同层。知乎专栏知乎

所以第一本账的结论:Tile不是"更短更容易",是"把一部分人的知识变成编译器的知识"。 前提是你得知道编译器替你决定了什么——这正是第二本账要吵的。
第二本账:三个阵营,谁的真话最多?
把这一周的讨论按阵营摆开,能看出比单篇文章更多的信息。
Triton阵营:基本盘最厚。B站上"先进编译实验室"的Triton算子开发系列,就是带大家从向量加一路写到FlashAttention的。 单个"Triton从入门到大师"视频收藏就有1294。它在PyTorch 2.x编译栈里已经落地,工程团队默认它是"够用就好"的选项。微博高赞回答那句"如果你能问出CUDA和Triton哪个好用,选Triton"虽然扎心,但反映的情绪是真实的:大量用户从来就没写过SIMT,"替代"对他们根本是伪命题。哔哩哔哩知乎
cuTile阵营:NVIDIA的亲儿子,CUDA 13.1引入的块级编程模型。 中文圈第一批下水的人已经出了一手资料——SuSun 6月的cuTile C++实践被赞了81次,自称是"中文的cuTile C++第一份博客"。 这次官方文章进一步给了硬信息:Rust的cutile-rs已经发布在crates.io,而且已经在HuggingFace的Grout推理引擎和mistral.rs这类NVIDIA外部项目里被使用;另一条cuda-oxide路线则还锁在nightly工具链。官方自己的措辞也值得逐字看——“这两个项目都处于早期阶段,尚未就绪生产。覆盖率不完整,API会变动”。 翻译:生态位是真的,但指望它今年接管你的生产kernel是误读。知乎知乎专栏知乎
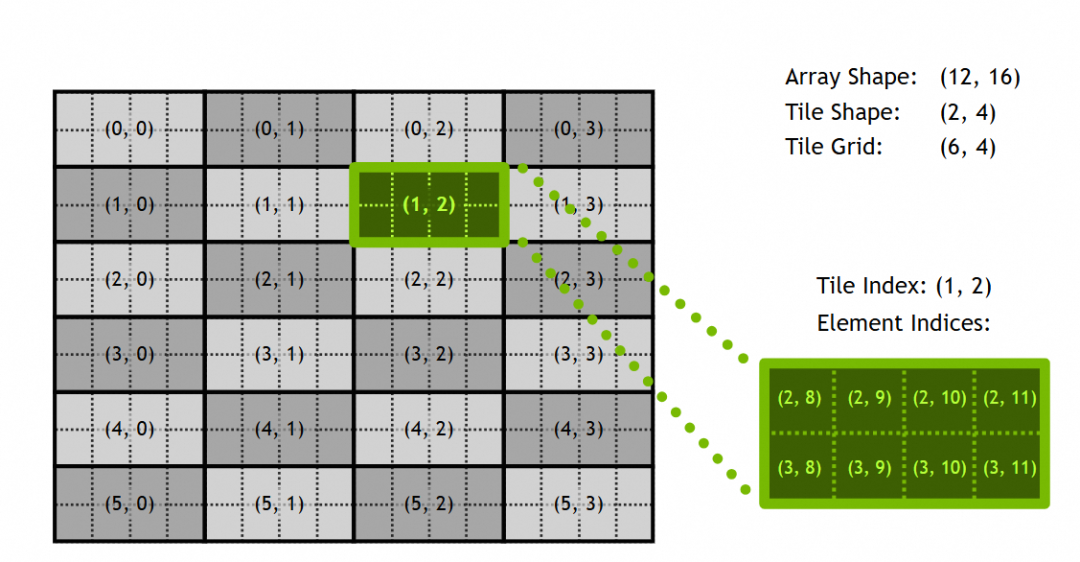
TileLang阵营:最有意思的分歧点在这里。TileLang基于TVM那套编译栈,论文路线(arXiv:2504.17577)主张以tile为核心抽象统一表达多级存储层次,同时保留memory placement、data movement、并行调度的显式元语——比Triton多一层"你还能管"的把手。 8月底知乎已经有人提出"tilelang是不是要把TVM救活了",统计了16个相关开源框架和论文。 8月中还有人把多个TileLang kernel自动融成单个Megakernel,在一张A100上跑通了完整的Qwen3-8B。 这个阵营和社区信号绑定最深:跨厂商、可自建后端——对不想被单一编译器契约锁死的人,这是结构性吸引力。知乎专栏知乎知乎专栏
再叠一层新的焦虑:9月22日微博科技博主宝玉xp转述The Information的消息——OpenAI内部的模型已经能自动化"编写GPU内核代码和优化训练代码",研究人员给一个优化示例,AI自己花几周时间去实现和测试。 写kernel的手艺,上面有编译器抢活,旁边有模型抢活,这才是这一轮讨论热度真正的原因。微博
第三本账:你是谁,时间该怎么重排
三本账合起来,落到不同的人身上是完全不同的动作。

刚入门/求职向(B站"CUDA编程基础入门系列"19910收藏、38万播放,说明这个池子有多大):SIMT的地基不但没塌,反而更值钱了。面试还是从归约、Grid/Block/Warp、coalescing问起——9月25日那份25题CUDA篇就是证据。但要重排顺序:以前是"手写百种reduce变体",现在合理的分配是把省下的重复练习时间换成读一次Triton/cuTile生成的PTX——知道块级契约在底层替你做了什么决定,你就同时有了和两边对话的能力。地基顺序不能倒:没搞懂shared memory为什么会有bank conflict的人,用Tile DSL踩到性能悬崖时是爬不出来的。
在岗算子/推理工程师:判断标准是"你的负载有多长尾"。标准GEMM、attention这类shape规整的活,交给Triton/cuTile的契约是划算的;融合模式怪异、访存pattern特殊的自定义算子,仍然是SIMT的主场——而且这一层的护城河因为"编译器替你决定"成了默认,反而变贵了。SuSun那篇CUDAGraph文章(77赞)已经给这个方向定过调:真正的收益不在省kernel launch,在对执行图的理解——这类"理解层"能力,恰恰不在任何DSL的契约范围内。知乎专栏
在看国产卡/异构生态的:Tile抽象可能是比"CUDA兼容层"更现实的路。TileLang的芯片后端生态、cuTile"源文件不对特定架构编码、编译器决定图块怎么映射到每个架构"的设计,都指向同一件事:块级抽象是跨硬件的最大公约数。这一类人这半年的信号密度(龙芯加速计算平台出首个软件版本、摩尔线程MUSA的具身RL训练曲线对齐国际主流GPU)会持续变大,值得专门跟踪。知乎专栏知乎专栏
最后给三个继续观察的信号
cuTile的API覆盖进度:官方说"尚未就绪生产",什么时候HuggingFace Grout这类外部项目从"尝鲜"变成"默认",是契约可信度的试金石。
自动生成kernel的能力边界:AI能自动写的如果延伸到"中等难度的融合算子",那SIMT手艺人剩下的活会比想象中更尖。
面试题库的措辞:什么时候"CUDA篇25题"里出现"讲一下Triton autotune和手写SIMT的取舍"这种题,就说明行业完成了这次范式定价。
一句话收束:这两条轨道不是新旧两条路,而是同一条路的上半场和下半场——SIMT负责让你知道发生了什么,Tile负责让你少干重复劳动。先学会哪条都不亏,但把"编译器替你做的决定"当成黑盒的人,会在下一次性能排查时连本带利还回去。