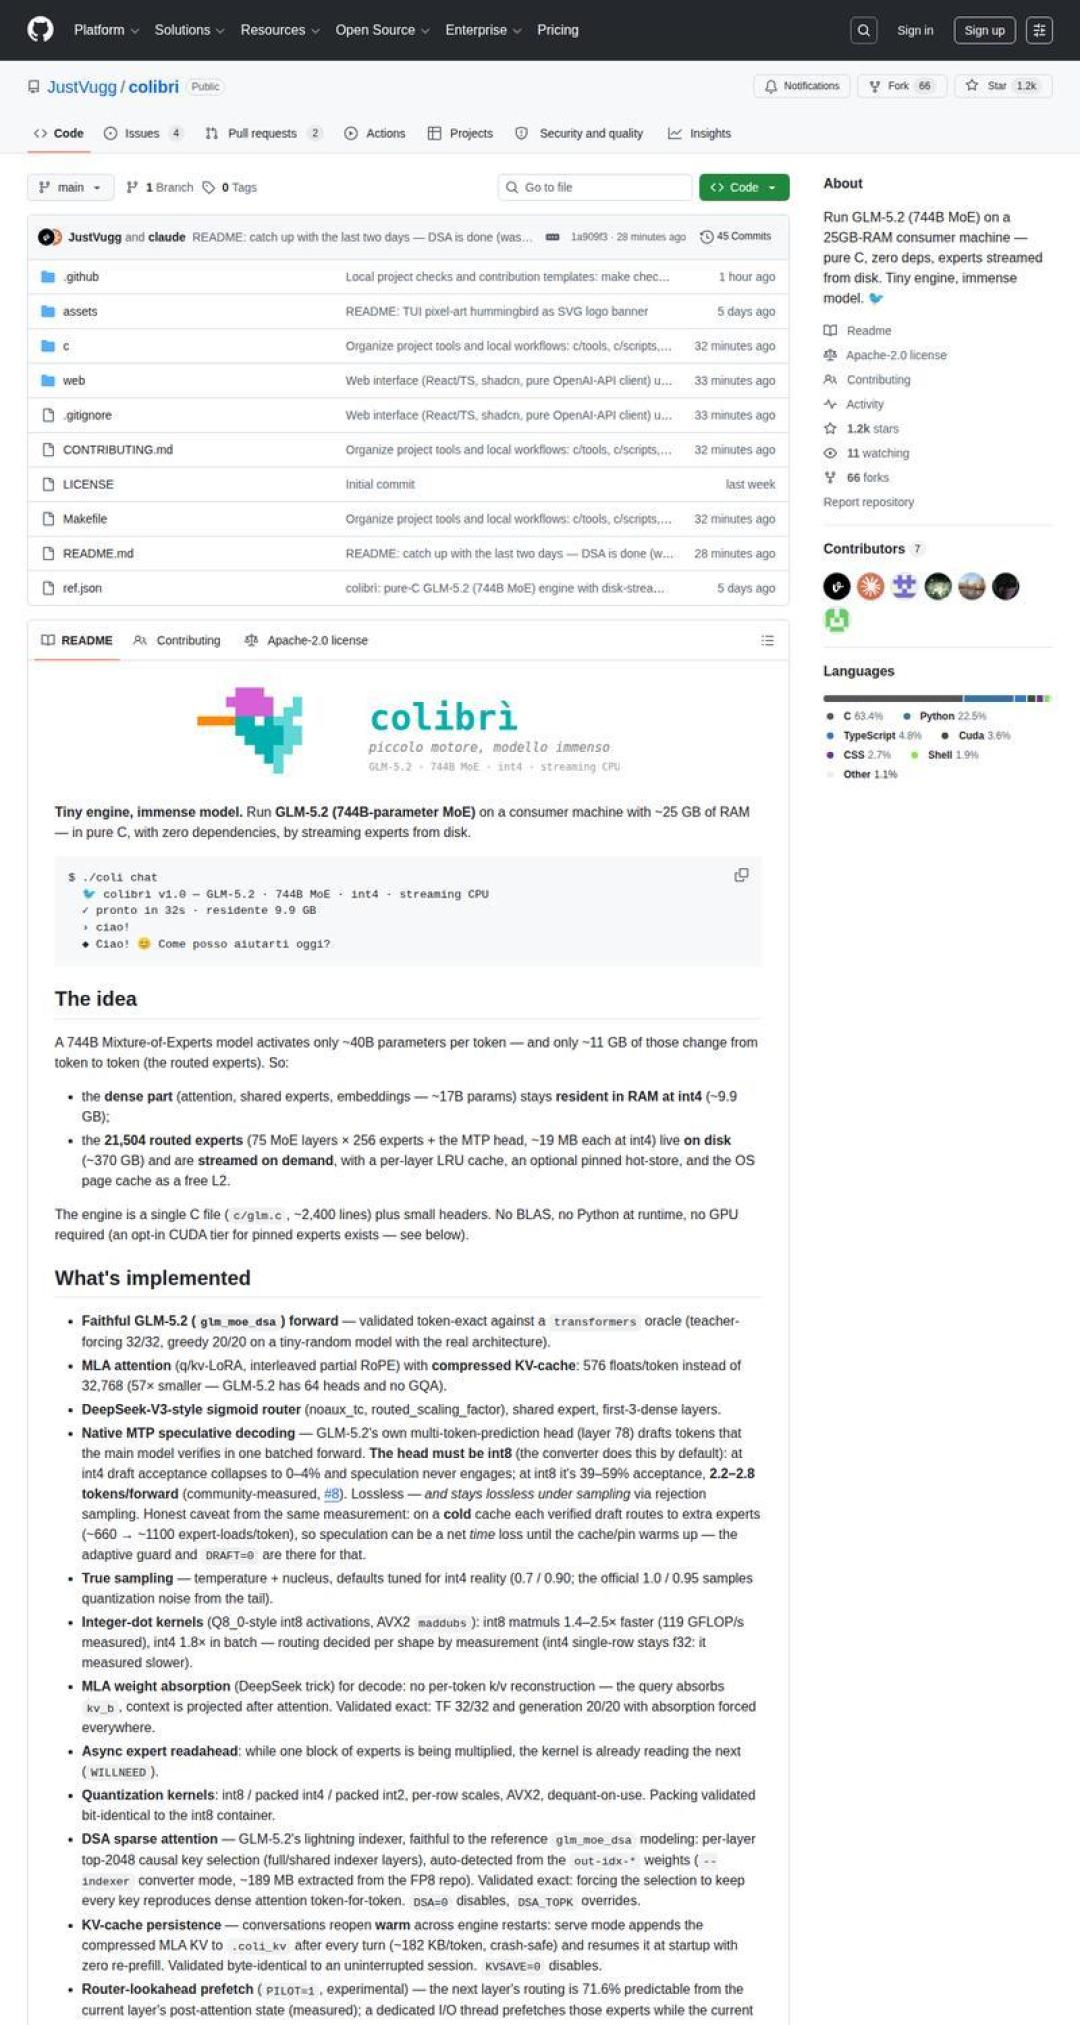
今天打开 GitHub 趋势榜,日榜第一不是什么 AI 套壳应用,而是一个和你硬盘直接挂钩的项目:colibri(意大利语「蜂鸟」)。项目名片上 31,772 颗星,纯 C 写的推理引擎,零依赖、几百 KB,今天冲上 Trending 日榜第一(+2,233 星)。 它干的事一句话就能说清——把 NVMe 硬盘当显存用,在一台 25GB 内存的笔记本上跑 744B 参数的 GLM-5.2。知乎
如果你这段时间一直在盯硬盘价格、纠结要不要补一块大容量固态,这件事值得花十分钟弄明白:它短期内改变不了你的使用体验,但可能改变「硬盘」这个品类在电脑里的定位。我把项目实测数字、B站评论区的冷水、知乎反方观点和九月固态实价对了一遍,下面是结论。
一、它干的事:让 19456 个「专家」睡在硬盘里
先说原理,尽量说人话。GLM-5.2 这种 MoE(混合专家)模型,744B 总参数里每个 token 真正激活的只有约 400 亿,占比 5% 左右;剩下 19,456 个路由专家,绝大多数时间都在睡觉。 传统推理框架的思路是「全部装进显存,装不下就报错」,colibri 反过来问:既然大部分权重用不上,为什么一次性装进去?知乎
它的做法是分三层放:稠密部分(约 17B)以 int4 常驻内存,只占 9.9GB;19,456 个路由专家(约 370GB)留在 NVMe 上,用到谁读谁,再配逐层 LRU 缓存、学习型热门固定区和提前一层预取——显存不够用内存顶,内存不够就让专家躺在硬盘里随用随读。 换句话说,在它眼里 VRAM、RAM、NVMe 是同一套推理层级,专家放在哪一层,只决定你等多久。知乎
它还立了一条很硬的规矩:「放置只决定速度,不改变语义」。作者原话是「高速内存不足可以降低速度,但绝不能悄悄重新定义模型」——不管专家从显存还是硬盘响应,输出一个字都不能变。 这条规矩,是整个项目被技术圈夸的根本原因。知乎
二、先泼冷水:一秒半个字,是它自己写在首页的
有意思的恰恰是它的诚实。性能表最底下躺着一行数字:普通配置每秒 0.05 到 0.1 个 token,旁边写着「本项目出发的地方,也是诚实的基线」,翻译过来就是冷启动一秒出半个字、一个字要等十几秒。 纯 CPU 热缓存状态也只有 1.8 tok/s,离「流畅聊天」差得远。 从 0.05 到 1.8 之间隔着的,就是硬盘的物理速度。知乎知乎
B站评论区的态度更直白。七月那条 3461 播放的讲解视频下,点赞最高的评论是「0.1token的速度完全不具备实用性」(20 赞),还有人补刀「部署了,很慢,别折腾」。 冷启动的煎熬之外,还有人认真算过一笔电费账。哔哩哔哩
这位用户每天消耗约 2 亿 token,按别人实测每秒 1 token 算,要连续跑 2314 天、合计 6.3 年,250W 的电脑要吃掉约 13800 度电,他的结论是「电费都比买tokens贵了吧」。 不过这条评论的下半句是「设计可以」——速度归速度,思路本身是被人认可的。哔哩哔哩
还有一个细节值得玩味:官方支持双 SSD 分流读取,两块盘按带宽权重路由,9+3 GB/s 的组合实测快约 33%——在这套架构里,硬盘读带宽直接兑换推理速度,这是「硬盘当显存」字面意义上成立的部分。 评论区也有懂行的指出,这套办法「比较适合Qwen3 next 80B A3B这种极为稀疏的MoE」。 硬盘的带宽规格,第一次被直接写进了推理性能的公式里。知乎哔哩哔哩
那它到底适合谁?知乎那篇「打假未遂」的评测给了清晰的三分法:llama.cpp 求装得下,kTransformers 求跑得动,colibri 求不掺假。 想真正摸透大模型怎么选专家的人、存不了敏感数据上云的人、手里有闲置服务器或旧工作站的人,是它的主场;想日常干活聊天的,云端 API 或者买张好显卡跑量化版都更省心。知乎
三、这不是孤例:英伟达在押注同一条路
把时间往回拨一个月,今年 8 月初,科技媒体援引 siliconangle 的博文称,英伟达正在研发让 SSD 充当额外显存的新技术,未来可以在游戏或者 AI 场景下改善运行表现。 技术内核是 GPU 直连存储:传统流程数据要走 SSD→CPU 系统内存→GPU 显存两次拷贝中转,GDS 技术绕过 CPU 和主内存,让 SSD 数据经 PCIe 通道直接进 GPU。 微博上这条话题的热帖拿了 582 赞 92 评,有人给出了关键数字,「速度是CPU模式的5.3倍,成本降低21.7倍」,并判断英伟达不是在做一个技术实验,而是在重新定义「什么算显存」。 这两个数字,就是「存储层级上移」最直白的注脚。IT之家微博微博
反方声音同样值得记下来。有人提醒这技术「只是兜底防闪退,没法提升显卡本身性能」,高端原生大显存依旧是刚需。 知乎上的技术派更直接:「SSD的随机读写不如内存,内存的随机读写不如显存。研究SSD代替显存的价值,还不如研究新一代傲腾持久内存」。 这是技术派对它泼的最清醒的一盆冷水。微博知乎
一个开源项目和一个芯片巨头,一个月内先后把「硬盘当显存」推到台前。方向未必如宣传那么性感,但趋势本身是真的:存储正在从「仓库」变成「工位」,硬盘的读带宽和随机性能,开始参与计算,而不只是存文件。
四、对买盘的人:三本账
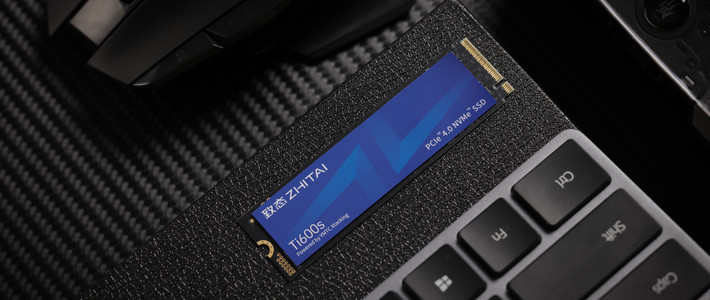
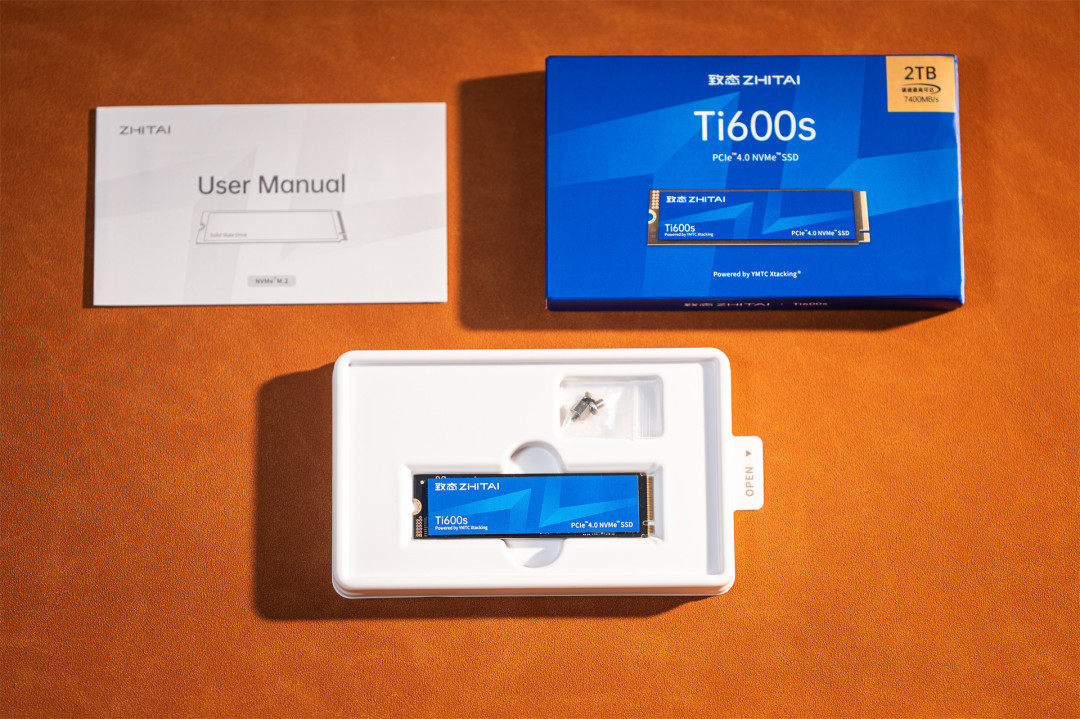
第一本,成本账——colibri 的本质是「用最便宜的层,装最大的部分」。 按今年 8 月的实价,4TB NVMe 固态约 3700~3900 元,致态 Ti600s 4TB 发售价 3889 元,顺序读 7400MB/s、随机读 1300K IOPS,折合约 0.93~0.97 元/GB。 内存条按年初账面价 32GB 约 1899 元,约 59 元/GB,比固态贵 60 倍;显存还得再贵上一个量级——英伟达那个「成本降低 21.7 倍」的口径,指的正是用 SSD 层替代显存层装冷数据。370GB 的专家权重放 NVMe 上,NAND 成本三百多块钱的量级;全塞显存,就是另一个世界的故事了。微博微博
第二本,尝鲜账——真想玩,先看门槛清单,再看你手头的盘。 硬件要求看起来像开玩笑:不要顶级显卡,要的是内存 16GB 起(GLM-5.2 的稠密部分常驻 9.9GB)、一块大容量快固态——完整跑通 GLM-5.2 需要约 372GB 空闲磁盘,Kimi K3 更是要 1.6TB。 这份门槛清单,和很多人想象的「换张显卡」完全是两个方向。知乎知乎
建议别上来就冲 744B,从 OLMoE(7GB)或 Qwen3.6(20GB)起步,半小时能跑通全流程。 选盘逻辑和装系统盘不一样:这套场景吃的是持续读带宽和高队列深度随机读,所以带独立 DRAM 缓存、TLC、双 M.2 插槽的机器会更占便宜,QLC 丐版和无缓存盘体验会打折;好消息是专家权重以读为主,TBW 焦虑可以放一放——硬盘寿命的账,这次不站在你的对立面。知乎
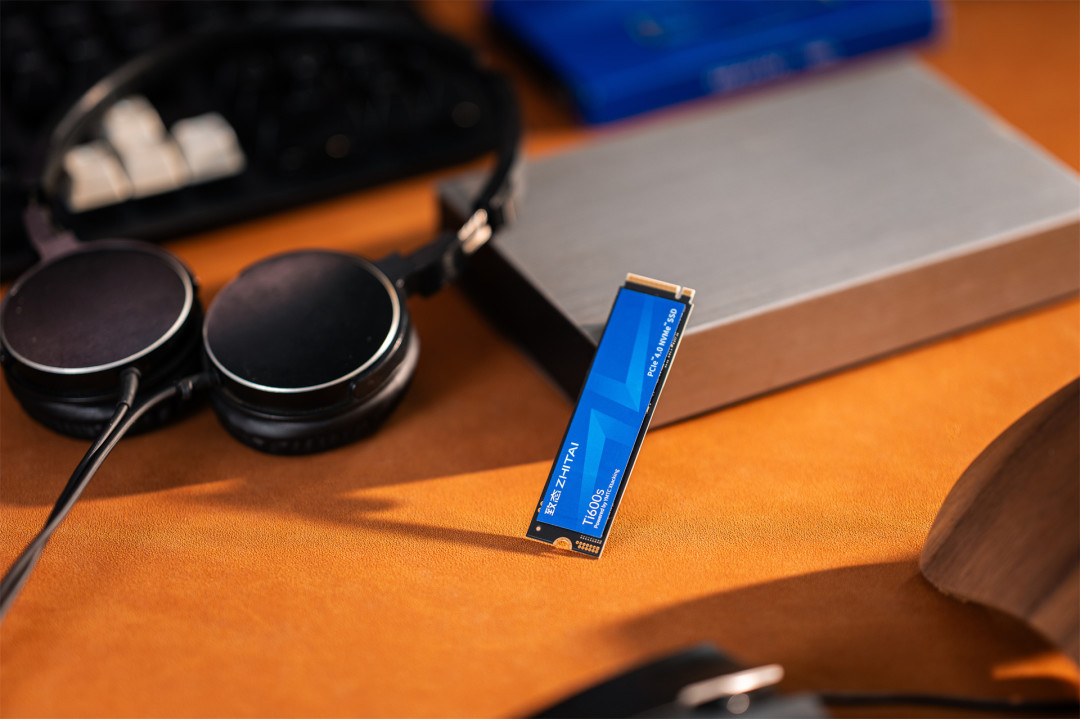
第三本,时机账——九月的盘价,不支持你为尝鲜专门买盘。 现在 1TB NVMe 在 1000 元上下、2TB 约 1800 元、4TB 约 3700 元。 更魔幻的是二手市场,PChome 的 CEO 自曝早年 2000 元买的三星 4TB,如今市价飙到 5000 元,「二手平台上架一分钟就被拍走」。 机械盘同样连涨 6 个季度,8TB 希捷零售价已超 2850 元。 整条存储货架,现在没有一处便宜的地方。微博微天下快科技
为一秒半个字的尝鲜体验专门花近四千块,怎么算都不值;手头有闲置大容量 NVMe 的,折腾成本约等于零,值得一玩。至于等等党,知乎上吵成了两派。一派按历史规律外推,估计 2028 年回落、2029~2030 年再见低点。 另一派认为年内别指望,产能都给三星、海力士、镁光分完了,主要产能都往高端 HBM 去了。 两派唯一的共识是,短期别指望。知乎知乎
五、接下来盯这三个信号
第一,colibri 的迭代速度:最新版本 v1.11.0 的更新停在 9 月 13 日,看它能不能把预取命中率和热缓存吞吐再抬一档。第二,英伟达那套 GPU 直连 SSD 会不会真的进游戏本和 AI PC——那才是 SSD 随机读性能变成刚需、现货价再获支撑的时刻。第三,9~10 月固态现货价,7 月 1TB 涨至 950 元、8 月站上 1000 元的行情有没有松动。 这三个信号里,任何一个落地,都够硬盘行情再抖一次。微博
一句话收束:colibri 把「超大模型能不能塞进家用电脑」从不可能变成了慢但可行,这个「慢」是硬盘物理速度决定的,连作者都不藏。对存储玩家来说,真正的变化不是今天要买什么盘,而是从今天起,硬盘的规格表上,「读带宽」这一栏多了一个全新的用途。
你会为了「数据完全不出本机」接受每秒一两个字的速度吗?你手头那块闲置的大容量固态,打算试试吗?评论区聊聊你的底线和配置。











我想天天看大海
校验提示文案
我想天天看大海
校验提示文案