过去一个月,本地部署圈的热闹全在算显卡账:27B要多少显存、8G能不能跑、统一内存又涨了多少。这周把话题掀起来的,却是一个根本用不上显卡的东西——不能聊天、不会写文案、只会做选择题、判断题和打分题的模型。
9月15日,TypeSafe AI发布Jev,官方叫它「System One决策模型」:喂给它一段情况加几个预先定义好的选项,它一个字不生成,一次性返回「选哪个、打几分、是不是」和对应概率。 9月21日它取消排队、全员开放,新注册用户送5美元额度(约合1.2亿输入token),结果需求太猛,9月22日就暂停了新注册——上线7天,关上了大门。微博微博小红书
而就在这7天里,开源社区甩出了Laya:4.2亿参数、pip一条命令装好、CPU跑毫秒级出结果、GitHub上线三天就冲了4000星,9月22日已经超过1.56万星。 第一批装上的人,已经开始把自家Agent的「小判断」喂给CPU了。这篇文章就替这类人算三件事:这波到底是什么、账划不划算、哪些活儿现在能交、哪些还不能。哔哩哔哩
一、它为什么会火:大模型最贵的工作,原来是「选一个选项」
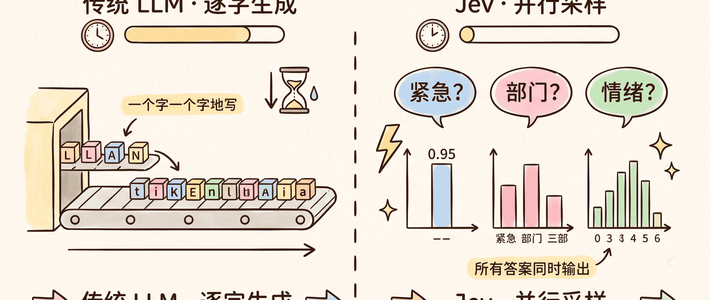
如果你已经在跑Agent工作流,这个痛你一定见过:让大模型「选工具」,它要先逐字吐出一整段JSON——左括号、引号、工具名、冒号、0或1,这些字符全是output token,一个都不便宜,还得等它一个字一个字写完。而工单分派、报警要不要升级、这句话算不算违规注入、任务完成没有——这类判断根本不需要「思考」,需要的是快和便宜。
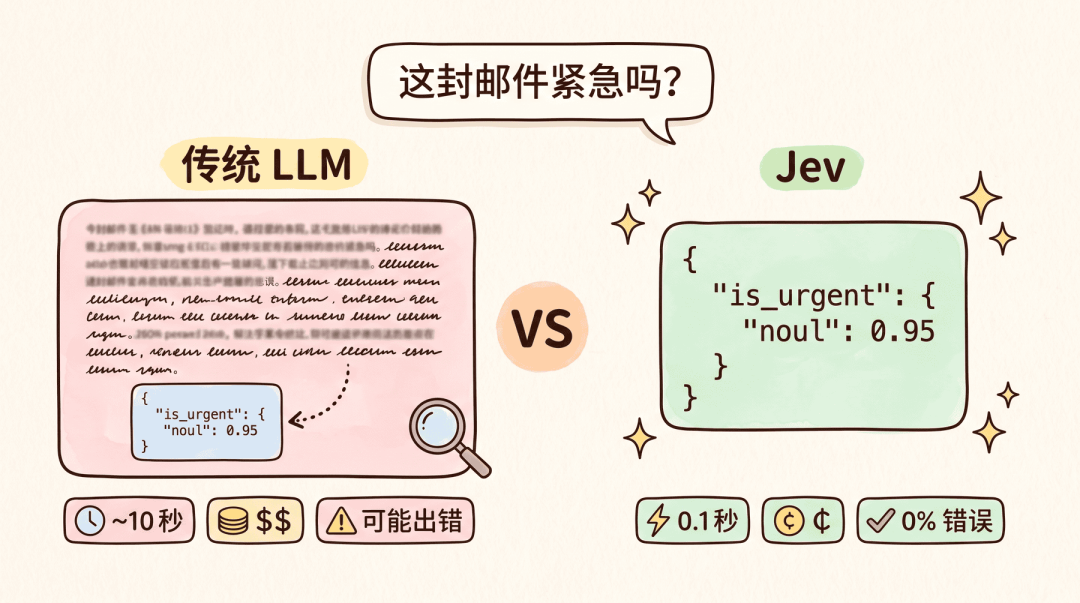
Jev就是把这一层单独拎出来的模型:不输出文本,从数学上不可能生成你选项之外的东西。网传的数字是单次请求最快70ms、输入每百万token约0.042美元、输出永久免费。微博
网友搭的JevBench拿它和中档开源模型Qwen3-30B-A3B做了对比:准确率上两者差距不大,部分子项Jev甚至还反超。知乎
速度和成本才是拉开差距的地方:Jev回复每个Query平均0.3秒左右,LLM生成一份结构化输出要几秒到十几秒;更夸张的是成本对比。知乎
跑完同一批测试,Jev账户只扣了约2美分,已经很便宜的Qwen3花了将近5块人民币——结论很扎心:智能上它没有吊打谁,赢的全部是速度和成本,而这恰好是Agent里被调用次数最多的那类工作。知乎
二、Laya这波:本地部署的入门墙,第一次不是显卡
过去本地部署的判断链是「显存→显卡→预算→涨价潮」,27B模型把无数人拦在墙外。Laya把这条链整个换掉了:421M参数、权重全公开、确认Apache-2.0协议(不少视频里传的是「MIT」,商用前以GitHub仓库为准),pip安装,Mac上1G内存级别占用,CPU就能跑。实测在M1 Pro 16GB笔记本上单次决策约69毫秒——入门条件从「你有一张什么卡」变成了「你会不会装Python」。哔哩哔哩
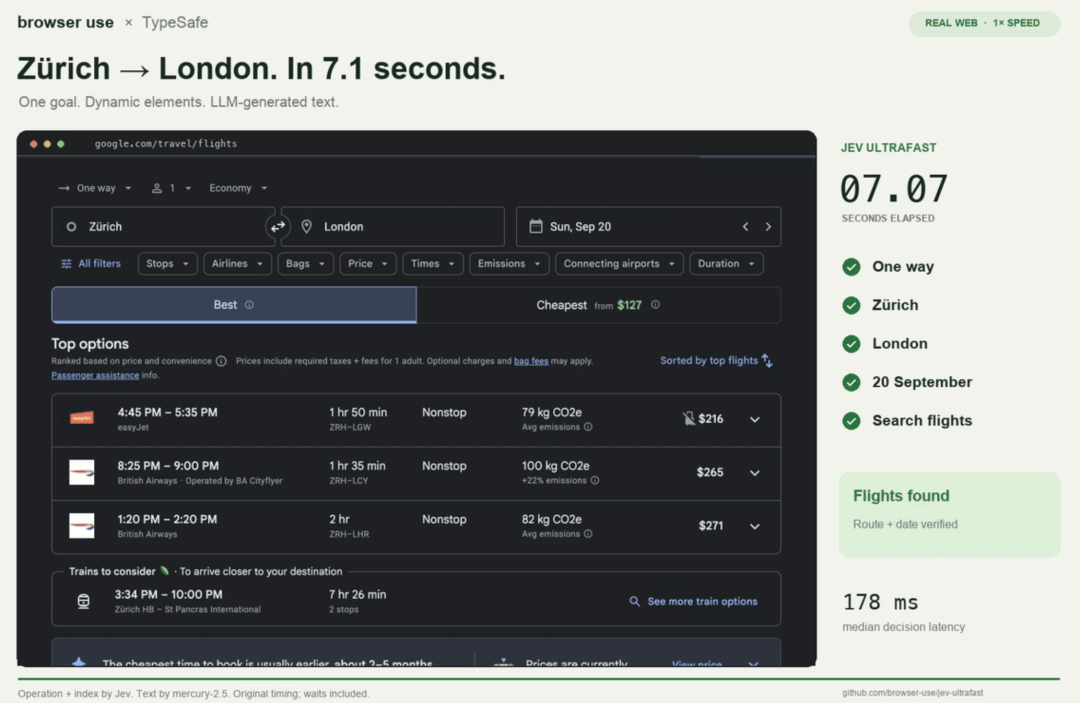
生态速度更夸张:发布后24小时里冒出一批自称替代Jev的开源项目(多语言版、laya-mlx、带视觉的VisionLaya、能把任意HuggingFace模型套上决策接口的LLM2Jev、打分更准但速度慢一截的Decider),有人拿Java+ONNX跑扫雷,有人拿它跑浏览器自动化实测——查航班这种多步操作,全程7秒多、只花0.4美分。 对家里常年挂着Ollama跑主模型的人,这相当于给常驻机器加挂一个几乎不吃资源的「判断小工」,把重复杂活从大模型身上摘下来。哔哩哔哩
三、矛盾全在数字里:官方榜、独立测、中文实测,三张结果都不一样
这是AI替你筛掉的最大的噪音源——这波宣传数字水分不小,但错误分布比总分有用得多。
官方2000题对比:Laya 76.6%,高于Jev的72.7%。听着像「平替反超」。哔哩哔哩
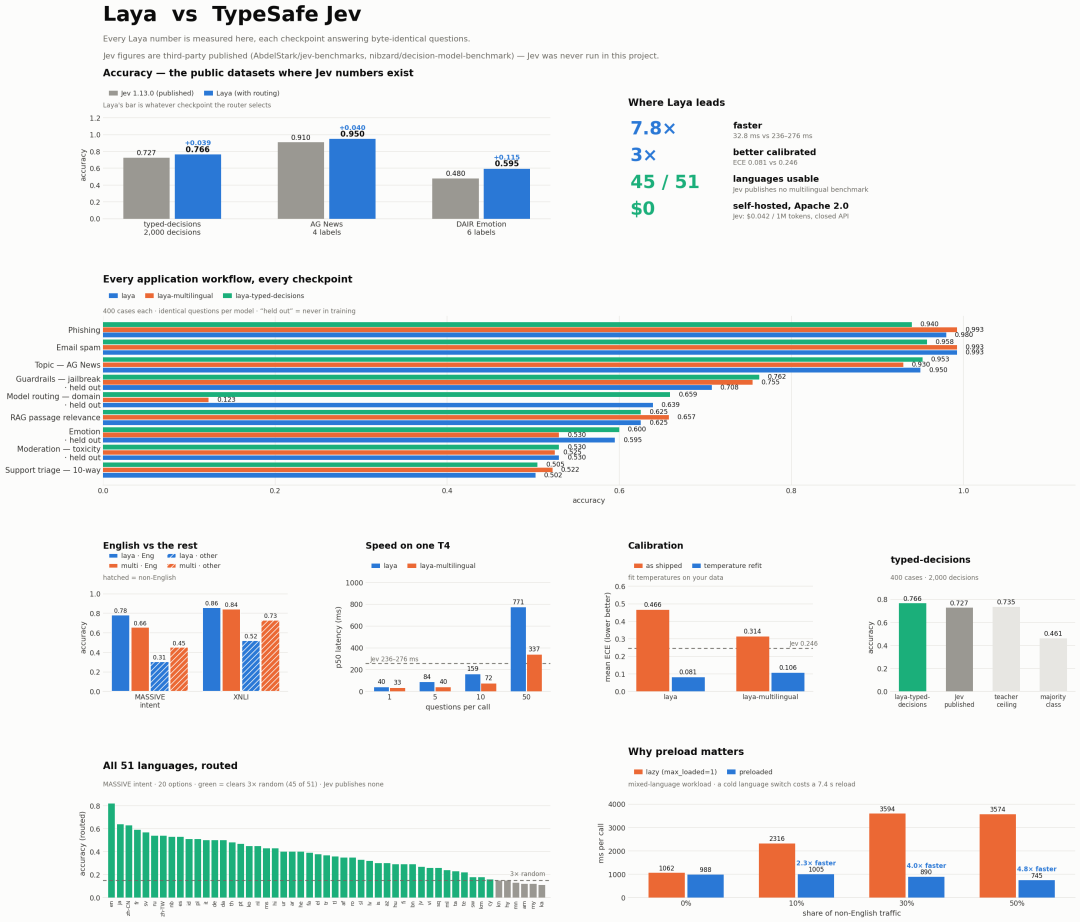
但这张Laya官网的对比图顶部自己标了一行小字:Jev一侧的数字引自第三方公开发布的结果,Jev并未在本项目中运行——也就是说,76.6对72.7是「我测的我」对「别人测的他」。看「反超」类标题,先审谁测的、什么口径,这就是第一个例子。
独立测评随即泼冷水:有人用32个海龟汤故事、1532次判断做PK,追问换一套题结果是否还和官方对比表一致。 也有博主汇总称,Laya宣称反超,独立实测却排了最后。 「快20倍」「快200倍」这类标题更要做算术题:有人的玩笑实现号称0.172毫秒、是Jev最快记录(70ms)的400倍——只要把网络往返和统计口径换个算法,谁都能宣布碾压谁。哔哩哔哩哔哩哔哩微博
真正有颗粒度的是一份中文实测:30条客服工单,每条问3题(分哪个部门、是否紧急、客户情绪打分),共90个判断。结果是——
任务 | Laya多语言版 | Decider |
|---|---|---|
部门分派(4选1) | 29/30 | 30/30 |
是否紧急 | 27/30 | 29/30 |
情绪打分(0–2) | 11/30 | 19/30 |
单次耗时 | 69ms | 1234ms |
分类、选择类任务基本能打平甚至更好;打分类任务Laya直接崩,分数全挤在中间;英文版跑中文分部门只有23/30,中文场景一定用多语言版。 更有信息量的是错法:带「盗刷」「异地登录」关键词的,紧急度给到0.98、0.99;「升级之后数据全没了!!赶紧给我恢复!」只给0.42,「合同明天走审批、今天能发报价单吗」只给0.14——藏在时间词里的紧急,它经常看不出来。小红书
一句话划边界:可枚举、选项清晰、高频重复的分类/路由/是否题,现在就能交给它;打分题(情绪、质量、风险档位)别急着交,时间语义里的隐性紧急要留兜底规则。
四、上车前四个坑
「零幻觉」不等于「判断准」。它只保证答案不超出你给的选项,不等于判断准——选项设得不合理,它的正确率就是选项设计的正确率。 这是分类器的老规矩,不是新魔法。小红书
Jev是云API,每次判断都在把数据送出家门。很多人为了隐私才做本地部署,接闭源云API等于把判断数据送出家门,恰好和初衷相反;隐私敏感的判断数据,只有Laya这类本地路线可走。
定位错配最费钱。它不能聊天、不能开放生成,岗位在Agent流水线里跟主力大模型并排挂:大模型管生成,它管每一步的路由、打分、终审。 冲着「更便宜的小大模型」去的,会把它装成吃灰摆件——这一个月吃灰复盘里,同类案例不少。
技术壁垒别高估。HN上有人开怼「这套东西我一年前就做了」,还有人的复现版放话「他们秘密研发两年,我秘密研发两小时」。 方向是真的,但护城河可能很浅——也有博主提醒:如果不赶紧学会用法,这个能力很快会被新一代模型内化,囤账号不如学分工。微博
五、谁现在就装、谁再等等、谁别碰
现在就装:已经在跑Agent或自动化流程、判断任务高频且可枚举(路由、意图识别、是否报警、完成度检查)、数据不想出门、手边有台能开机的电脑。装完先用你自己的数据测——做实测的博主原话是「上线前务必用自己的数据再测」,别拿2000题当你的成绩单;接云端决策API的话,控制台的花费明细要养成每天瞄一眼的习惯,跑一轮基准的账单和token量都在那里,一目了然。小红书
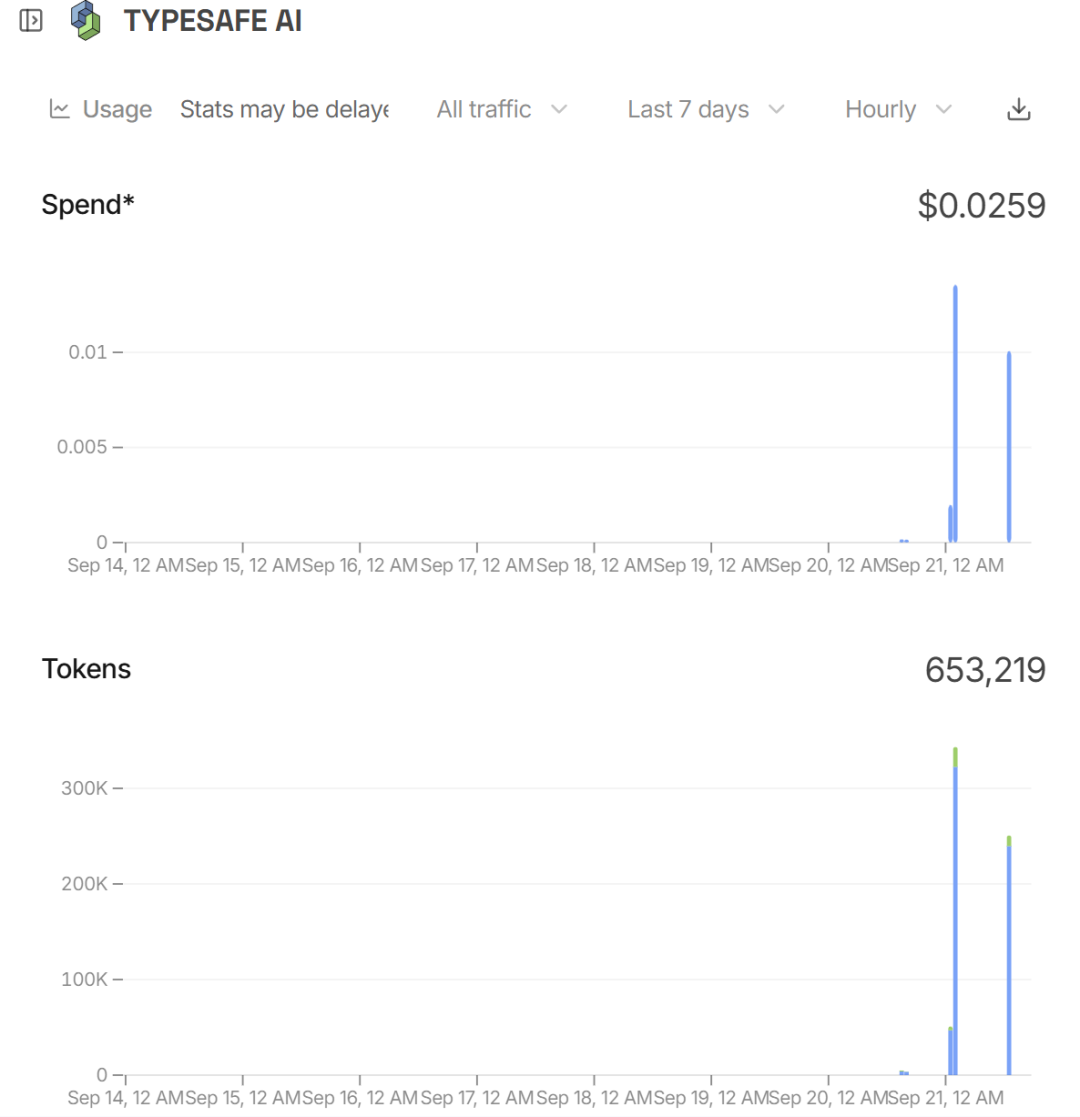
再等等:想拿情绪/质量/风险打分开生产的人,等Laya打分能力或Decider类速度优化,也等Jev恢复注册后的中文对照实测;以及等官方技术报告出来,再看它到底怎么练的。
别装:一个自动化流程都没有、就想找「能陪聊的本地模型」的人——它一个字都不会回你。
值得继续盯的信号:海龟汤PK和那批社区实战案例会不会收敛出稳定结论;「分类能打、打分拉胯」这条边界在第三套数据里是否还成立;Jev何时重开注册。
带走的一句话
这波真正的变化不是「又出了个神模型」,而是Agent工作流第一次进入精细化算账期:不是所有需要智能的地方,都配得上一整个推理大模型的开销。 对本地部署的人,这也是久违的一次门槛下移——决策小模型不用抢显卡,家里常驻机器加挂一个就行。边界已经画出来了:分类的活现在能接,打分的活还得再等等。小红书
(人群假设基于9月15日至22日微博、知乎、小红书、B站与GitHub公开信号的聚类,欢迎在评论区报你的场景和实测数字,下一轮拿数据对账。)