有人在 Hacker News 上做了个模拟器。选一块显卡,选一个模型,屏幕上的字就按那块卡跑起来的速度往外蹦——买卡之前,先看看它到底有多快。
发布者很认真,在评论区挨个问型号、问量化档位。结果评论区变成了反证现场。
有人拿 RTX 4090 跑 27B 的 Q4,外加投机解码,工具估二十几 token 每秒,他实测 80。RTX 5090 估 46,他跑到 60 到 70。最离谱的是一位还在用 2017 年两张老卡的,工具给不出数,他自述跑出 200 多。还有人选了 RTX 4080,工具弹出“跑不了”,他回:我这儿明明跑着。
86 条留言,偏差几乎全朝一个方向:实测比估计快,而且常常是两三倍。这些数字都是评论者自述,未必严谨,但方向太一致了,不像噪声。甬洁AI
漏掉的不是硬件参数。推理引擎用的是哪个构建版本,KV 缓存压到几位,投机解码开不开,多少层放 GPU、多少层留给 CPU,上下文开多长——这些没有一项在“显卡×模型”那张表里。
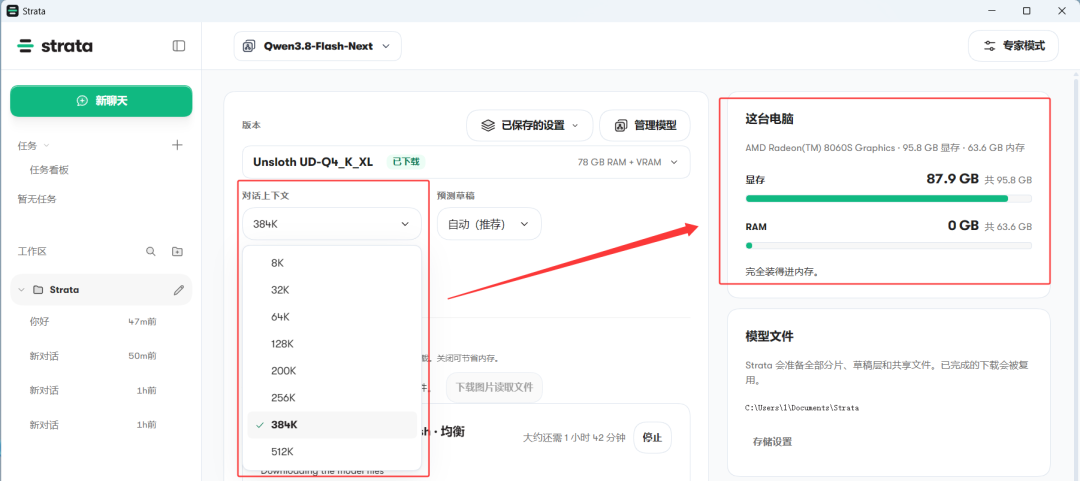
有人用专门为老架构编译的 llama.cpp 分支,把九年前的笔记本推到 13 万 token 上下文;有人把键缓存压到 4 位、值缓存压到 2 位;有人靠 n-gram 投机,把代码任务从 60 提到 100 以上。全是手艺,不是规格。
静态表还天生会过期。一个引擎能在两周里让同一块卡快一大截,表还没来得及更新。评论区有人说得客气:这些数字最多是某一时刻的快照。甬洁AI
速度到底由什么决定?有个式子解释得很干净:
Token/s = 内存带宽 ÷ 每个 token 读取的权重 × 每次前向确认的 token 数。
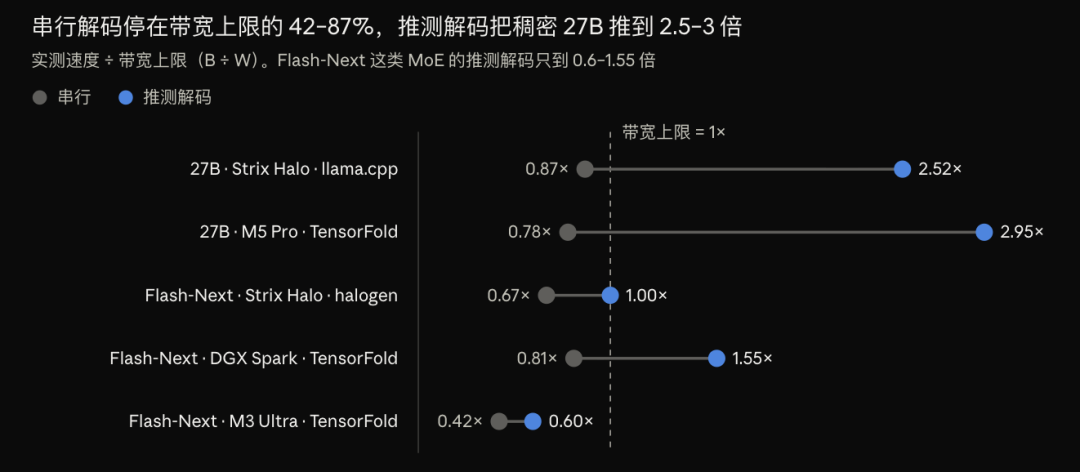
大模型每吐一个字,都要把用到的权重从内存完整读一遍。解码不看算力,看内存搬得有多快。一台基础款 M5,带宽约 153GB/s,Qwen3.5 9B 的权重约 5.2GB。153 除以 5.2,串行上限 29 token/s 左右。GPU 再强,内存供不上也白搭。愚者千虑知乎
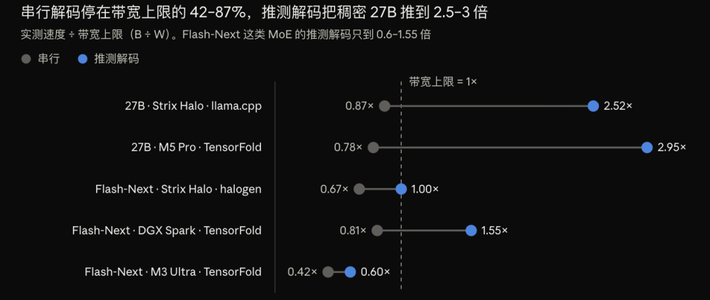
可同一台 M5 上,Uzu 引擎跑到了 92 token/s。它没换硬件,只是把式子的最后一项放大了:让一个小模型先猜后面一串 token,大模型一次验证,猜对了就整段收下。测试里,9B 模型每次验证平均接受 7.5 个 token。知乎
这就是最近本地推理提速的主要来源。翻回那个式子,其实只有三条路:换带宽更高的机器、让每个 token 少读点权重、一次多确认几个 token。
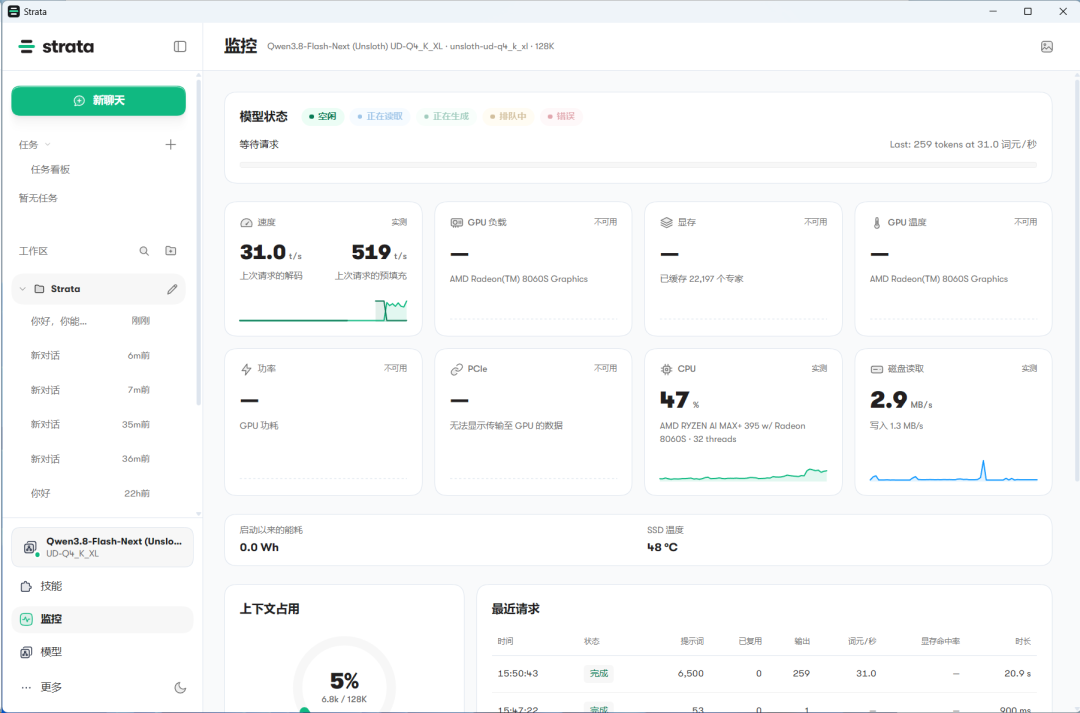
第二条路最近最热闹。MoE 模型每个 token 只走被路由到的少数专家。Qwen3.8-Flash-Next 总共 125B 参数,每 token 只激活 6B,4-bit 下只读 4.3GB;27B 的稠密模型每个 token 要读 14.4GB。同一台 Ryzen AI Max+ 395,从 27B 换到 Flash-Next,串行上限从 17 涨到 56 token/s。模型大了快五倍,反而更快。愚者千虑
显存装不下全部权重,也不等于跑不了。有位用户用 3080 10GB 加 32GB 内存,跑 127B 的 MoE 编程模型,65K 上下文下 40 到 50 token/s,比量化过的 27B 稠密模型还快。装不下的部分放内存、交给 CPU,只要每个 token 少读,就还有得赚。甬洁AI
投机解码的收益,稠密和 MoE 又不一样。稠密模型验证多行几乎不加钱——权重只读一遍,所有行共用;MoE 每多验证一行,都可能路由到新专家,每行多读一次。所以稠密模型配长草稿更划算,MoE 只适合短草稿。
把生成速度调明白了,很多人还是觉得卡。真正让你等的是预填充。
你贴进几千字代码,模型得先把这些内容读一遍,才吐第一个字。有人模拟 M4 Max 128GB、5687 token 的提示:31B 稠密模型首字延迟 36 秒,26B A4B 的 MoE 只要 4.7 秒。两者在“每秒多少 token”上可能差不多,体感差了近八倍。甬洁AI
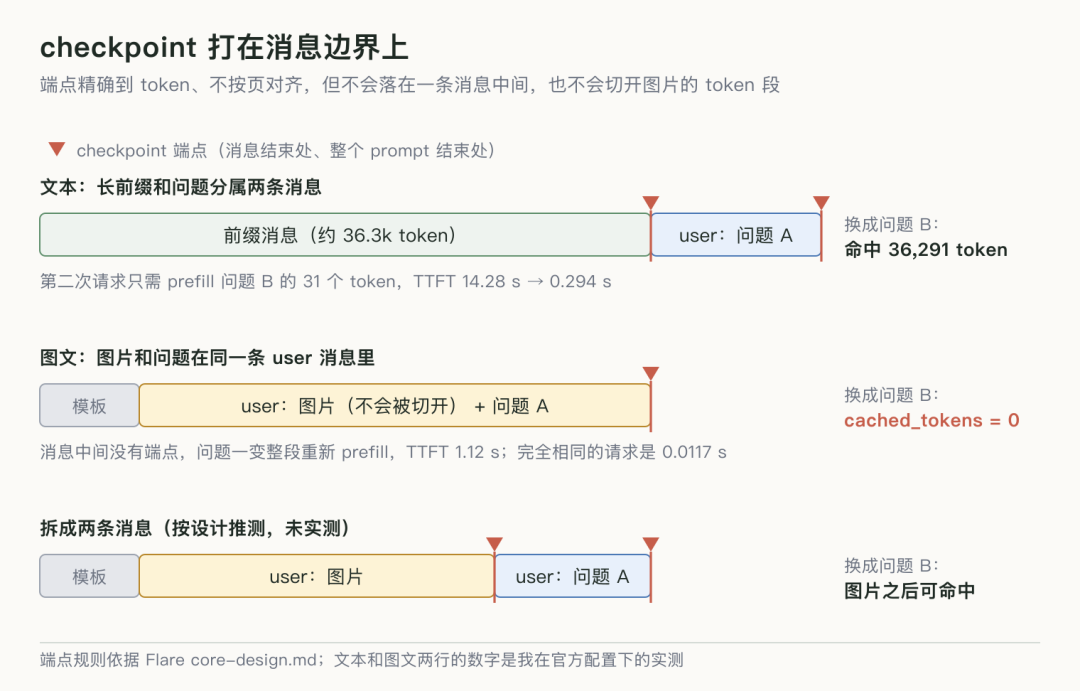
在公司用 vLLM 的人说得更直接:真实场景是 6 万到 14 万 token 的提示,解码吞吐通常只有跑分的一半到三分之一,重点早就变成了 KV 缓存管理和缓存命中的路由。
那张表默认展示的是生成速度,最该看的反而是它拆开的首字延迟。
回到开头那个模拟器。它真正有用的地方,不是预测你那张卡能跑多少,而是比较两个档位:4 位换 8 位,在我这台机器上只多 3 token/s,值不值。排序比绝对值可靠。甬洁AI
买硬件也一样。在本地推理这件事上,“跑不动”三个字基本没有可信度——把一部分层给 CPU、换个引擎、压一下 KV 缓存,能跑和不能跑之间隔着一大片手艺。真想试,花几块钱租一台,比看任何表都准。